

Aşırı öğrenme ve bias-variance
Önkoşul:Polinom regresyon
Kanca
- derste “yüksek derece = daha kötü” gördük, ama nedeni sayısal kararsızlıktı. Peki sayısal sorun olmasa bile, çok yüksek bir derece neden hâlâ kötü bir fikir? Ve “en iyi” derece nasıl belirlenir — deneme yanılma dışında bir yolu var mı?
Sezgi
Bir modelin veriye ne kadar iyi uyduğunu sadece eğitildiği veri üzerinde ölçersen, yanıltıcı bir resim elde edersin. Gerçek soru şu: model, daha önce hiç görmediği yeni verilerde nasıl performans gösterir? Bunu ölçmek için veriyi ikiye ayırırız: model eğitim verisiyle kurulur, sonra hiç görmediği test verisiyle sınanır.
eğitim noktası test noktası (model bunları hiç görmedi)
eğitim hatası test hatası
Derece 2 — eğitim MSE: 0.271, test MSE: 0.442. Model çok basit — hem eğitim hem test hatası yüksek (yüksek bias, yetersiz öğrenme).
Polinom derecesini değiştir: çok düşükken (1-2) hem eğitim hem test hatası yüksek kalır — model ilişkiyi yakalayacak kadar esnek değil, buna yetersiz öğrenme (yüksek bias) denir. Çok yüksekken, eğitim hatası küçülmeye devam eder ama test hatası fırlar — model artık gerçek örüntüyü değil, eğitim verisindeki gürültüyü ezberliyor, buna aşırı öğrenme (yüksek varyans) denir. İkisinin arasında bir “tatlı nokta” var.
Mekanizma
Gerçek verilerle, aynı fikri scikit-learn’le doğrulayalım. Önce veriyi eğitim ve test olarak ayıralım:
Eğitim/test ayrımı
# Gerçek ilişki dalgalı (sinüs benzeri) -- basit bir doğru veya tek bir parabol asla tam oturmaz.
n = 60
x = rng.uniform(-3, 3, n)
y = np.sin(1.3 * x) + 0.22 * x + rng.normal(0, 0.3, n)

x_egitim, x_test, y_egitim, y_test = train_test_split(x, y, test_size=0.3, random_state=21)
print(f"Eğitim seti: {len(x_egitim)} nokta, test seti: {len(x_test)} nokta")
Eğitim seti: 42 nokta, test seti: 18 noktaÇok düşük bir derece deneyelim:
Derece=1: yetersiz öğrenme
# Polinom sütunlarını (x, x², x³...) ölçekliyoruz: x¹⁶ gibi dev sayılar yan yana
# gelince en küçük kareler çözümü sayısal olarak bozulur (6. derste gördük).
def polinom_modeli(derece):
    return make_pipeline(PolynomialFeatures(degree=derece, include_bias=False), StandardScaler(), LinearRegression())

X_egitim, X_test = x_egitim.reshape(-1, 1), x_test.reshape(-1, 1)
model1 = polinom_modeli(1).fit(X_egitim, y_egitim)
mse1_egitim = mean_squared_error(y_egitim, model1.predict(X_egitim))
mse1_test = mean_squared_error(y_test, model1.predict(X_test))
print(f"Derece=1 -> eğitim MSE: {mse1_egitim:.3f}, test MSE: {mse1_test:.3f}")
print("İkisi de yüksek -- model dalgalı ilişkiyi hiç yakalayamıyor (yüksek bias).")
Derece=1 -> eğitim MSE: 0.524, test MSE: 0.433
İkisi de yüksek -- model dalgalı ilişkiyi hiç yakalayamıyor (yüksek bias).Hem eğitim (0.524) hem test (0.433) hatası yüksek — model henüz veriyi “anlamamış” bile. Şimdi çok yüksek bir derece deneyelim:
Derece=16: aşırı öğrenme
model16 = polinom_modeli(16).fit(X_egitim, y_egitim)
mse16_egitim = mean_squared_error(y_egitim, model16.predict(X_egitim))
mse16_test = mean_squared_error(y_test, model16.predict(X_test))
print(f"Derece=16 -> eğitim MSE: {mse16_egitim:.3f}, test MSE: {mse16_test:.3f}")
print(f"Eğitim hatası derece=1'in ~10'da biri, ama test hatası eğitimin {mse16_test / mse16_egitim:.0f} katı --")
print("model eğitim verisindeki gürültüyü ezberliyor.")
Derece=16 -> eğitim MSE: 0.049, test MSE: 1.619
Eğitim hatası derece=1'in ~10'da biri, ama test hatası eğitimin 33 katı --
model eğitim verisindeki gürültüyü ezberliyor.Eğitim hatası (0.049) derece=1’inkinin ~10’da birine iniyor — model eğitim noktalarına neredeyse yapışıyor. Ama test hatası (1.619) eğitim hatasının ~33 katı. (Polinom sütunlarını ölçeklemeyi unutma: x¹⁶ gibi dev sütunlar, 6. derste gördüğümüz sayısal kararsızlığı yaratır.) Çoğu kişi “aşırı öğrenme = eğitim verisinde mükemmel, sadece testte kötü” diye düşünür. Kısmen doğru, ama asıl belirleyici işaret eğitim ile test hatası arasındaki açılan fark — model, eğitim setine özgü rastgele gürültüyü “öğrenip” bunu genel bir kural sanıyor.
Matematik
Bias-variance ayrışımı (sezgisel)
| Terim | Anlamı |
|---|---|
| Bias (yanlılık) | Modelin, gerçek ilişkiyi ne kadar sistematik olarak kaçırdığı — çok basit bir model her zaman aynı şekilde yanılır |
| Varyans | Modelin, farklı eğitim setlerinde ne kadar farklı sonuçlar üreteceği — çok esnek bir model, verideki küçük değişikliklere aşırı duyarlıdır |
| İndirgenemez hata | Verideki doğal gürültü — hiçbir model bunu ortadan kaldıramaz |
Düşük dereceli model: yüksek bias (sistematik olarak yanlış), düşük varyans (hangi eğitim setini kullanırsan kullan, benzer -yanlış- sonuç). Yüksek dereceli model: düşük bias (esnek, veriye çok yakın), yüksek varyans (farklı bir eğitim seti, tamamen farklı bir eğri verir). En iyi derece, bias ve varyansın toplamının minimum olduğu noktadır — genelde her ikisi de sıfır olmaz.
Kod
Tüm dereceleri tek tek deneyip en iyisini bulalım:
En iyi dereceyi aramak
sonuclar = []
for derece in range(1, 17):
    model = polinom_modeli(derece).fit(X_egitim, y_egitim)
    sonuclar.append({
        "derece": derece,
        "egitim_mse": mean_squared_error(y_egitim, model.predict(X_egitim)),
        "test_mse": mean_squared_error(y_test, model.predict(X_test)),
    })

en_iyi = min(sonuclar, key=lambda s: s["test_mse"])
print(f"\nEn düşük test hatasını veren derece: {en_iyi['derece']}  (test MSE: {en_iyi['test_mse']:.3f})")
for s in sonuclar:
    isaret = "  <- en iyi" if s["derece"] == en_iyi["derece"] else ""
    print(f"derece={s['derece']:>2}  eğitim={s['egitim_mse']:.3f}  test={s['test_mse']:.3f}{isaret}")
En düşük test hatasını veren derece: 7  (test MSE: 0.077)
derece= 1  eğitim=0.524  test=0.433
derece= 2  eğitim=0.516  test=0.457
derece= 3  eğitim=0.109  test=0.102
derece= 4  eğitim=0.108  test=0.102
derece= 5  eğitim=0.071  test=0.087
derece= 6  eğitim=0.070  test=0.086
derece= 7  eğitim=0.067  test=0.077  <- en iyi
derece= 8  eğitim=0.065  test=0.097
derece= 9  eğitim=0.064  test=0.115
derece=10  eğitim=0.063  test=0.094
derece=11  eğitim=0.063  test=0.091
derece=12  eğitim=0.054  test=0.466
derece=13  eğitim=0.053  test=0.947
derece=14  eğitim=0.052  test=0.749
derece=15  eğitim=0.049  test=1.882
derece=16  eğitim=0.049  test=1.619
Derece 7, en düşük test hatasını (0.077) veriyor. Dikkat et: eğitim hatası derece arttıkça hep düşüyor (0.524’ten 0.049’a), ama test hatası derece 7’den sonra tekrar yükselmeye başlıyor ve 12’den sonra patlıyor — bu, aşırı öğrenmenin başladığı nokta.
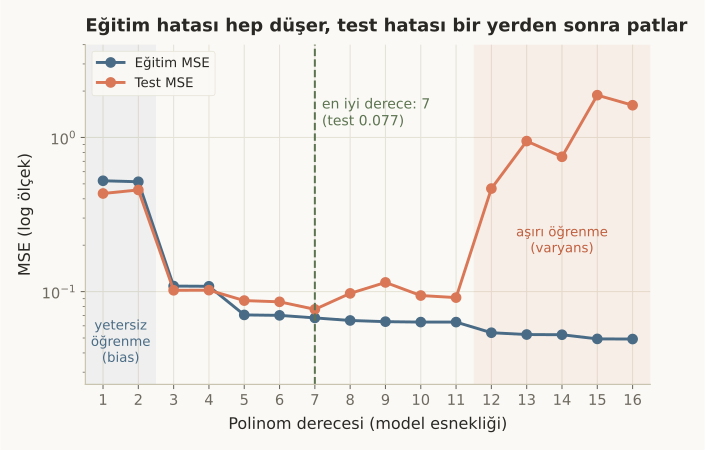 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bias-variance dengesi, makine öğrenmesinin neredeyse her modelinde karşına çıkar:
- Model karmaşıklığı seçimi. Derece, ağaç derinliği, sinir ağı katman sayısı gibi her “esneklik” parametresi bu dengeyi taşır.
- Eğitim/test ayrımının gerekçesi. Sadece eğitim hatasına bakmak seni yanıltır — bir sonraki derste (çapraz doğrulama) bu ayrımı daha sağlam hale getireceğiz.
- Erken durdurma sinyali. Birçok algoritmada (gradyan artırma, sinir ağları), eğitim ilerledikçe test hatasının ne zaman tekrar yükselmeye başladığını izlemek, durma noktasını belirler.
Bu 3 hatayı yaparsın:
- Modeli sadece eğitim hatasına bakarak seçmek — eğitim hatası her zaman “daha karmaşık = daha iyi” der, ama bu yanıltıcıdır.
- Test verisini modeli ayarlarken (derece seçerken) tekrar tekrar kullanmak — bu da bir tür gizli aşırı öğrenmedir (bu sorunun çözümü bir sonraki derste: çapraz doğrulama).
- “Aşırı öğrenme” ile “yetersiz öğrenme”yi karıştırmak — ikisi de kötü test performansına yol açar ama teşhisi (ve çözümü) tamamen farklıdır.
Kendini test et
1. Bir modelin eğitim hatası düşük ama test hatası yüksekse, bu neyin işaretidir?
- Yetersiz öğrenme (yüksek bias)
- Aşırı öğrenme (yüksek varyans) (doğru cevap)
- Model mükemmel çalışıyor
- Veri seti çok büyük
Neden: Eğitim ve test hatası arasındaki büyük fark, modelin eğitim verisine özgü gürültüyü ezberlediğinin (aşırı öğrenme, yüksek varyans) klasik işaretidir.
2. Bir model hem eğitim hem test verisinde yüksek hata veriyorsa, en olası açıklama nedir?
- Aşırı öğrenme
- Model çok karmaşık
- Yetersiz öğrenme (yüksek bias) -- model gerçek ilişkiyi yakalayacak kadar esnek değil (doğru cevap)
- Veri seti bölünmemiş
Neden: Model hem eğitim hem test verisinde başarısızsa, muhtemelen o modelin biçimi (örn. çok düşük dereceli bir polinom) gerçek ilişkiyi ifade etmeye yetmiyordur -- bu yüksek bias'tır.
3. Notebook'ta neden test hatası, derece 7'den sonra tekrar yükselmeye başladı?
- Kod hatalıydı
- Model, eğitim verisindeki rastgele gürültüye giderek daha fazla uymaya başladı, bu da genelleme (yeni veride) performansını kötüleştirdi (doğru cevap)
- Test verisi değişti
- scikit-learn bir sınır koyuyor
Neden: Derece arttıkça model daha esnek hale gelir ve eğitim verisindeki gürültüye bile uymaya başlar; bu gürültü test verisinde tekrarlanmadığı için test hatası yükselir -- bu aşırı öğrenmedir.
Özet
Özet
- Bir modeli sadece eğitim verisinde değerlendirmek yanıltıcıdır; test verisi (modelin hiç görmediği veri) gerçek performansı gösterir.
- Yetersiz öğrenme (yüksek bias): model çok basit, hem eğitim hem test hatası yüksek.
- Aşırı öğrenme (yüksek varyans): model çok esnek, eğitim hatası düşük ama test hatası yüksek.
- En iyi model karmaşıklığı, bias ile varyansın toplamını minimize eden noktadır.
- Eğitim ile test hatası arasındaki açılan fark, aşırı öğrenmenin en güvenilir işaretidir.