

Topluluk (ensemble) yöntemleri
Önkoşul:Entropi, Gini, bilgi kazancı
Kanca
18 dersttir hep tek bir model kuruyoruz. Ama 17. derste karar ağaçlarının veri setindeki küçük değişikliklere karşı kararsız olduğunu söylemiştik. Bu kararsızlığı bir sorun olarak değil, bir fırsat olarak kullanabilir miyiz?
Sezgi
Topluluk (ensemble) yöntemleri, birden fazla modelin tahminlerini birleştirerek, herhangi birinin tek başına yapacağından daha güvenilir bir sonuç elde eder. Fikir, gerçek hayattaki “kalabalığın bilgeliği” (wisdom of the crowds) prensibine benziyor: birçok kişinin (kısmen hatalı) tahminlerinin ortalaması, genelde tek bir kişinin tahmininden daha isabetlidir.
İki temel strateji var:
- Bagging (bootstrap aggregating): aynı algoritmanın birden fazla kopyasını, verinin farklı rastgele alt örneklemleriyle eğit, sonra oylarını topla.
- Oylama (voting): farklı algoritma türlerini (lojistik regresyon, ağaç, KNN gibi) aynı veriyle eğit, tahminlerini birleştir.
Mekanizma
Önce tek bir ağacın ne kadar “kararsız” olduğunu somut olarak görelim:
Müşteri verisi
n = 150
yas = rng.uniform(18, 65, n)
gelir = rng.uniform(3, 25, n)
skor = (yas - 40) / 15 + (gelir - 12) / 8 + rng.normal(0, 0.6, n)
satin_aldi = (skor > 0).astype(int)
X = np.column_stack([yas, gelir])
print(f"{n} müşteri, {satin_aldi.sum()} tanesi satın aldı")
150 müşteri, 95 tanesi satın aldıTek ağaçların kararsızlığı
# Aynı veriye, farklı bootstrap örneklemleriyle (yerine koyarak yeniden örnekleme) kurulan
# tek ağaçların ne kadar farklı kararlar verdiğini görelim.
agac_tahminleri = []
yeni_musteri = np.array([[45, 8]])
for tekrar in range(8):
    indeksler = rng.integers(0, n, n)  # bootstrap örneklem
    agac = DecisionTreeClassifier(max_depth=4, random_state=tekrar)
    agac.fit(X[indeksler], satin_aldi[indeksler])
    tahmin = agac.predict(yeni_musteri)[0]
    agac_tahminleri.append(tahmin)
    print(f"Ağaç {tekrar + 1} (farklı bootstrap örneklem): tahmin = {tahmin}")
print(f"\n8 farklı ağaç, aynı yeni müşteri için {len(set(agac_tahminleri))} farklı tahmin üretti -- tek bir ağaç kararsız.")
Ağaç 1 (farklı bootstrap örneklem): tahmin = 0
Ağaç 2 (farklı bootstrap örneklem): tahmin = 0
Ağaç 3 (farklı bootstrap örneklem): tahmin = 0
Ağaç 4 (farklı bootstrap örneklem): tahmin = 0
Ağaç 5 (farklı bootstrap örneklem): tahmin = 0
Ağaç 6 (farklı bootstrap örneklem): tahmin = 0
Ağaç 7 (farklı bootstrap örneklem): tahmin = 0
Ağaç 8 (farklı bootstrap örneklem): tahmin = 1
8 farklı ağaç, aynı yeni müşteri için 2 farklı tahmin üretti -- tek bir ağaç kararsız.Aynı temel veriye, sadece farklı bootstrap örneklemleriyle (rastgele, yerine koyarak yeniden örnekleme) kurulan 8 ağaç, aynı yeni müşteri için 2 farklı tahmin üretti! Şimdi bu “kararsız” ağaçların oylamasını deneyelim:
Bagging: oylamanın gücü
# Bu 8 "kararsız" ağacın çoğunluk oyunu alırsak ne olur? (Random Forest'ın temel fikri -- 20. derste detaylandıracağız)
cogunluk_oyu = int(np.round(np.mean(agac_tahminleri)))
print(f"8 ağacın çoğunluk oyu: {cogunluk_oyu}")

skor_tek_agac = cross_val_score(DecisionTreeClassifier(max_depth=4, random_state=0), X, satin_aldi, cv=5).mean()

from sklearn.ensemble import BaggingClassifier
skor_topluluk = cross_val_score(
    BaggingClassifier(DecisionTreeClassifier(max_depth=4), n_estimators=50, random_state=0),
    X, satin_aldi, cv=5,
).mean()
print(f"\nTek ağaç, çapraz doğrulama doğruluğu: {skor_tek_agac:.3f}")
print(f"50 ağacın topluluğu (bagging), çapraz doğrulama doğruluğu: {skor_topluluk:.3f}")
8 ağacın çoğunluk oyu: 0
Tek ağaç, çapraz doğrulama doğruluğu: 0.800
50 ağacın topluluğu (bagging), çapraz doğrulama doğruluğu: 0.83350 ağacın oylaması (bagging), tek bir ağaçtan (0.800) daha iyi bir çapraz doğrulama skoru (0.833) veriyor. Çoğu kişi “birden fazla model kurmak, sadece hesaplama maliyetini artırır, doğruluğu değil” sanır. Değil, çünkü her ağaç farklı bir bootstrap örneklemde eğitildiği için farklı hatalar yapar — bu hatalar birbirinden bağımsız olduğunda, çoğunluk oyu bu hataları “ortalayarak” iptal eder.
Matematik
Neden çoğunluk oyu işe yarar?
| Sembol | Anlamı |
|---|---|
| Topluluktaki model sayısı | |
| Her bir modelin (bağımsız) hata oranı | |
| Çoğunluğun da yanlış olma olasılığı |
Eğer her model rastgeleden biraz daha iyiyse () ve hataları birbirinden bağımsızsa, arttıkça çoğunluğun yanlış olma olasılığı hızla küçülür. Örneğin olan 11 bağımsız modelin çoğunluğu yanlış olma olasılığı ‘dan çok daha düşüktür. Bağımsızlık kritik varsayımdır — modeller birbirine çok benzer hatalar yaparsa (örn. aynı veri, aynı algoritma, hiç çeşitlilik yok), bu avantaj kaybolur.
Kod
Topluluklar, aynı algoritmanın kopyalarıyla sınırlı değil — farklı algoritma türlerini de birleştirebiliriz:
Farklı model türlerinin oylaması
# Topluluk sadece aynı algoritmanın kopyalarıyla değil, farklı algoritma türleriyle de kurulabilir.
lojistik = LogisticRegression()
agac = DecisionTreeClassifier(max_depth=4, random_state=0)
knn = KNeighborsClassifier(n_neighbors=7)

for isim, model in [("Lojistik regresyon", lojistik), ("Karar ağacı", agac), ("KNN", knn)]:
    skor = cross_val_score(model, X, satin_aldi, cv=5).mean()
    print(f"{isim:<20} tek başına: {skor:.3f}")

oy_birligi = VotingClassifier(estimators=[("lr", lojistik), ("dt", agac), ("knn", knn)], voting="hard")
skor_oy_birligi = cross_val_score(oy_birligi, X, satin_aldi, cv=5).mean()
print(f"{'Üç modelin oylaması':<20} : {skor_oy_birligi:.3f}")
print("Oylama, en zayıf modeli (karar ağacı) belirgin şekilde geride bırakıyor ama en güçlü modeli")
print("(lojistik regresyon) geçemiyor -- topluluk 'en iyi tek modeli her zaman yener' garantisi vermez,")
print("asıl faydası hangi modelin en iyi olacağını önceden bilmeden dengeli/dayanıklı bir sonuç almaktır.")
Lojistik regresyon tek başına: 0.887
Karar ağacı tek başına: 0.800
KNN tek başına: 0.860
Üç modelin oylaması : 0.853
Oylama, en zayıf modeli (karar ağacı) belirgin şekilde geride bırakıyor ama en güçlü modeli
(lojistik regresyon) geçemiyor -- topluluk 'en iyi tek modeli her zaman yener' garantisi vermez,
asıl faydası hangi modelin en iyi olacağını önceden bilmeden dengeli/dayanıklı bir sonuç almaktır.Dikkat çekici bir nüans: oylama (0.853), en zayıf modeli (karar ağacı, 0.800) belirgin şekilde geride bırakıyor ama en güçlü modeli (lojistik regresyon, 0.887) geçemiyor. Topluluğun asıl faydası “her zaman en iyi tek modeli yenmek” değil — hangi modelin en iyi olacağını önceden bilmeden, dengeli ve güvenilir bir sonuç almaktır.
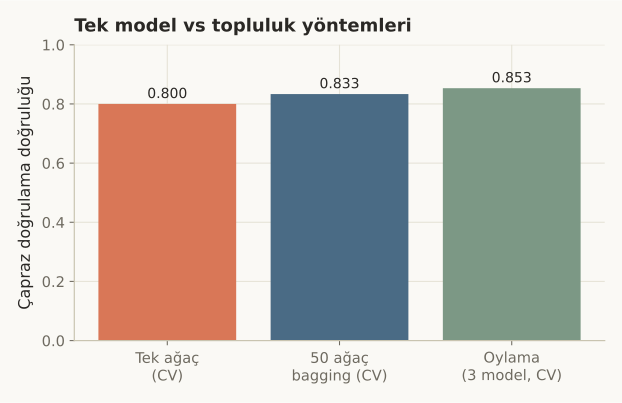 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Topluluk yöntemleri, modern makine öğrenmesinin en güçlü ve en yaygın kullanılan araçlarından biridir:
- Kararsız (yüksek varyanslı) modellerde en etkili. Karar ağaçları gibi veri değişikliklerine duyarlı modeller, bagging’den en çok fayda gören modellerdir (20. derste Random Forest’ta detaylandıracağız).
- Yarışma çözümlerinin standart bileşeni. Kaggle gibi platformlardaki kazanan çözümlerin büyük çoğunluğu, bir şekilde topluluk yöntemi kullanır.
- Belirsizliği azaltmak istediğinde. Tek bir modelin tahminine “ne kadar güvenmeli” sorusuna, topluluktaki modellerin anlaşma derecesi de bir ipucu verebilir.
Bu 3 hatayı yaparsın:
- Topluluğun “her zaman en iyi tek modelden daha iyi olacağını” varsaymak — bu derste gördüğümüz gibi garanti değil.
- Çok benzer modelleri bir araya getirmek — bağımsızlık/çeşitlilik olmadan, topluluğun avantajı büyük ölçüde kaybolur.
- Hesaplama maliyetini göz ardı etmek — 50 model eğitmek, 1 model eğitmekten çok daha pahalıdır; kazanç bu maliyete değip değmediğini düşünmek gerekir.
Kendini test et
1. Bagging (bootstrap aggregating) temel olarak ne yapar?
- Tek bir modeli daha uzun süre eğitir
- Aynı algoritmanın birden fazla kopyasını, verinin farklı rastgele alt örneklemleriyle eğitip tahminlerini birleştirir (doğru cevap)
- Sadece en iyi modeli seçer, diğerlerini atar
- Veriyi küçültür
Neden: Bagging, aynı algoritmayı farklı bootstrap (rastgele, yerine koyarak) örneklemlerle birden fazla kez eğitir, sonra bu modellerin tahminlerini (oylarını) birleştirir.
2. Notebook'ta 8 farklı ağacın aynı yeni müşteri için 2 farklı tahmin üretmesi neyi gösteriyor?
- Kod hatalıydı
- Tek bir karar ağacı, veri setindeki küçük değişikliklere (farklı bootstrap örneklemlere) karşı kararsızdır (doğru cevap)
- Veri seti çok küçüktü
- Ağaçlar birbirinden bağımsız değil
Neden: Karar ağaçları, 17. derste de değindiğimiz gibi, eğitim verisindeki küçük değişikliklere karşı yüksek varyanslıdır -- bu yüzden farklı bootstrap örneklemler farklı ağaç yapıları ve farklı tahminler üretebilir.
3. Notebook'ta 3 farklı modelin oylaması (0.853), en güçlü tek modeli (lojistik regresyon, 0.887) neden geçemedi?
- Oylama her zaman en kötü sonucu verir
- Topluluk yöntemleri 'her zaman en iyi tek modeli yenmek' garantisi vermez -- asıl faydası, hangi modelin en iyi olacağını önceden bilmeden dengeli bir sonuç almaktır (doğru cevap)
- Kod hatalıydı
- Lojistik regresyon her zaman en iyisidir
Neden: Oylama, zayıf modellerin hatalarını dengeleyerek genel bir sağlamlık sağlar, ama eğer bir model gerçekten çok daha güçlüyse, o modelin gücü diğerlerinin ortalamasıyla 'seyreltilebilir'.
Özet
Özet
- Topluluk yöntemleri, birden fazla modelin tahminlerini birleştirerek tek bir modelden daha güvenilir sonuçlar elde etmeye çalışır.
- Bagging, aynı algoritmayı farklı bootstrap örneklemlerle eğitip oylarını birleştirir.
- Oylama (voting), farklı algoritma türlerinin tahminlerini birleştirir.
- Topluluğun avantajı, modellerin hatalarının birbirinden bağımsız olmasına dayanır.
- Topluluk, en zayıf modeli geride bırakabilir ama en güçlü tek modeli her zaman geçeceği garanti edilemez.