

LSTM ve GRU
Önkoşul:RNN
Kanca
- derste RNN’in sıraya duyarlı olduğunu gördük — güzel. Ama UZUN dizilerde RNN’in gizli bir sorunu var: 5. DL Vision dersindeki kaybolan gradyanın, zaman İÇİNDEKİ hâli. LSTM ve GRU, bu soruna cevap.
Sezgi
LSTM, RNN’in gizli durumuna EK olarak, bir “hücre durumu” (cell state) taşır — bu, bilginin uzun mesafelerde ÇOK DAHA AZ bozularak akmasını sağlayan ayrı bir “otoyol”. Bu fikir, 31. DL Vision dersindeki ResNet’in atlama bağlantısıyla ŞAŞIRTICI derecede benzer.
Mekanizma
Önce 6. dersteki RNN’i UZUN bir dizide test edelim:
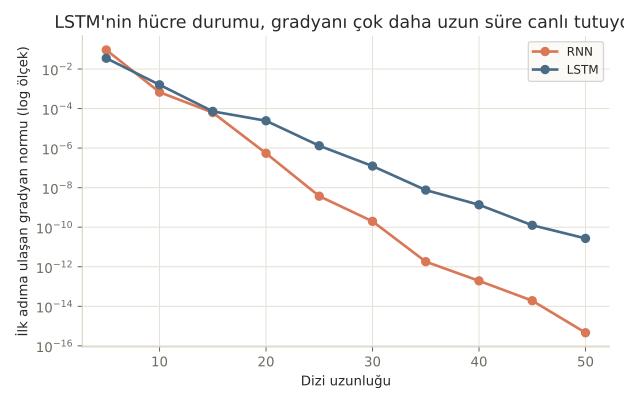
RNN, uzun dizide gradyanı kaybediyor
# 6. derste RNN'in sıraya duyarlı olduğunu gördük -- ama UZUN dizilerde ciddi bir
# sorunu var: 5. DL Vision dersindeki kaybolan gradyanın AYNISI, zaman İÇİNDE.
BOYUT = 8

def gradyan_olc(katman_sinifi, uzunluk, **kwargs):
    torch.manual_seed(42)  # HER çağrıda AYNI ilklendirme -- sonuçlar tekrar üretilebilir olsun
    katman = katman_sinifi(input_size=BOYUT, hidden_size=BOYUT, batch_first=True, **kwargs)
    dizi = torch.randn(1, uzunluk, BOYUT, requires_grad=True)
    if katman_sinifi is nn.LSTM:
        cikis, _ = katman(dizi)
    else:
        cikis, _ = katman(dizi)
    kayip = cikis[0, -1].sum()  # SADECE son adımın kaybı
    kayip.backward()
    return dizi.grad[0, 0].norm().item()  # İLK adımın girdisine ulaşan gradyan normu

print(f"{'Dizi uzunluğu':<16} {'RNN ilk-adım gradyanı':<24}")
for uzunluk in [10, 30, 50]:
    rnn_grad = gradyan_olc(nn.RNN, uzunluk)
    print(f"{uzunluk:<16} {rnn_grad:<24.3e}")
print("\n50 adımlık bir dizide, gradyan ilk kelimeye ULAŞTIĞINDA neredeyse SIFIR -- ağ, dizinin")
print("BAŞINDAKİ bilgiyi 'unutmaya' zorlanıyor. Bu, uzun cümlelerde ciddi bir sorun.")
Dizi uzunluğu RNN ilk-adım gradyanı
10 6.705e-04
30 1.973e-10
50 4.613e-16
50 adımlık bir dizide, gradyan ilk kelimeye ULAŞTIĞINDA neredeyse SIFIR -- ağ, dizinin
BAŞINDAKİ bilgiyi 'unutmaya' zorlanıyor. Bu, uzun cümlelerde ciddi bir sorun.50 adımlık bir dizide, gradyan dizinin BAŞINA ulaştığında 4.6e-16 — pratikte SIFIR. Şimdi LSTM ile karşılaştıralım:
LSTM, hücre durumuyla gradyanı koruyor
# LSTM (Long Short-Term Memory), AYRI bir "hücre durumu" (cell state) ekler --
# bu, 31. DL Vision dersindeki ResNet'in atlama bağlantısına ÇOK benzer bir fikir.
print(f"\n{'Dizi uzunluğu':<16} {'RNN gradyanı':<16} {'LSTM gradyanı':<16} {'Oran (LSTM/RNN)':<16}")
en_yuksek_oran = 0
for uzunluk in [10, 30, 50]:
    rnn_grad = gradyan_olc(nn.RNN, uzunluk)
    lstm_grad = gradyan_olc(nn.LSTM, uzunluk)
    oran = lstm_grad / rnn_grad
    en_yuksek_oran = max(en_yuksek_oran, oran)
    print(f"{uzunluk:<16} {rnn_grad:<16.3e} {lstm_grad:<16.3e} {oran:<16.1f}")

print(f"\nUzun dizilerde LSTM'nin gradyanı, RNN'inkinden BİNLERCE-ON BİNLERCE kat büyük olabiliyor")
print(f"(bu çalıştırmada en yüksek oran: {en_yuksek_oran:.0f}x). Çoğu kişi 'LSTM sadece biraz daha")
print("karmaşık bir RNN' sanır. **Yanlış, çünkü** hücre durumu, 31. dersteki")
print("'y = x + f(x)' fikriyle AYNI mantıkla, gradyanın zaman içinde SÖNMEDEN akmasını sağlıyor.")
Dizi uzunluğu    RNN gradyanı     LSTM gradyanı    Oran (LSTM/RNN)
10               6.705e-04        1.583e-03        2.4
30               1.973e-10        1.231e-07        623.8
50               4.613e-16        2.711e-11        58759.3

Uzun dizilerde LSTM'nin gradyanı, RNN'inkinden BİNLERCE-ON BİNLERCE kat büyük olabiliyor
(bu çalıştırmada en yüksek oran: 58759x). Çoğu kişi 'LSTM sadece biraz daha
karmaşık bir RNN' sanır. **Yanlış, çünkü** hücre durumu, 31. dersteki
'y = x + f(x)' fikriyle AYNI mantıkla, gradyanın zaman içinde SÖNMEDEN akmasını sağlıyor.
50 adımda LSTM’nin gradyanı, RNN’inkinden 58.759 KAT büyük! Çoğu kişi “LSTM sadece biraz daha karmaşık bir RNN” sanır. Yanlış, çünkü hücre durumu, DL Görüntü kategorisinin 31. dersindeki “y = x + f(x)” fikriyle AYNI mantıkla, gradyanın zaman içinde SÖNMEDEN akmasını garantiliyor.
Matematik
LSTM'in kapıları (basitleştirilmiş)
| Sembol | Anlamı |
|---|---|
| Hücre durumu — bilginin AKTIĞI ana “otoyol” | |
| (forget gate) | “Unutma kapısı” — geçmişten NE KADARININ tutulacağını belirler (0-1 arası) |
| (input gate) | “Giriş kapısı” — yeni bilgiden NE KADARININ ekleneceğini belirler |
| (output gate) | “Çıkış kapısı” — hücre durumunun NE KADARININ gizli duruma yansıyacağını belirler |
formülündeki terimi, ResNet’teki "" (kimlik/identity) terimiyle AYNI rolü oynar: gradyanın doğrudan geçebileceği bir yol.
Kod
GRU’yu (LSTM’in daha sade bir versiyonu) da karşılaştıralım:
GRU: daha az kapı, daha az parametre
# GRU (Gated Recurrent Unit), LSTM'in DAHA BASİT bir versiyonu -- daha az kapı, daha az parametre.
print(f"\n{'Dizi uzunluğu':<16} {'RNN':<12} {'GRU':<12} {'LSTM':<12}")
for uzunluk in [10, 30, 50]:
    rnn_grad = gradyan_olc(nn.RNN, uzunluk)
    gru_grad = gradyan_olc(nn.GRU, uzunluk)
    lstm_grad = gradyan_olc(nn.LSTM, uzunluk)
    print(f"{uzunluk:<16} {rnn_grad:<12.2e} {gru_grad:<12.2e} {lstm_grad:<12.2e}")

rnn_p = sum(p.numel() for p in nn.RNN(BOYUT, BOYUT, batch_first=True).parameters())
gru_p = sum(p.numel() for p in nn.GRU(BOYUT, BOYUT, batch_first=True).parameters())
lstm_p = sum(p.numel() for p in nn.LSTM(BOYUT, BOYUT, batch_first=True).parameters())
print(f"\nParametre sayısı (hidden=8): RNN={rnn_p}, GRU={gru_p} (RNN'in {gru_p//rnn_p}x'i), LSTM={lstm_p} (RNN'in {lstm_p//rnn_p}x'i)")
print("GRU'nun 3 kapısı, LSTM'in 4 kapısı var -- parametre sayısı TAM OLARAK bu kapı sayısıyla orantılı.")
print("GRU, LSTM'e YAKIN bir gradyan akışı sağlarken daha AZ parametre kullanıyor -- pratikte")
print("ikisi de 'düz' RNN'den çok daha iyi, aralarındaki seçim genelde DENEYSEL.")
Dizi uzunluğu    RNN          GRU          LSTM
10               6.70e-04     1.03e-02     1.58e-03
30               1.97e-10     1.59e-08     1.23e-07
50               4.61e-16     3.36e-12     2.71e-11

Parametre sayısı (hidden=8): RNN=144, GRU=432 (RNN'in 3x'i), LSTM=576 (RNN'in 4x'i)
GRU'nun 3 kapısı, LSTM'in 4 kapısı var -- parametre sayısı TAM OLARAK bu kapı sayısıyla orantılı.
GRU, LSTM'e YAKIN bir gradyan akışı sağlarken daha AZ parametre kullanıyor -- pratikte
ikisi de 'düz' RNN'den çok daha iyi, aralarındaki seçim genelde DENEYSEL.
GRU’nun 3 kapısı, LSTM’in 4 kapısı var — parametre sayısı (432 vs 576) TAM OLARAK bu kapı sayısıyla orantılı (RNN’in 3 ve 4 katı).
Nerede işe yarar
LSTM ve GRU, 2015-2017 arası NLP’nin baskın mimarileriydi (transformer’lar öncesi):
- LSTM, daha GÜÇLÜ ama daha YAVAŞ (4 kapı = daha çok hesaplama).
- GRU, daha HIZLI ama biraz daha AZ ifade gücüne sahip (3 kapı).
- İkisi de, 9-10. derste göreceğimiz attention mekanizması ÖNCESİ, “uzun mesafeli bağımlılık” sorununa en iyi çözümdü — ama 8. derste, bu çözümün de kendi sınırları olduğunu göreceğiz.
Bu 3 hatayı yaparsın:
- LSTM’in kaybolan gradyanı TAMAMEN çözdüğünü sanmak — notebook’ta LSTM’nin gradyanı da UZUN vadede küçülüyor, sadece ÇOK daha yavaş.
- GRU ile LSTM arasındaki seçimi “her zaman biri daha iyi” diye genellemek — pratikte İKİSİ de denenir, veri setine göre değişir.
- Kapı mekanizmalarını “gizemli” sanmak — özünde her kapı, 0-1 arası bir sayı üreten bir sigmoid katmanı, “ne kadar geçsin” sorusuna cevap veriyor.
Kendini test et
1. Notebook'ta 50 adımlık bir dizide LSTM'nin gradyanı, RNN'inkinden neden 58.759 kat daha büyük çıktı?
- Kod hatalıydı
- LSTM'in hücre durumu, forget gate ile ölçeklenen bir 'kimlik' terimi (f_t ⊙ c_{t-1}) içerir -- bu, DL Görüntü kategorisinin 31. dersindeki ResNet'in atlama bağlantısıyla aynı mantıkla gradyanın sönmeden akmasını sağlar (doğru cevap)
- LSTM daha fazla parametre kullandığı için
- RNN gradyanı hiç hesaplamıyor
Neden: Hücre durumu güncellemesindeki f_t ⊙ c_{t-1} terimi, gradyanın çarpımsal olarak küçülmesi yerine ADDİTİF bir yoldan geçmesini sağlar -- tıpkı ResNet'in y=x+f(x)'indeki 'x' teriminin yaptığı gibi.
2. GRU'nun parametre sayısı (432), RNN'in parametre sayısının (144) neden tam olarak 3 katı çıktı?
- Rastgele bir sonuç
- GRU'nun 3 kapısı (update, reset, ve yeni aday durum) var -- her kapı, RNN'inkiyle aynı boyutta ayrı bir ağırlık kümesi gerektirir, bu da parametre sayısını kapı sayısıyla orantılı yapar (doğru cevap)
- GRU her zaman 3 kat daha yavaştır
- Bu bir yuvarlama hatasıdır
Neden: GRU, RNN'in TEK dönüşümü yerine 3 farklı kapı/dönüşüm hesaplar; her biri RNN'inkiyle aynı boyutta bir ağırlık matrisi gerektirdiği için toplam parametre sayısı yaklaşık 3 katına çıkar (LSTM'de 4 kapı olduğu için 4 kat).
3. LSTM'in kaybolan gradyan sorununu TAMAMEN mi yoksa KISMEN mi çözdüğü konusunda notebook ne gösteriyor?
- Tamamen çözüyor, LSTM'de gradyan asla küçülmez
- Kısmen çözüyor -- LSTM'nin gradyanı da uzun vadede küçülür, ama RNN'inkinden ÇOK daha yavaş küçülür (doğru cevap)
- Hiç çözmüyor, LSTM ile RNN aynı performansı gösterir
- Bu soru notebook'ta test edilmedi
Neden: Notebook'ta LSTM'nin gradyanı da uzunluk arttıkça küçülüyor (50 adımda 2.7e-11'e iniyor) -- ama RNN'inkinden (4.6e-16) çok daha yavaş küçülüyor. Bu KISMİ bir iyileştirmedir, mükemmel bir çözüm değil.
Özet
Özet
- RNN, uzun dizilerde 5. DL Vision dersindeki kaybolan gradyan sorununu zaman içinde yaşar.
- LSTM, ayrı bir hücre durumu (cell state) ekleyerek, ResNet'in atlama bağlantısına benzer bir mantıkla gradyan akışını korur.
- Forget/input/output kapıları, hücre durumuna ne kadar bilginin girip çıkacağını 0-1 arası öğrenilebilir değerlerle kontrol eder.
- GRU, LSTM'in daha az kapılı (3 vs 4), daha az parametreli bir versiyonudur.
- LSTM/GRU, kaybolan gradyanı TAMAMEN değil, büyük ölçüde AZALTIR -- 8. derste bu kısmi çözümün sınırlarını göreceğiz.