

Adam
Önkoşul:RMSprop ve Adadelta
Kanca
15-17. derste momentum (gürültüyü yumuşatan “hız”) ve RMSprop (kararlı bir uyarlanabilir öğrenme oranı) fikirlerini ayrı ayrı gördük. Adam, bu ikisini birleştiren ve bugün en yaygın kullanılan optimizer.
Sezgi
Adam, her ağırlık için iki ayrı hafıza tutar: gradyanın kendisinin ortalaması (momentum gibi) ve gradyanın karesinin ortalaması (RMSprop gibi). Ama bu iki hafıza sıfırdan başladığı için, ilk birkaç adımda “gerçek” değerlerinden sistematik olarak küçük kalırlar — Adam’ın en önemli (ve çoğu kişinin bilmediği) detayı bu sapmayı düzeltmesidir.
Optimizer yarışında Adam’ı (mor) izle — hem vadi hem eyer noktası senaryosunda genelde hızlı ve kararlı davranıyor.
Adım: 0
SGD'nin dar vadide nasıl zigzag çizdiğine, momentumun ise bu salınımı nasıl yumuşatıp hızlandırdığına dikkat et.
Mekanizma
Adam’ı, bias düzeltmesi olmadan uygularsak ne olur?
Adam, bias düzeltmesi olmadan
# Adam = Momentum (15. ders) fikri + RMSprop (17. ders) fikri birleştirilmiş.
# m: gradyanın üstel ortalaması (momentum'daki "hız" gibi)
# v: gradyan karesinin üstel ortalaması (RMSprop'taki "cache" gibi)
# Deney: basit bir vadi, L(w) = w²/2 (minimum w=0'da, gradyan g = w). Başlangıç w=5, lr=0.3.
# lr=0.3 demek: Adam'ın her adımı ~0.3 büyüklüğünde olmalı.
def adam_duzeltmesiz(adim_sayisi, lr=0.3, b1=0.9, b2=0.999):
    w, m, v = 5.0, 0.0, 0.0
    yol, adimlar = [w], []
    for t in range(1, adim_sayisi + 1):
        g = w  # L = w²/2 -> dL/dw = w
        m = b1 * m + (1 - b1) * g
        v = b2 * v + (1 - b2) * g ** 2
        adim = lr * m / (np.sqrt(v) + 1e-8)
        w -= adim
        yol.append(w)
        adimlar.append(adim)
    return yol, adimlar

yol_duzeltmesiz, adimlar_duzeltmesiz = adam_duzeltmesiz(30)
print("Bias düzeltmesi olmadan Adam, ilk 5 adımın büyüklüğü (hedef ~0.3):")
print("  " + ", ".join(f"{a:.2f}" for a in adimlar_duzeltmesiz[:5]))
print(f"\nw, minimumu (0) {np.argmax(np.array(yol_duzeltmesiz) < 0)}. adımda geçip {min(yol_duzeltmesiz):.2f} değerine kadar karşı tarafa savruluyor.")
Bias düzeltmesi olmadan Adam, ilk 5 adımın büyüklüğü (hedef ~0.3):
0.95, 1.26, 1.42, 1.44, 1.28
w, minimumu (0) 4. adımda geçip -2.97 değerine kadar karşı tarafa savruluyor.lr=0.3 seçtik, yani adımlar ~0.3 büyüklüğünde olmalı. Ama ilk adımlar 0.95, 1.26, 1.42… — 3-5 kat büyük. w, minimumu (0) 4. adımda geçip -2.97’ye kadar karşı tarafa savruluyor. Şimdi tek satırlık bir düzeltme ekleyelim:
Adam, bias düzeltmesiyle
# Sorun: m ve v, sıfırdan başlıyor -- ilk adımlarda gerçek değerlerinden çok küçük kalıyorlar.
# Adam, bunu (1 - beta^t) ile bölerek düzeltir -- "bias correction".
def adam_duzeltmeli(adim_sayisi, lr=0.3, b1=0.9, b2=0.999):
    w, m, v = 5.0, 0.0, 0.0
    yol, adimlar = [w], []
    for t in range(1, adim_sayisi + 1):
        g = w
        m = b1 * m + (1 - b1) * g
        v = b2 * v + (1 - b2) * g ** 2
        m_hat = m / (1 - b1 ** t)
        v_hat = v / (1 - b2 ** t)
        adim = lr * m_hat / (np.sqrt(v_hat) + 1e-8)
        w -= adim
        yol.append(w)
        adimlar.append(adim)
    return yol, adimlar

yol_duzeltmeli, adimlar_duzeltmeli = adam_duzeltmeli(30)
print("Bias düzeltmesi ile Adam, ilk 5 adımın büyüklüğü (hedef ~0.3):")
print("  " + ", ".join(f"{a:.2f}" for a in adimlar_duzeltmeli[:5]))
print("\nw, ~0.3'lük adımlarla minimuma iniyor ve onun etrafında küçük salınımlarla kalıyor.")
print("Fark sadece (1-beta^t) ile bölme -- ama ilk adımlar 3-5 kat büyükten, tam olması gereken boyuta iniyor.")
Bias düzeltmesi ile Adam, ilk 5 adımın büyüklüğü (hedef ~0.3):
0.30, 0.30, 0.30, 0.30, 0.29
w, ~0.3'lük adımlarla minimuma iniyor ve onun etrafında küçük salınımlarla kalıyor.
Fark sadece (1-beta^t) ile bölme -- ama ilk adımlar 3-5 kat büyükten, tam olması gereken boyuta iniyor.Aynı ayarlarla, aynı vadide, adımlar artık tam 0.30 ve iniş düzgün. Çoğu kişi “küçük bir matematiksel detay, önemli olamaz” sanır. Yanlış, çünkü bu tek terim, eğitimin en kırılgan anında — ilk adımlarda — adımların planlanandan kat kat büyük olmasını engelliyor. Bu oyuncak vadide sadece savrulma görüyoruz; gerçek bir ağda bu kadar büyük ilk adımlar eğitimi kararsızlaştırıp ıraksatabilir (Kingma ve Ba, 2015).
Matematik
Adam güncelleme kuralı
| Sembol | Anlamı |
|---|---|
| Birinci moment — gradyanın kendisinin üstel ortalaması (momentum, 15. ders) | |
| İkinci moment — gradyan karesinin üstel ortalaması (RMSprop, 17. ders) | |
| Bias-düzeltilmiş versiyonlar — ‘ye bölünerek erken adımlardaki küçük-kalma sorunu giderilir |
büyüdükçe , yani — düzeltme yalnızca ilk adımlarda etkili, sonra otomatik olarak “kapanır”.
Kod
Neden özellikle ilk adım bu kadar riskli? ‘nin başlangıçtaki değerine bakalım:
t=1'de v neden çok küçük?
# İlk adımda (t=1) m ve v'nin düzeltmesiz ve düzeltmeli hâllerini karşılaştıralım (g = 1 için).
b1, b2 = 0.9, 0.999
g = 1.0
m_ham, v_ham = (1 - b1) * g, (1 - b2) * g ** 2
m_hat, v_hat = m_ham / (1 - b1), v_ham / (1 - b2)
print(f"t=1'de m = {m_ham:.3f}  (gerçek değerin {g / m_ham:.0f} katı küçük)   ->  düzeltmeli m_hat = {m_hat:.3f}")
print(f"t=1'de v = {v_ham:.5f}  (gerçek değerin {g ** 2 / v_ham:.0f} katı küçük) ->  düzeltmeli v_hat = {v_hat:.3f}")
print(f"\nAdım ∝ m/√v: düzeltmesiz {m_ham / np.sqrt(v_ham):.2f}, düzeltmeli {m_hat / np.sqrt(v_hat):.2f}")
print("m 10 kat küçük ama √v ~32 kat küçük: payda (√v) paydan (m) daha çok küçüldüğü için adım ~3 kat büyüyor.")
t=1'de m = 0.100 (gerçek değerin 10 katı küçük) -> düzeltmeli m_hat = 1.000
t=1'de v = 0.00100 (gerçek değerin 1000 katı küçük) -> düzeltmeli v_hat = 1.000
Adım ∝ m/√v: düzeltmesiz 3.16, düzeltmeli 1.00
m 10 kat küçük ama √v ~32 kat küçük: payda (√v) paydan (m) daha çok küçüldüğü için adım ~3 kat büyüyor.t=1’de düzeltmesiz gerçek değerinin 10 katı, ise 1000 katı küçük. Adım ile orantılı: 10 kat küçülürken ~32 kat küçüldüğü için adım ~3 kat büyüyor. Düzeltme, ikisini de gerçek değerine (1.0) taşıyor.
PyTorch ile doğrulama
# PyTorch'un torch.optim.Adam'ı, bias düzeltmesini içinde otomatik yapar.
w_t = torch.tensor(5.0, requires_grad=True)
optimizer = torch.optim.Adam([w_t], lr=0.3, betas=(0.9, 0.999))
for t in range(30):
    optimizer.zero_grad()
    kayip = w_t ** 2 / 2
    kayip.backward()
    optimizer.step()
print(f"\nPyTorch Adam, 30 adım sonra: w={w_t.item():.4f}")
print(f"Elle yazdığımız (düzeltmeli) Adam: w={yol_duzeltmeli[-1]:.4f}  -- birebir aynı.")
PyTorch Adam, 30 adım sonra: w=-0.8329
Elle yazdığımız (düzeltmeli) Adam: w=-0.8329  -- birebir aynı.
PyTorch’un torch.optim.Adam’ı bu düzeltmeyi otomatik yapar — sonuç (w=-0.8329) elle yazdığımız versiyonla birebir aynı.
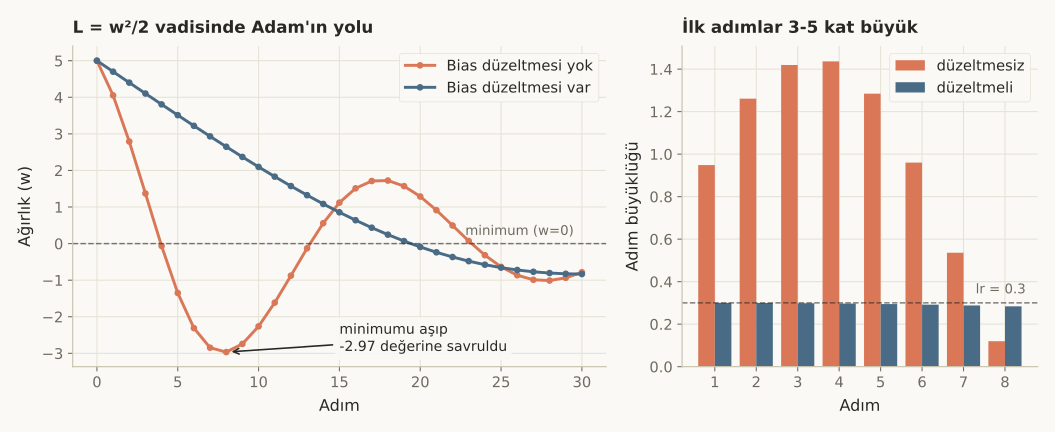 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Adam, günümüzde derin öğrenmenin varsayılan optimizer’ıdır:
- Çoğu modern model (transformer’lar dahil, NLP kategorisinde göreceğiz) Adam veya türevleriyle (AdamW gibi) eğitilir.
- Varsayılan hiperparametreler (, , ) çoğu problemde iyi çalışır — bu, Adam’ın popülerliğinin bir nedeni.
- Momentum + uyarlanabilir öğrenme oranı birleşimi, hem gürültüye hem de kötü ölçeklenmiş gradyanlara karşı dayanıklı yapıyor.
Bu 3 hatayı yaparsın:
- Kendi optimizer’ını yazarken bias düzeltmesini unutmak — bu notebook’ta gördüğümüz gibi, ilk adımlar sessizce (hata mesajı vermeden) planlanandan kat kat büyük olur.
- Adam’ın “her zaman en iyi” olduğunu sanmak — bazı problemlerde (özellikle görüntü sınıflandırmada, ör. ResNet eğitimleri) düzgün ayarlanmış SGD+momentum daha iyi genelleme verebilir; büyük dil modelleri ise neredeyse her zaman Adam’ın bir türeviyle (AdamW) eğitilir.
- ‘yi (genelde 0.999) çok düşük ayarlayıp ‘nin çok hızlı değişmesine, dolayısıyla adımların kararsızlaşmasına neden olmak.
Kendini test et
1. Notebook'ta bias düzeltmesi olmadan Adam'ın ilk adımları neden 3-5 kat büyük çıktı (w minimumu aşıp -2.97'ye savruldu)?
- Öğrenme oranı çok küçüktü
- v (ikinci moment), ilk adımlarda gerçek değerinden çok küçük kaldığı için payda küçüldü ve adım boyutu büyüdü (doğru cevap)
- Gradyan yanlış hesaplandı
- Momentum kullanılmadı
Neden: t=1'de düzeltmesiz v sadece 0.001 (gerçek değerden 1000 kat küçük); m ise yalnızca 10 kat küçük. w -= lr*m/sqrt(v) formülünde payda paydan daha çok küçüldüğü için adım ~3 kat büyüyor.
2. Adam, hangi iki fikri birleştirir?
- Sadece SGD ve Adagrad
- Momentum (gradyanın ortalaması) ve RMSprop (gradyan karesinin ortalaması) (doğru cevap)
- Sadece L1 ve L2 düzenlileştirme
- Batch normalization ve dropout
Neden: Adam, momentumdan gradyanın üstel ortalamasını (m_t, birinci moment) ve RMSprop'tan gradyan karesinin üstel ortalamasını (v_t, ikinci moment) alıp birleştirir.
3. Bias düzeltmesi (m_t değerini (1-β₁^t) ile bölmek gibi) neden sadece ilk adımlarda etkilidir?
- Her zaman aynı etkiye sahiptir
- t büyüdükçe β üzeri t sıfıra yaklaşır, bu yüzden (1-β üzeri t) 1'e yaklaşır ve bölme işlemi etkisiz hale gelir (doğru cevap)
- Düzeltme sadece son adımda uygulanır
- Düzeltme, öğrenme oranını değiştirir
Neden: β1 ve β2, 1'den küçük olduğu için üsleri (β^t) adım sayısı arttıkça sıfıra yaklaşır; bu da (1-β^t) payını 1'e yaklaştırıp düzeltmeyi kademeli olarak "kapatır" -- düzeltme sadece erken adımlarda büyük bir fark yaratır.
Özet
Özet
- Adam, momentum (birinci moment) ve RMSprop (ikinci moment) fikirlerini birleştirir.
- m ve v, sıfırdan başladığı için ilk adımlarda gerçek değerlerinden sistematik olarak küçük kalır -- bias.
- Bias düzeltmesi ((1-beta^t)'ye bölme), bu erken-adım sapmasını giderir; düzeltme olmadan ilk adımlar kat kat büyük olur ve eğitim kararsızlaşabilir.
- Adam, günümüzde derin öğrenmenin en yaygın kullanılan varsayılan optimizer'ıdır.
- Varsayılan hiperparametreler (β1=0.9, β2=0.999) çoğu problemde iyi bir başlangıç noktasıdır.