

SGD, batch, momentum
Önkoşul:Optimizasyona giriş
Kanca
- derste öğrenme oranını inceledik ama şu ana kadar hep tüm veriyle (full batch) gradyan hesapladık. Gerçek eğitimde veri setleri milyonlarca örnek içerebilir — her adımda tümünü kullanmak çok yavaş olur. Bu dersin konusu: SGD, mini-batch, ve bunun getirdiği “gürültü” sorununu çözen momentum.
Sezgi
Stochastic Gradient Descent (SGD), gradyanı tüm veri yerine küçük bir rastgele örneklemle (mini-batch) tahmin eder. Bu daha hızlıdır ama her tahmin, gerçek gradyandan biraz sapar — bu sapmaya “gradyan gürültüsü” denir. Momentum, bu gürültüyü yumuşatan bir teknik.
Önce optimizer’ların bir “vadi” yüzeyinde nasıl yarıştığını izle — SGD’nin zigzag çizdiğine, momentumun bu salınımı nasıl düzelttiğine dikkat et.
Adım: 0
SGD'nin dar vadide nasıl zigzag çizdiğine, momentumun ise bu salınımı nasıl yumuşatıp hızlandırdığına dikkat et.
Mekanizma
Gürültü sorununu somutlaştıralım: aynı ağırlıkta (w=1.0), farklı büyüklükte rastgele örneklemlerle gradyanı defalarca tahmin edelim.
Tam veriyle 'gerçek' gradyan
# y = 3x + gürültü. w=1.0'da (henüz eğitilmemiş) gerçek gradyanı (tüm veriyle) hesaplayalım.
N = 50
xs = rng.uniform(-2, 2, N)
ys = 3 * xs + rng.uniform(-0.25, 0.25, N)

def gradyan_orneklem(w, indeksler):
    hatalar = w * xs[indeksler] - ys[indeksler]
    return np.mean(2 * hatalar * xs[indeksler])

w_sabit = 1.0
gercek_gradyan = gradyan_orneklem(w_sabit, np.arange(N))
print(f"Tam batch (n=50) gradyanı: {gercek_gradyan:.4f}  -- tüm veriyle hesaplanan, 'gerçek' gradyan")
Tam batch (n=50) gradyanı: -5.0398 -- tüm veriyle hesaplanan, 'gerçek' gradyanBatch boyutu ve gradyan gürültüsü
# Şimdi küçük rastgele örneklemlerle (mini-batch) aynı w'de gradyanı tahmin edelim.
# Her tahmin, gerçek gradyandan biraz sapacak -- bu sapmaya "gradyan gürültüsü" denir.
rng2 = np.random.default_rng(99)
print(f"\n{'Batch boyutu':<14} {'8 tahmin örneği':<50} {'std (300 tekrar)':<10}")
for batch_boyutu in [1, 4, 8, 16, 32]:
    tahminler_8 = [gradyan_orneklem(w_sabit, rng2.integers(0, N, batch_boyutu)) for _ in range(8)]
    tahminler_300 = [gradyan_orneklem(w_sabit, rng2.integers(0, N, batch_boyutu)) for _ in range(300)]
    std_deger = np.std(tahminler_300)
    ornek_str = ", ".join(f"{v:.2f}" for v in tahminler_8)
    print(f"{batch_boyutu:<14} {ornek_str:<50} {std_deger:<10.3f}")

print(f"\nbatch=1 (saf SGD) gradyanı çok gürültülü; batch=32 gerçek gradyana ({gercek_gradyan:.2f}) çok daha yakın kümeleniyor.")
Batch boyutu   8 tahmin örneği                                    std (300 tekrar)
1              -3.22, -6.23, -0.04, -7.57, -9.39, -6.23, -3.22, -1.85 4.282
4              -2.77, -6.96, -4.22, -4.39, -5.69, -7.89, -6.41, -3.14 1.931
8              -7.24, -7.95, -6.87, -4.42, -4.09, -4.75, -5.72, -4.86 1.540
16             -7.00, -5.48, -3.63, -4.15, -4.21, -6.82, -5.51, -5.11 1.057
32             -4.87, -5.52, -5.13, -3.82, -4.40, -4.62, -5.61, -5.29 0.728

batch=1 (saf SGD) gradyanı çok gürültülü; batch=32 gerçek gradyana (-5.04) çok daha yakın kümeleniyor.
batch=1’de (saf SGD) tahminler -9.39’dan -0.04’e kadar savruluyor (std=4.28); batch=32’de -3.82 ile -5.61 arasına sıkışıyor (std=0.73). Çoğu kişi “küçük batch = kötü gradyan” sanır. Kısmen doğru, çünkü her tek tahmin gürültülü olsa da, yön ortalamada doğrudur — sorun sadece bu gürültünün eğitimi yavaşlatmasıdır.
Matematik
Mini-batch gradyan ve momentum güncellemesi
| Sembol | Anlamı |
|---|---|
| Mini-batch — veri setinden rastgele seçilen küçük bir alt küme | |
| . adımdaki (gürültülü) gradyan tahmini | |
| “Hız” — geçmiş gradyanların üstel ortalaması | |
| Momentum katsayısı (genelde 0.9) — geçmişin ne kadarının hatırlanacağı |
Momentum, sadece son gradyanı değil, geçmiş gradyanların ağırlıklı ortalamasını kullanır — bu da rastgele gürültüyü birbirine karıştırıp iptal eder (11. derste gördüğümüz “ortalamanın gürültüyü azaltması” fikriyle aynı mantık).
Kod
Momentumun gürültülü mini-batch eğitimindeki etkisini doğrudan ölçelim:
Momentum, gürültüyü nasıl yumuşatır
# Momentum, geçmiş gradyanların üstel ortalamasını "hatırlayarak" bu gürültüyü yumuşatır.
# Etkisini doğrudan görelim: aynı w=1.0 noktasında art arda 60 mini-batch (boyut 4)
# gradyanı çekip, ham hâlleriyle momentumun kullandığı ortalamayı karşılaştıralım.
# (Adım boyunu ayrıca η belirler; burada yalnızca yönün ne kadar gürültülü olduğuna bakıyoruz.)
beta = 0.9
rng3 = np.random.default_rng(7)
ham_gradyanlar, momentum_yonu = [], []
v = 0.0
for adim in range(60):
    g = gradyan_orneklem(w_sabit, rng3.integers(0, N, 4))
    v = beta * v + (1 - beta) * g   # v_t'nin yön kısmı: geçmiş gradyanların üstel ortalaması
    ham_gradyanlar.append(g)
    momentum_yonu.append(v)

ISINMA = 20  # v sıfırdan başladığı için ilk adımlar ortalamaya "ısınıyor"; onları karşılaştırma dışı tut
ham_std = np.std(ham_gradyanlar[ISINMA:])
mom_std = np.std(momentum_yonu[ISINMA:])
print(f"Gerçek gradyan (tam batch): {gercek_gradyan:.2f}")
print(f"Ham mini-batch gradyanlarının std'si     : {ham_std:.2f}")
print(f"Momentum ortalamasının (β={beta}) std'si  : {mom_std:.2f}  -> {ham_std / mom_std:.1f} kat daha sakin")
print(f"Son 40 adımın ortalaması -- ham: {np.mean(ham_gradyanlar[ISINMA:]):.2f}, momentum: {np.mean(momentum_yonu[ISINMA:]):.2f}")
print("Momentum, gürültüyü iptal edip gerçek gradyanın etrafında çok daha dar bir bantta kalıyor.")
print("Bedeli: ortalama geçmişe baktığı için yön değişikliklerine geç tepki verir -- β çok yüksekse")
print("eğitimde hedefi aşıp salınabilir.")
Gerçek gradyan (tam batch): -5.04
Ham mini-batch gradyanlarının std'si : 2.16
Momentum ortalamasının (β=0.9) std'si : 0.36 -> 6.0 kat daha sakin
Son 40 adımın ortalaması -- ham: -4.79, momentum: -5.02
Momentum, gürültüyü iptal edip gerçek gradyanın etrafında çok daha dar bir bantta kalıyor.
Bedeli: ortalama geçmişe baktığı için yön değişikliklerine geç tepki verir -- β çok yüksekse
eğitimde hedefi aşıp salınabilir.Aynı noktada çekilen ham mini-batch gradyanları 2.16 std ile sıçrıyor; momentumun kullandığı ortalama ise 0.36 std ile gerçek gradyanın (-5.04) hemen etrafında kalıyor — 6 kat daha sakin bir güncelleme yönü. Bedeli: ortalama geçmişe baktığı için momentum yön değişikliklerine geç tepki verir; β çok yüksekse eğitimde hedefi aşıp salınabilir.
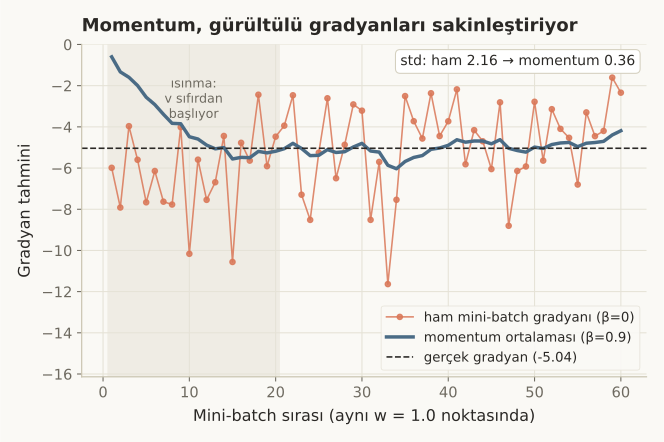 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Batch boyutu ve momentum, pratikte birlikte ayarlanan hiperparametrelerdir:
- Büyük veri setlerinde mini-batch SGD standarttır. Tam batch (tüm veri) çoğu zaman belleğe sığmaz ve çok yavaştır.
- Momentum (genelde β=0.9), neredeyse her modern optimizer’ın (16-18. derste göreceğimiz Adagrad, RMSprop, Adam) içinde bir şekilde bulunur.
- Batch boyutu arttıkça gradyan daha az gürültülü ama her adım daha pahalı olur — pratikte 32-256 arası yaygın bir denge noktasıdır.
Bu 3 hatayı yaparsın:
- Çok küçük batch boyutuyla (örn. 1-2) momentum kullanmadan eğitmek — gürültü, eğitimi yavaşlatır veya kararsızlaştırır.
- “Daha büyük batch her zaman daha iyi” sanmak — büyük batch her adımda daha pahalı olur ve bazen genelleme performansını düşürebilir.
- Momentum katsayısını (β) çok yükseğe (örn. 0.99) ayarlayıp ağın “geçmişe fazla bağlı kalarak” yön değiştirmekte zorlanmasına neden olmak.
Kendini test et
1. Notebook'ta batch=1 ile hesaplanan gradyan tahminleri neden bu kadar farklı çıktı (std=4.28)?
- Kod hatalıydı
- Tek bir rastgele örnek, tüm verinin ortalama eğilimini temsil etmekte yetersiz kalır -- her örnek kendi gürültüsünü taşır (doğru cevap)
- batch=1 her zaman yanlış sonuç verir
- Gradyan hesabı deterministik olmalıydı ama olmadı
Neden: Tek bir örnek, verinin genel eğilimini temsil etmek için yetersizdir; her örneğin kendi gürültüsü doğrudan gradyan tahminine yansır, bu yüzden tahminler geniş bir aralıkta dağılır.
2. Momentum, gürültülü mini-batch gradyanlarının etkisini nasıl azaltır?
- Gradyanı sıfırlayarak
- Sadece son gradyanı değil, geçmiş gradyanların üstel ortalamasını kullanarak -- rastgele gürültü ortalamada birbirini iptal eder (doğru cevap)
- Öğrenme oranını sıfıra indirerek
- Batch boyutunu otomatik büyüterek
Neden: Momentum güncellemesi geçmiş gradyanların ağırlıklı ortalamasını (v_t) biriktirir; rastgele gürültü ortalamada birbirini götürdüğü için güncelleme yönü çok daha sakin olur (momentum-etkisi bloğunda std 2.16'dan 0.36'ya iniyor).
3. Neden neredeyse hiçbir zaman tam batch (tüm veri seti) ile eğitim yapılmaz?
- Tam batch her zaman yanlış sonuç verir
- Büyük veri setlerinde tüm veriyi her adımda kullanmak belleğe sığmayabilir ve çok yavaş olur (doğru cevap)
- Tam batch gradyan hesaplayamaz
- Sadece küçük modellerde tam batch kullanılabilir
Neden: Milyonlarca örnekli veri setlerinde her adımda tüm veriyi işlemek hem bellek hem de hız açısından pratik değildir -- mini-batch, bu maliyeti azaltırken gradyanı hâlâ makul şekilde tahmin eder.
Özet
Özet
- SGD, gradyanı tüm veri yerine küçük bir rastgele örneklemle (mini-batch) tahmin eder.
- Küçük batch boyutu daha hızlı ama daha gürültülü gradyan tahmini üretir.
- Momentum, geçmiş gradyanların ağırlıklı ortalamasını kullanarak bu gürültüyü yumuşatır.
- Momentum, sonraki derslerde göreceğimiz Adagrad/RMSprop/Adam gibi optimizer'ların da temel bir bileşenidir.
- Batch boyutu (32-256 arası yaygın) ve momentum (genelde β=0.9), birlikte ayarlanan pratik hiperparametrelerdir.