

Ağırlık ilklendirme
Önkoşul:Patlayan gradyan ve clipping
Kanca
- derste kaybolan, 19. derste patlayan gradyanı gördük — ikisinin de kökü genelde aynı yerde: ağırlıkların başlangıç değerleri. Bu ders, eğitim başlamadan önce doğru kararı vermenin neden bu kadar önemli olduğunu gösteriyor.
Sezgi
Ağırlık ilklendirme, eğitim başlamadan önce ağırlıklara verilen ilk değerlerdir. İki soru var: (1) Tüm ağırlıklar aynı değerle mi başlamalı? (2) Rastgele başlıyorsa, bu rastgeleliğin büyüklüğü ne olmalı?
Mekanizma
Önce ilk soruya bakalım: tüm ağırlıkları sıfır yapsak ne olur?
Sıfır ilklendirmenin simetri sorunu
# Tüm ağırlıkları sıfır ile başlatırsak ne olur? Bir katmandaki 4 nöronun gradyanına bakalım.
katman = nn.Linear(2, 4, bias=False)
with torch.no_grad():
    katman.weight.fill_(0.0)

x = torch.tensor([[1.0, 2.0]])
y = katman(x)
kayip = y.sum()
kayip.backward()

print("Sıfır ilklendirme ile 4 nöronun gradyanları:")
print(katman.weight.grad)
print(f"\nTüm satırlar birbirine eşit mi? {torch.allclose(katman.weight.grad[0], katman.weight.grad[1])}")
print("Evet -- 4 nöron da aynı gradyanı alıyor, yani eğitim boyunca aynı kalacaklar.")
print("Bu 'simetri kırılamaması' sorunu: sıfır ilklendirme, bir katmandaki nöronları birbirinden ayırt edilemez yapar.")
Sıfır ilklendirme ile 4 nöronun gradyanları:
tensor([[1., 2.],
[1., 2.],
[1., 2.],
[1., 2.]])
Tüm satırlar birbirine eşit mi? True
Evet -- 4 nöron da aynı gradyanı alıyor, yani eğitim boyunca aynı kalacaklar.
Bu 'simetri kırılamaması' sorunu: sıfır ilklendirme, bir katmandaki nöronları birbirinden ayırt edilemez yapar.4 nöronun da gradyanı birebir aynı ([1,2] her satırda). Çoğu kişi “sıfırdan başlamak nötr, güvenli bir seçim” sanır. Yanlış, çünkü aynı gradyanı alan nöronlar, aynı güncellemeyi alır — ve sonsuza kadar birbirinin kopyası kalırlar. Ağın 4 nöronu varmış gibi görünse de, aslında tek bir nöron gibi davranıyor.
Matematik
Xavier ve He ilklendirme formülleri
| Sembol | Anlamı |
|---|---|
| Ağırlıkların rastgele başlatılacağı normal dağılımın standart sapması | |
| (fan-in) | O katmana giren bağlantı sayısı |
Xavier (Glorot), sigmoid/tanh için; He (Kaiming), ReLU için tasarlanmıştır. Fark, ReLU’nun girdilerin yarısını sıfırlaması — He’nin formülündeki ekstra “2” çarpanı, bu kaybı telafi eder.
Kod
Şimdi ikinci soru: rastgele ilklendirmenin büyüklüğü. 10 katmanlı bir ağda, sinyalin (tanh ile) katman katman nasıl değiştiğini üç ölçekte izleyelim:
Ölçek çok küçük, çok büyük, veya Xavier
# Rastgele ilklendirmenin büyüklüğü (std) de kritik. 10 katmanlı bir ağda, girdi sinyalinin
# (tanh aktivasyonuyla) katman katman nasıl değiştiğini üç farklı ölçekte izleyelim.
def sinyal_yayilimi(std, katman_sayisi=10, genislik=100, aktivasyon=torch.tanh):
    x = torch.randn(1, genislik)
    stdler = [x.std().item()]
    for _ in range(katman_sayisi):
        W = torch.randn(genislik, genislik) * std
        x = aktivasyon(x @ W)
        stdler.append(x.std().item())
    return stdler

genislik = 100
xavier_std = (1 / genislik) ** 0.5

cok_kucuk = sinyal_yayilimi(0.01, genislik=genislik)
cok_buyuk = sinyal_yayilimi(1.0, genislik=genislik)
xavier = sinyal_yayilimi(xavier_std, genislik=genislik)

print(f"\n{'Katman':<8} {'std=0.01 (çok küçük)':<22} {'std=1.0 (çok büyük)':<22} {'Xavier (1/√fan_in)':<20}")
for k in [0, 2, 5, 8, 10]:
    print(f"{k:<8} {cok_kucuk[k]:<22.4f} {cok_buyuk[k]:<22.4f} {xavier[k]:<20.4f}")

print("\nÇok küçük ölçek: sinyal 5. katmanda pratikte sıfıra iniyor (kaybolan gradyan, 5. ders).")
print("Çok büyük ölçek: sinyal tanh'ın doygunluk bölgesine kilitleniyor (std~1'de takılı kalıyor).")
print("Xavier: sinyal daha yumuşak azalıyor -- ne aniden sıfırlanıyor ne doygunluğa kilitleniyor.")
Katman   std=0.01 (çok küçük)   std=1.0 (çok büyük)    Xavier (1/√fan_in)
0        0.9389                 1.0206                 1.0069
2        0.0097                 0.9581                 0.5380
5        0.0000                 0.9695                 0.3450
8        0.0000                 0.9714                 0.3509
10       0.0000                 0.9512                 0.2493

Çok küçük ölçek: sinyal 5. katmanda pratikte sıfıra iniyor (kaybolan gradyan, 5. ders).
Çok büyük ölçek: sinyal tanh'ın doygunluk bölgesine kilitleniyor (std~1'de takılı kalıyor).
Xavier: sinyal daha yumuşak azalıyor -- ne aniden sıfırlanıyor ne doygunluğa kilitleniyor.
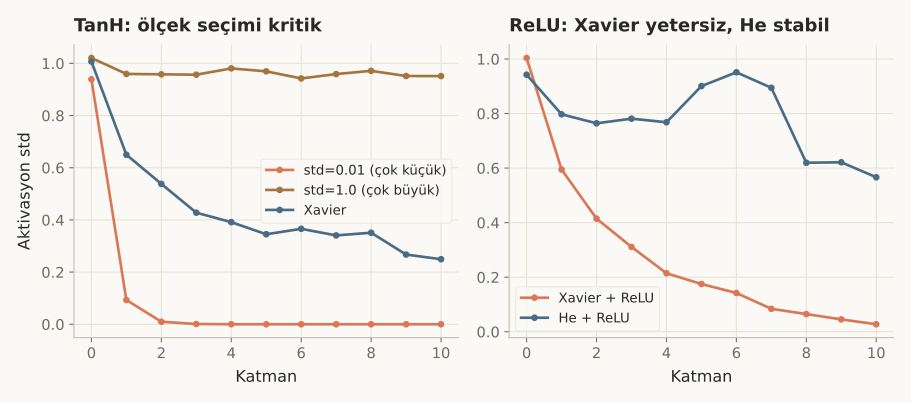
Çok küçük ölçek (std=0.01), sinyali 5. katmanda pratikte sıfıra indiriyor — 5. dersteki kaybolan gradyanın kökeni. Çok büyük ölçek (std=1.0), sinyali tanh’ın doygunluk bölgesine kilitliyor. Xavier, ikisi arasında çok daha yumuşak bir azalma sağlıyor.
ReLU ile Xavier yetersiz kalıyor
# Xavier, tanh/sigmoid için tasarlandı. ReLU ile ne olur? He ilklendirmesi neden var?
he_std = (2 / genislik) ** 0.5

xavier_relu = sinyal_yayilimi(xavier_std, genislik=genislik, aktivasyon=torch.relu)
he_relu = sinyal_yayilimi(he_std, genislik=genislik, aktivasyon=torch.relu)

print(f"\n{'Katman':<8} {'Xavier + ReLU':<18} {'He + ReLU':<18}")
for k in [0, 2, 5, 8, 10]:
    print(f"{k:<8} {xavier_relu[k]:<18.4f} {he_relu[k]:<18.4f}")

print("\nReLU ile Xavier kullanmak sinyali yine küçültüyor (10. katmanda 0.027 -- ReLU'nun yarı-sıfırlama etkisini hesaba katmıyor).")
print("He ilklendirmesi (√(2/fan_in)), bu etkiyi telafi edip sinyali çok daha stabil tutuyor (10. katmanda ~0.57).")
Katman   Xavier + ReLU      He + ReLU
0        1.0036             0.9423
2        0.4146             0.7642
5        0.1749             0.9006
8        0.0647             0.6195
10       0.0274             0.5663

ReLU ile Xavier kullanmak sinyali yine küçültüyor (10. katmanda 0.027 -- ReLU'nun yarı-sıfırlama etkisini hesaba katmıyor).
He ilklendirmesi (√(2/fan_in)), bu etkiyi telafi edip sinyali çok daha stabil tutuyor (10. katmanda ~0.57).
ReLU ile Xavier kullanmak sinyali yine küçültüyor (10. katmanda 0.027); He ilklendirmesi sinyali 0.57 civarında çok daha stabil tutuyor.
 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Modern derin öğrenme kütüphaneleri (PyTorch dahil) çoğu katman için makul varsayılan ilklendirmeler kullanır, ama bunu bilmek hâlâ önemlidir:
- PyTorch’ta
nn.init.xavier_uniform_/nn.init.kaiming_uniform_(He’nin diğer adı) fonksiyonlarıyla elle ayarlanabilir. - Aktivasyon fonksiyonuna göre doğru şemayı seç: sigmoid/tanh → Xavier, ReLU/GELU (6-10. ders) → He.
- Çok derin ağlarda (CNN’lerin çoğu katmanı gibi) doğru ilklendirme, eğitimin başlayıp başlamayacağını bile belirleyebilir.
Bu 3 hatayı yaparsın:
- Tüm ağırlıkları sıfır (veya aynı sabit değer) ile başlatmak — simetri hiç kırılmaz, nöronlar birbirinin kopyası kalır.
- ReLU kullanırken Xavier ilklendirmeyi kullanmaya devam etmek — sinyal, derin ağlarda yavaşça sönümlenir.
- “Model öğrenmiyor” diye mimariyi değiştirmeye başlamak, ama sorunun aslında kötü ilklendirmeden kaynaklandığını fark etmemek.
Kendini test et
1. Notebook'ta tüm ağırlıklar sıfırla başlatıldığında 4 nöron neden birbirinden hiç ayrışamadı?
- Kod hatalıydı
- Sıfır ağırlıklarla tüm nöronlar aynı gradyanı aldığı için, her güncellemede aynı şekilde değişmeye devam ettiler -- simetri hiç kırılmadı (doğru cevap)
- PyTorch sıfır ilklendirmeyi desteklemiyor
- Öğrenme oranı çok küçüktü
Neden: Tüm ağırlıklar sıfırken her nöronun çıktısı ve dolayısıyla gradyanı özdeştir; bu simetri, güncellemeler devam ettikçe de kırılmaz -- nöronlar sonsuza kadar birbirinin kopyası kalır.
2. Ağırlık ilklendirme ölçeği çok küçük seçilirse (örn. std=0.01) derin bir ağda ne olur?
- Hiçbir etkisi olmaz
- Sinyal, katman katman küçülerek birkaç katman içinde pratikte sıfıra iner (kaybolan gradyanla aynı kök neden) (doğru cevap)
- Eğitim daha hızlı olur
- Sadece ilk katmanı etkiler
Neden: Notebook'ta std=0.01 ile sinyal 5. katmanda pratikte sıfıra iniyor (0.0000) -- bu, 5. dersteki kaybolan gradyan probleminin başlangıç noktasıdır.
3. He ilklendirmesi neden özellikle ReLU için tasarlanmıştır?
- He, Xavier ile tamamen aynıdır
- ReLU, negatif girdileri sıfırlayarak sinyalin yaklaşık yarısını söndürür; He'nin formülündeki ekstra '2' çarpanı bu kaybı telafi eder (doğru cevap)
- He sadece sigmoid için çalışır
- He ilklendirme rastgelelik içermez
Neden: ReLU çıktıların yaklaşık yarısını sıfırladığı için sinyal varyansı yarıya iner; He'nin √(2/n) formülündeki '2' çarpanı bu kaybı telafi ederek sinyali stabil tutar -- notebook'ta Xavier+ReLU 10. katmanda 0.027'ye düşerken He+ReLU 0.57'de kalıyor.
Özet
Özet
- Tüm ağırlıkları aynı değerle (örn. sıfır) başlatmak, nöronlar arasındaki simetriyi asla kırmaz.
- Rastgele ilklendirmenin ölçeği kritiktir: çok küçük sinyali söndürür, çok büyük doygunluğa kilitler.
- Xavier ilklendirme (√(1/fan_in)), sigmoid/tanh aktivasyonları için tasarlanmıştır.
- He ilklendirme (√(2/fan_in)), ReLU'nun yarı-sıfırlama etkisini telafi eder.
- Doğru ilklendirme seçimi, derin bir ağın eğitilebilir olup olmadığını doğrudan etkiler.