

Veri artırma
Önkoşul:Klasik mimariler (LeNet → ResNet)
Kanca
21-22. derste weight decay ve dropout ile aşırı öğrenmeyi önlemeyi gördük. Veri artırma (data augmentation), tamamen farklı bir stratejiyle aynı hedefe ulaşıyor: modele daha fazla ağırlık kısıtlaması eklemek yerine, ona daha çeşitli veri göstermek — ama bu veriyi yapay olarak üretiyoruz.
Sezgi
Veri artırma, mevcut eğitim örneklerine küçük, etiketi değiştirmeyen dönüşümler uygulayarak yapay olarak daha fazla veri üretmektir. Bir kedi fotoğrafını yatay çevirsen, döndürsen veya kırpsan bile, o hâlâ bir kedidir — ama artık modelin görmediği, biraz farklı bir örnektir.
Mekanizma
torchvision.transforms, en yaygın dönüşümleri hazır sunar:
Yaygın veri artırma dönüşümleri
# torchvision.transforms, gerçek görüntülerde en sık kullanılan artırma (augmentation)
# tekniklerini hazır sunar. Küçük bir örnek görselde bunları görelim.
ornek_gorsel = torch.zeros(1, 8, 8)
ornek_gorsel[0, 2:6, 3:5] = 1.0  # basit bir dikdörtgen

donusumler = {
    "Orijinal": lambda x: x,
    "Yatay çevirme": T.RandomHorizontalFlip(p=1.0),
    "Döndürme (±15°)": T.RandomRotation(15),
    "Rastgele kırpma": T.RandomCrop(6),
}

print("Aynı görsele farklı dönüşümler uygulandığında şekilleri:")
for isim, donusum in donusumler.items():
    sonuc = donusum(ornek_gorsel)
    print(f"  {isim}: şekil {tuple(sonuc.shape)}")

print("\nBu dönüşümlerin hiçbiri etiketi (bu görselin ait olduğu sınıf) değiştirmez -- sadece pikselleri.")
print("Fikir: aynı nesnenin binlerce 'varyasyonunu' yapay olarak üretip modele göstermek.")
Aynı görsele farklı dönüşümler uygulandığında şekilleri:
Orijinal: şekil (1, 8, 8)
Yatay çevirme: şekil (1, 8, 8)
Döndürme (±15°): şekil (1, 8, 8)
Rastgele kırpma: şekil (1, 6, 6)
Bu dönüşümlerin hiçbiri etiketi (bu görselin ait olduğu sınıf) değiştirmez -- sadece pikselleri.
Fikir: aynı nesnenin binlerce 'varyasyonunu' yapay olarak üretip modele göstermek.Şimdi 26. dersteki “kare, farklı pozisyonda tanınamıyor” sorununa dönelim — ama bu kez bir CNN kullanıp sadece 2 sabit pozisyonda eğitelim:
Augmentation olmadan
# 26. dersteki 'kare, farklı pozisyonda tanınamıyor' sorununa dönelim -- ama bu kez
# CNN kullanalım ve sadece 2 pozisyonda eğitelim.
def kare_ekle(taban, satir, sutun, boyut=2):
    img = taban.clone()
    img[satir:satir+boyut, sutun:sutun+boyut] = 1.0
    return img

def veri_uret(pozisyonlar, n, gurultu=0.05):
    xs, ys = [], []
    for i in range(n):
        if i % 2 == 0:
            satir, sutun = pozisyonlar[torch.randint(0, len(pozisyonlar), (1,)).item()]
            img = kare_ekle(torch.zeros(10, 10), satir, sutun)
            ys.append(1)
        else:
            img = torch.zeros(10, 10)
            ys.append(0)
        img = img + torch.randn(10, 10) * gurultu
        xs.append(img)
    return torch.stack(xs).unsqueeze(1), torch.tensor(ys, dtype=torch.float32)

egitim_pozisyonlari = [(0, 0), (1, 1)]  # Sadece sol-üst bölgede
egitim_x, egitim_y = veri_uret(egitim_pozisyonlari, 60)

test_pozisyonlari = [(0, 0), (2, 3), (5, 5), (6, 2), (3, 6), (7, 7)]  # Çok daha geniş bir alan
test_x, test_y = veri_uret(test_pozisyonlari, 40)

def ag_olustur():
    torch.manual_seed(1)
    return nn.Sequential(
        nn.Conv2d(1, 4, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
        nn.Conv2d(4, 8, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2),
        nn.Flatten(), nn.Linear(8 * 2 * 2, 1), nn.Sigmoid(),
    )

def egit(kaydirma_augmentation, epochs=200, lr=0.01):
    ag = ag_olustur()
    optimizer = torch.optim.Adam(ag.parameters(), lr=lr)
    for _ in range(epochs):
        if kaydirma_augmentation:
            ks, kt = torch.randint(-2, 3, (2,)).tolist()
            girdi = torch.roll(egitim_x, shifts=(ks, kt), dims=(2, 3))  # rastgele kaydırma
        else:
            girdi = egitim_x
        optimizer.zero_grad()
        tahmin = ag(girdi).squeeze()
        kayip = nn.functional.binary_cross_entropy(tahmin, egitim_y)
        kayip.backward()
        optimizer.step()
    with torch.no_grad():
        egitim_dogruluk = ((ag(egitim_x).squeeze() > 0.5).float() == egitim_y).float().mean().item()
        test_dogruluk = ((ag(test_x).squeeze() > 0.5).float() == test_y).float().mean().item()
    return egitim_dogruluk, test_dogruluk

et_yok, tt_yok = egit(kaydirma_augmentation=False)
print(f"\nAugmentation yok: eğitim doğruluğu={et_yok:.2f}, test doğruluğu (yeni pozisyonlarda)={tt_yok:.2f}")
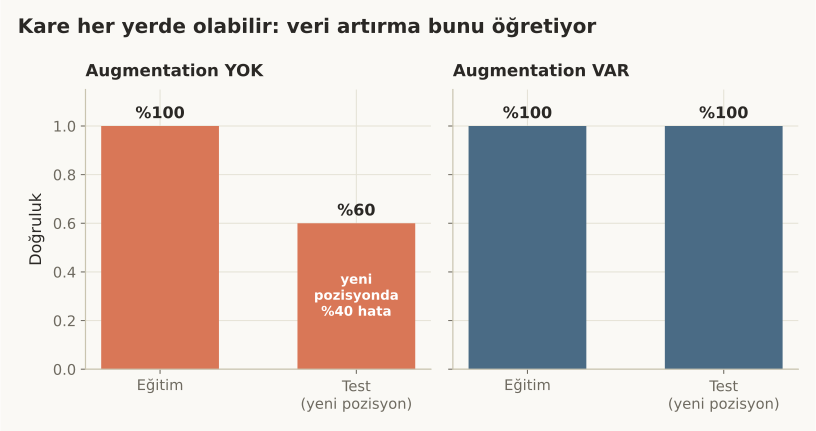
Augmentation yok: eğitim doğruluğu=1.00, test doğruluğu (yeni pozisyonlarda)=0.60Eğitim doğruluğu %100 ama yeni pozisyonlarda test doğruluğu sadece %60 — neredeyse rastgele. Şimdi aynı veriye, her eğitim adımında rastgele bir kaydırma (augmentation) uygulayalım:
Augmentation ile
# Şimdi aynı eğitim verisine, her adımda rastgele bir kaydırma (augmentation) uygulayalım.
et_var, tt_var = egit(kaydirma_augmentation=True)
print(f"Augmentation var: eğitim doğruluğu={et_var:.2f}, test doğruluğu (yeni pozisyonlarda)={tt_var:.2f}")
print(f"\nİkisi de eğitim verisinde mükemmel ({et_yok:.2f} ve {et_var:.2f}) -- ama test doğruluğu {tt_yok:.2f} → {tt_var:.2f} sıçradı!")
print("Augmentation, modele 'kare her yerde olabilir' fikrini öğretti -- sadece 2 sabit pozisyonu ezberlemek yerine.")
Augmentation var: eğitim doğruluğu=1.00, test doğruluğu (yeni pozisyonlarda)=1.00
İkisi de eğitim verisinde mükemmel (1.00 ve 1.00) -- ama test doğruluğu 0.60 → 1.00 sıçradı!
Augmentation, modele 'kare her yerde olabilir' fikrini öğretti -- sadece 2 sabit pozisyonu ezberlemek yerine.Test doğruluğu %60’tan %100’e sıçradı! Çoğu kişi “veri artırma sadece küçük bir iyileştirme sağlar” sanır. Yanlış, çünkü burada modelin “kare her yerde olabilir” fikrini öğrenmesini sağladı — sadece 2 sabit konumu ezberlemek yerine.
Matematik
Veri artırma neden işe yarar?
| Sembol | Anlamı |
|---|---|
| Orijinal eğitim örneği | |
| Dönüştürülmüş (çevrilmiş, döndürülmüş, kaydırılmış) versiyon | |
| Model — ve ‘in aynı sınıfı vermesi istenir |
Model, her eğitim adımında ‘in farklı bir versiyonunu görünce, “önemli olan ne’nin orada olduğu, tam olarak nerede/nasıl göründüğü değil” ilkesini öğrenmeye zorlanır.
Kod
 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Veri artırma, özellikle sınırlı veri setlerinde standart bir uygulamadır:
- Görüntülerde yaygın dönüşümler: yatay/dikey çevirme, döndürme, kırpma, renk/parlaklık değişimi, gürültü ekleme.
- Dönüşüm seçimi probleme bağlıdır — bir el yazısı rakam tanıma modelinde dikey çevirme yanlış olur (6 ve 9’u karıştırabilir!), ama bir kedi/köpek sınıflandırıcısında güvenlidir.
- Augmentation, sadece eğitim verisine uygulanır — test/değerlendirme verisi orijinal haliyle kalır (22. dersteki eval() modu gibi, augmentation da sadece eğitimde aktif olmalıdır).
Bu 3 hatayı yaparsın:
- Etiketi değiştiren bir dönüşüm uygulamak (örn. “6” rakamını 180° döndürüp hâlâ “6” etiketiyle göstermek — bu aslında “9” olur).
- Test/değerlendirme verisine de augmentation uygulamak — bu, model performansını yanlış ölçmene neden olur.
- Augmentation’ın weight decay/dropout (21-22. ders) yerine geçtiğini sanmak — genelde birlikte kullanılırlar.
Kendini test et
1. Notebook'ta augmentation olmadan eğitilen model, eğitim verisinde %100 doğrulukken yeni pozisyonlarda neden sadece %60 doğru oldu?
- Model yeterince eğitilmedi
- Model, sadece 2 sabit pozisyonu ezberledi -- 'kare her yerde olabilir' genel kuralını değil, 'kare tam olarak şu 2 yerde olabilir' özel kuralını öğrendi (doğru cevap)
- Test verisi hatalıydı
- CNN mimarisi yanlıştı
Neden: Eğitim verisinde kare sadece 2 sabit konumda göründüğü için model bu spesifik konumları ezberledi; hiç görmediği yeni konumlarda genelleyemedi -- klasik bir aşırı öğrenme belirtisi.
2. Veri artırma dönüşümleri seçilirken en önemli kural nedir?
- Mümkün olduğunca çok dönüşüm uygulamak
- Dönüşüm, görselin etiketini (ait olduğu sınıfı) değiştirmemelidir -- örn. el yazısı rakamlarda dikey çevirme '6'yı '9' yapabileceği için uygun değildir (doğru cevap)
- Sadece renkli görüntülerde dönüşüm uygulanmalıdır
- Dönüşümler test verisine de mutlaka uygulanmalıdır
Neden: Augmentation'ın temel varsayımı, dönüşümün altındaki gerçek sınıfı değiştirmemesidir; bu varsayım ihlal edilirse (örn. 6->9 dönüşümü), model yanlış etiketlerle eğitilmiş olur.
3. Veri artırma neden sadece eğitim verisine uygulanır, test verisine değil?
- Test verisine uygulamak teknik olarak imkansızdır
- Test verisinin amacı modelin gerçek, değiştirilmemiş veri üzerindeki performansını ölçmektir -- augmentation uygulamak bu ölçümü çarpıtır (doğru cevap)
- Augmentation zaten otomatik olarak sadece eğitimde çalışır
- Hiçbir teknik nedeni yoktur, sadece bir gelenektir
Neden: Test verisi, modelin gerçek dünyadaki performansını temsil etmelidir; augmentation uygulamak test setini yapay olarak değiştirir ve modelin gerçek genelleme performansı hakkında yanıltıcı bir ölçüm verir.
Özet
Özet
- Veri artırma, mevcut örneklere etiketi değiştirmeyen dönüşümler uygulayarak yapay olarak veri çeşitliliği yaratır.
- torchvision.transforms, çevirme, döndürme, kırpma gibi yaygın dönüşümleri hazır sunar.
- Notebook'ta rastgele kaydırma augmentation'ı, yeni pozisyonlardaki test doğruluğunu %60'tan %100'e çıkardı.
- Dönüşüm seçimi probleme bağlıdır -- etiketi değiştiren bir dönüşüm (örn. rakamlarda dikey çevirme) zararlıdır.
- Augmentation sadece eğitim verisine uygulanır; test verisi gerçek performansı ölçmek için orijinal kalmalıdır.