

Dropout
Önkoşul:L1/L2 düzenlileştirme
Kanca
- derste ağırlıkların büyüklüğünü cezalayarak aşırı öğrenmeyi önledik (weight decay). Dropout, tamamen farklı bir strateji izliyor: ağırlıklara dokunmuyor, bunun yerine eğitim sırasında rastgele nöronları geçici olarak “kapatıyor”.
Sezgi
Dropout, her eğitim adımında, her nöronu (belirli bir olasılıkla) geçici olarak sıfırlar. Bu, ağın tek bir nörona veya küçük bir nöron grubuna aşırı bağımlı hale gelmesini engeller — her nöron, “komşularının her zaman orada olacağını” varsayamaz.
Dropout oranını ve normalizasyon sekmelerini dene — rastgele sıfırlamanın aktivasyon dağılımını nasıl değiştirdiğine bak (BatchNorm ve LayerNorm sekmeleri 23-24. derste işlenecek).
Ham aktivasyonlar düzensiz: örnekten örneğe (satır) ve nörondan nörona (sütun) çok farklı büyüklük ve merkezlerde.
Mekanizma
Dropout’un en şaşırtıcı özelliği: aynı girdi, aynı ağırlıklarla bile, eğitim modunda her seferinde farklı bir çıktı verebilir.
train() vs eval() modunda dropout
# Dropout, her forward pass'te rastgele nöronları (olasılık p ile) sıfırlar.
# Bu yüzden aynı girdi bile, train() modunda her seferinde farklı bir çıktı verebilir.
torch.manual_seed(0)
ag = nn.Sequential(nn.Linear(4, 4), nn.Dropout(0.5))
x = torch.ones(1, 4)

ag.train()
print("train() modunda aynı girdiyle 3 farklı forward pass:")
for _ in range(3):
    print(" ", ag(x).detach().numpy().round(3))

ag.eval()
print("\neval() modunda aynı girdiyle 3 farklı forward pass:")
for _ in range(3):
    print(" ", ag(x).detach().numpy().round(3))

print("\ntrain() modunda çıktı her seferinde değişiyor (rastgele maskeleme); eval() modunda sabit -- dropout kapalı.")
train() modunda aynı girdiyle 3 farklı forward pass:
[[-0.635 1.256 -1.001 -0. ]]
[[-0.635 1.256 -1.001 -2.428]]
[[-0. 0. -1.001 -0. ]]
eval() modunda aynı girdiyle 3 farklı forward pass:
[[-0.317 0.628 -0.5 -1.214]]
[[-0.317 0.628 -0.5 -1.214]]
[[-0.317 0.628 -0.5 -1.214]]
train() modunda çıktı her seferinde değişiyor (rastgele maskeleme); eval() modunda sabit -- dropout kapalı.train() modunda 3 forward pass 3 farklı sonuç veriyor (rastgele hangi nöronların sıfırlandığına bağlı); eval() modunda ise 3’ü de birebir aynı. Çoğu kişi “model her zaman aynı girdiye aynı çıktıyı verir” sanır. Eğitim sırasında yanlış, çünkü dropout kasıtlı olarak rastgelelik ekliyor — bu da ağın sağlam (dayanıklı) örüntüler öğrenmesini zorluyor.
Matematik
Dropout ve 'inverted dropout' ölçeklemesi
| Sembol | Anlamı |
|---|---|
| Dropout oranı — bir nöronun sıfırlanma olasılığı | |
| O nöron için rastgele maske: olasılıkla 1, olasılıkla 0 | |
| “Inverted dropout” ölçeklemesi — kalan nöronları büyüterek beklenen toplamı korur |
Bu ölçekleme olmasaydı, eğitim sırasında (dropout aktifken) ve değerlendirmede (dropout kapalıyken) katmanın çıktı büyüklüğü sistematik olarak farklı olurdu.
Kod
- dersteki aynı küçük/gürültülü veri setinde, bu kez dropout’u deneyelim:
Dropout, aşırı öğrenmeyi nasıl önler
# 21. dersteki aynı küçük/gürültülü veri setinde, weight_decay yerine dropout deneyelim.
N_egitim = 15
x_egitim = torch.linspace(-3, 3, N_egitim).unsqueeze(1)
y_egitim = torch.sin(x_egitim) + torch.randn(N_egitim, 1) * 0.3

N_test = 100
x_test = torch.linspace(-3, 3, N_test).unsqueeze(1)
y_test = torch.sin(x_test)

def ag_olustur(dropout_orani):
    torch.manual_seed(1)
    katmanlar = [nn.Linear(1, 64), nn.Tanh()]
    if dropout_orani > 0:
        katmanlar.append(nn.Dropout(dropout_orani))
    katmanlar += [nn.Linear(64, 64), nn.Tanh()]
    if dropout_orani > 0:
        katmanlar.append(nn.Dropout(dropout_orani))
    katmanlar.append(nn.Linear(64, 1))
    return nn.Sequential(*katmanlar)

def egit(dropout_orani, epochs=3000, lr=0.01):
    ag = ag_olustur(dropout_orani)
    optimizer = torch.optim.Adam(ag.parameters(), lr=lr)
    for _ in range(epochs):
        ag.train()  # dropout aktif
        optimizer.zero_grad()
        tahmin = ag(x_egitim)
        kayip = torch.mean((tahmin - y_egitim) ** 2)
        kayip.backward()
        optimizer.step()
    ag.eval()  # dropout kapalı -- değerlendirmede rastgelelik istenmez
    with torch.no_grad():
        egitim_kaybi = torch.mean((ag(x_egitim) - y_egitim) ** 2).item()
        test_kaybi = torch.mean((ag(x_test) - y_test) ** 2).item()
    return egitim_kaybi, test_kaybi

print(f"\n{'Dropout oranı':<16} {'Eğitim kaybı':<14} {'Test kaybı':<12}")
sonuclar = {}
for p in [0.0, 0.1, 0.3, 0.5]:
    et, tt = egit(p)
    sonuclar[p] = (et, tt)
    print(f"{p:<16} {et:<14.4f} {tt:<12.4f}")

en_iyi_p = min(sonuclar, key=lambda p: sonuclar[p][1])  # test kaybı en düşük oran
print(f"\ndropout=0: eğitim kaybı sıfıra çok yakın (ezber). dropout={en_iyi_p}: test kaybı en düşük -- 21. dersteki weight_decay'e benzer bir 'tatlı nokta'.")
print("dropout=0.5: eğitim kaybı belirgin arttı -- çok fazla nöron sıfırlanınca ağ yeterince öğrenemiyor.")
Dropout oranı    Eğitim kaybı   Test kaybı
0.0              0.0002         0.0715
0.1              0.0175         0.0515
0.3              0.0398         0.0624
0.5              0.0813         0.0621

dropout=0: eğitim kaybı sıfıra çok yakın (ezber). dropout=0.1: test kaybı en düşük -- 21. dersteki weight_decay'e benzer bir 'tatlı nokta'.
dropout=0.5: eğitim kaybı belirgin arttı -- çok fazla nöron sıfırlanınca ağ yeterince öğrenemiyor.
dropout=0’da eğitim kaybı neredeyse sıfır (ezber) ama test kaybı yüksek (0.0715). dropout=0.1’de test kaybı 0.0515’e düşüyor — 21. dersteki weight_decay’e çok benzer bir “tatlı nokta” hikayesi.
Ölçeklemenin doğruluğunu kontrol edelim
# nn.Dropout, kalan (sıfırlanmayan) değerleri 1/(1-p) ile ölçekler -- neden?
p = 0.5
katman = nn.Dropout(p)
katman.train()
girdi = torch.ones(10000)  # büyük bir örneklemle ortalamayı test edelim
cikti = katman(girdi)
print(f"\nGirdi ortalaması: {girdi.mean().item():.4f}")
print(f"Dropout(p=0.5) sonrası çıktı ortalaması: {cikti.mean().item():.4f}")
print("İkisi de ~1.0 -- 'inverted dropout' ölçeklemesi sayesinde ortalama korunuyor.")
print("Bu sayede train() ve eval() arasında modelin çıktı büyüklüğü tutarlı kalıyor.")
Girdi ortalaması: 1.0000
Dropout(p=0.5) sonrası çıktı ortalaması: 0.9964
İkisi de ~1.0 -- 'inverted dropout' ölçeklemesi sayesinde ortalama korunuyor.
Bu sayede train() ve eval() arasında modelin çıktı büyüklüğü tutarlı kalıyor.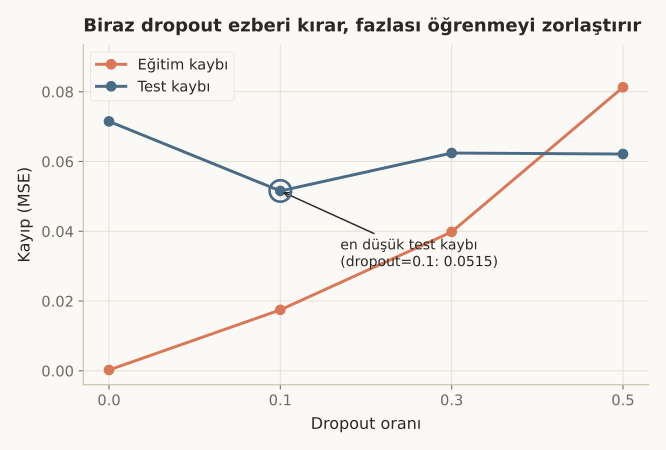 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Dropout, özellikle tam bağlantılı (fully-connected) katmanlarda yaygın kullanılır:
nn.Dropout(p), genelde aktivasyon fonksiyonundan sonra eklenir. Tipik oranlar 0.1-0.5 arası.model.train()vemodel.eval()çağırmayı unutmamak kritiktir — eval() olmadan değerlendirme sırasında bile rastgelelik devam eder, bu da tutarsız sonuçlara yol açar.- CNN’lerde (bir sonraki bölüm) dropout daha az yaygındır — konvolüsyon katmanlarının kendine has parametre paylaşımı, zaten bir miktar düzenlileştirme sağlar.
Bu 3 hatayı yaparsın:
- Değerlendirme (inference) öncesi
model.eval()çağırmayı unutmak — bu, üretim ortamında sessizce tutarsız/rastgele tahminlere yol açar. - Dropout oranını çok yükseğe (örn. 0.7-0.8) ayarlayıp ağın yeterince öğrenememesine neden olmak.
- Çok küçük ağlarda (az parametre) agresif dropout kullanmak — zaten sınırlı kapasiteyi daha da kısıtlar.
Kendini test et
1. Notebook'ta train() modunda aynı girdiye 3 farklı forward pass neden 3 farklı sonuç verdi?
- Kod hatalıydı
- Dropout, her forward pass'te rastgele farklı bir nöron alt kümesini sıfırlıyor -- bu yüzden aynı girdi bile farklı bir "etkin ağ" üzerinden geçiyor (doğru cevap)
- Ağırlıklar her seferinde değişiyor
- PyTorch rastgele hata üretiyor
Neden: Her forward pass'te yeni bir rastgele maske (m_i) örneklenir; hangi nöronların sıfırlandığı her seferinde değiştiği için, aynı girdi ve aynı ağırlıklarla bile çıktı değişir.
2. 'Inverted dropout' ölçeklemesi (kalan değerleri 1/(1-p) ile çarpmak) neden gereklidir?
- Hesaplamayı hızlandırmak için
- Nöronların bir kısmı sıfırlandığında toplam aktivasyon büyüklüğü küçülür; bu ölçekleme, beklenen toplamı koruyarak train/eval arasında tutarlılık sağlar (doğru cevap)
- Gradyanları büyütmek için
- Sadece görselleştirme amaçlı
Neden: Nöronların p oranı sıfırlandığında kalan aktivasyonların toplamı da küçülür; 1/(1-p) ile ölçekleme bu kaybı telafi ederek katmanın beklenen çıktı büyüklüğünü hem train hem eval modunda tutarlı tutar.
3. model.eval() çağırmayı unutmanın pratikte en büyük riski nedir?
- Model daha yavaş çalışır
- Dropout (ve batch normalization gibi diğer katmanlar) train modunda kalır -- bu da değerlendirme/üretim sırasında sessizce tutarsız, rastgele tahminlere yol açar (doğru cevap)
- Bellek hatası oluşur
- Hiçbir etkisi yoktur
Neden: eval() çağrılmazsa dropout aktif kalmaya devam eder ve her tahmin farklı bir rastgele maskeyle üretilir -- bu da modelin üretimde güvenilmez, tekrarlanamaz sonuçlar vermesine yol açan sessiz bir hatadır.
Özet
Özet
- Dropout, eğitim sırasında her nöronu belirli bir olasılıkla geçici olarak sıfırlar.
- "Inverted dropout", kalan nöronları 1/(1-p) ile ölçekleyerek beklenen çıktı büyüklüğünü korur.
- train() modunda dropout aktif (rastgele); eval() modunda kapalı (deterministik).
- model.eval() çağırmayı unutmak, üretimde tutarsız tahminlere yol açan yaygın bir hatadır.
- Dropout oranı da bir "tatlı nokta" gerektirir -- weight decay'deki (21. ders) gibi çok azı yetersiz, çok fazlası zararlıdır.