

Gradyan inişi
Önkoşul:Kısmi türev ve gradyan
Kanca
Gözlerin kapalıyken bir vadinin en dibini bulmaya çalışsan, ne yaparsın? Muhtemelen: “ayaklarımın altındaki eğimi hisset, aşağı doğru bir adım at, tekrarla.”
Sezgi
Gradyan inişi, tam olarak budur: 11. dersteki gradyanın tersi yönünde küçük adımlar atarak, bir fonksiyonun (genelde bir “kayıp” fonksiyonunun) en küçük olduğu noktayı aramaktır. Adım büyüklüğüne (öğrenme oranına) göre, bu arayış hızlı, yavaş ya da başarısız olabilir.
Mekanizma
fonksiyonunun en küçük olduğu değerini, adım adım arayalım:
Gradyan inişi: gradyanın tersi yönünde adım at
# Gradyan inişi: 11. dersteki gradyanın tam tersi yönünde küçük adımlar atarak,
# bir fonksiyonun en küçük olduğu noktayı aramaktır.
HEDEF = 3.0     # kaybı sıfırlayan "doğru" parametre değeri
BASLANGIC = -4.0

def kayip(w):
    return (w - HEDEF) ** 2

def gradyan(w):
    return 2 * (w - HEDEF)  # 9. dersteki türev kuralı: (w-hedef)^2'nin türevi

ogrenme_orani = 0.1
w = BASLANGIC
print(f"Başlangıç: w = {w}, kayıp = {kayip(w):.4f}")
print(f"Güncelleme kuralı: w_yeni = w - {ogrenme_orani} * gradyan(w)\n")

for adim in range(1, 6):
    g = gradyan(w)
    w = w - ogrenme_orani * g
    print(f"Adım {adim}: gradyan={g:.4f}, w={w:.4f}, kayıp={kayip(w):.4f}")

print(f"\nHer adımda w, hedef'e ({HEDEF}) biraz daha yaklaşıyor -- çünkü gradyanın")
print("tersi yönünde (kaybı azaltan yönde) hareket ediyoruz.")
Başlangıç: w = -4.0, kayıp = 49.0000
Güncelleme kuralı: w_yeni = w - 0.1 * gradyan(w)
Adım 1: gradyan=-14.0000, w=-2.6000, kayıp=31.3600
Adım 2: gradyan=-11.2000, w=-1.4800, kayıp=20.0704
Adım 3: gradyan=-8.9600, w=-0.5840, kayıp=12.8451
Adım 4: gradyan=-7.1680, w=0.1328, kayıp=8.2208
Adım 5: gradyan=-5.7344, w=0.7062, kayıp=5.2613
Her adımda w, hedef'e (3.0) biraz daha yaklaşıyor -- çünkü gradyanın
tersi yönünde (kaybı azaltan yönde) hareket ediyoruz.Matematik
Gradyan inişi güncelleme kuralı
Burada (alfa) öğrenme oranıdır — her adımda ne kadar büyük bir hareket yapılacağını belirler. ise, o noktadaki gradyandır (11. ders).
Kod
Daha fazla adımla, gerçekten hedefe ulaşıyor muyuz? Ve öğrenme oranı sonucu nasıl değiştiriyor?
40 adım sonra: hedefe neredeyse tam ulaşma
# Daha fazla adım atınca, w hedef'e ne kadar yaklaşıyor?
def gradyan_inisi_calistir(baslangic, oran, adim_sayisi):
    w = baslangic
    patika = [w]
    for _ in range(adim_sayisi):
        w = w - oran * gradyan(w)
        patika.append(w)
    return patika

patika_40 = gradyan_inisi_calistir(BASLANGIC, 0.1, 40)
print(f"\n40 adım sonra: w = {patika_40[-1]:.6f}  (hedef: {HEDEF})")
print(f"Hedefe uzaklık: {abs(patika_40[-1] - HEDEF):.6f}")
print(f"Kayıp: {kayip(patika_40[-1]):.8f}  (neredeyse sıfır)")
40 adım sonra: w = 2.999070  (hedef: 3.0)
Hedefe uzaklık: 0.000930
Kayıp: 0.00000087  (neredeyse sıfır)
Öğrenme oranı: çok küçük yavaş, çok büyük ıraksar
# Öğrenme oranı (adım büyüklüğü), gradyan inişinin yakınsayıp yakınsamayacağını
# belirler -- her adımda hata, |1 - 2*oran| katsayısıyla çarpılır (bu fonksiyon
# için). Bu katsayı 1'den küçükse yakınsar, büyükse ıraksar.
for oran in [0.05, 0.5, 1.1]:
    patika = gradyan_inisi_calistir(BASLANGIC, oran, 10)
    son_w = patika[-1]
    katsayi = abs(1 - 2 * oran)
    durum = "YAKINSIYOR (yavaş olsa da hata küçülüyor)" if katsayi < 1 else "IRAKSIYOR (hata büyüyor)"
    print(f"\nÖğrenme oranı={oran}: |1-2*oran|={katsayi:.2f} -- {durum}")
    print(f"  10 adım sonra w={son_w:.4f}  (hedef: {HEDEF})")
    print(f"  İlk 4 adım: {[f'{x:.2f}' for x in patika[:5]]}")

print("\nÇok küçük öğrenme oranı (0.05): katsayı 0.90 (<1) -- yavaş ama güvenli yakınsama.")
print("Makul öğrenme oranı (0.5): katsayı 0.00 (<1) -- tek adımda hedefe ulaşıyor.")
print("Çok büyük öğrenme oranı (1.1): katsayı 1.20 (>1) -- adımlar hedefin etrafında büyüyerek sekiyor, ıraksıyor.")
Öğrenme oranı=0.05: |1-2*oran|=0.90 -- YAKINSIYOR (yavaş olsa da hata küçülüyor)
10 adım sonra w=0.5593 (hedef: 3.0)
İlk 4 adım: ['-4.00', '-3.30', '-2.67', '-2.10', '-1.59']
Öğrenme oranı=0.5: |1-2*oran|=0.00 -- YAKINSIYOR (yavaş olsa da hata küçülüyor)
10 adım sonra w=3.0000 (hedef: 3.0)
İlk 4 adım: ['-4.00', '3.00', '3.00', '3.00', '3.00']
Öğrenme oranı=1.1: |1-2*oran|=1.20 -- IRAKSIYOR (hata büyüyor)
10 adım sonra w=-40.3422 (hedef: 3.0)
İlk 4 adım: ['-4.00', '11.40', '-7.08', '15.10', '-11.52']
Çok küçük öğrenme oranı (0.05): katsayı 0.90 (<1) -- yavaş ama güvenli yakınsama.
Makul öğrenme oranı (0.5): katsayı 0.00 (<1) -- tek adımda hedefe ulaşıyor.
Çok büyük öğrenme oranı (1.1): katsayı 1.20 (>1) -- adımlar hedefin etrafında büyüyerek sekiyor, ıraksıyor.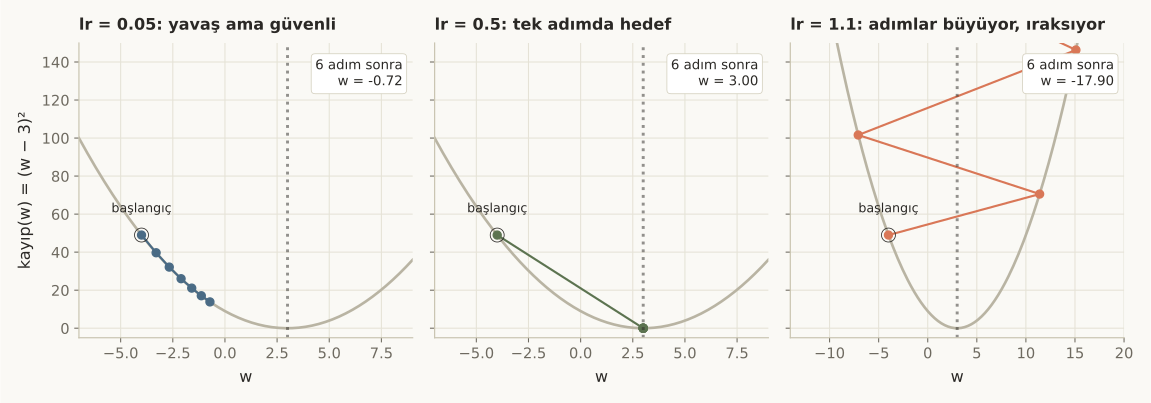 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Gradyan inişi, pratikte tüm model eğitiminin temel algoritmasıdır:
- Makine Öğrenmesi kategorisindeki GradyanİnişiDemo bileşeni, tam olarak bu dersteki hesabı, görsel bir kayıp yüzeyinde canlı gösterir.
- DL Görüntü ve DL NLP kategorilerinde, milyonlarca parametreli bir ağın “eğitilmesi”, bu dersteki tek-parametreli örneğin, her parametre için aynı anda tekrarlanmasıdır.
- Öğrenme oranı seçimi, pratikte, bir modelin eğitiminde en kritik “ayar düğmelerinden” biridir — bu ders nedenini gösterdi.
Bu 2 hatayı yaparsın:
- “Daha büyük öğrenme oranı, her zaman daha hızlı sonuç verir” sanmak — hayır, notebook’ta öğrenme oranı=1.1 ıraksadı; çok büyük adımlar, hedefi aşıp geçer ve uzaklaşabilir.
- Gradyan inişini “her zaman global en küçüğü bulur” sanmak — bu ders basit bir tek-çukurlu (konveks) fonksiyon kullandı; daha karmaşık fonksiyonlarda gradyan inişi yerel bir çukura sıkışabilir.
Kendini test et
1. guncelleme-kurali bloğunda w, her adımda hedef'e (3.0) biraz daha yaklaşıyor. Bu yaklaşma nasıl sağlanıyor?
- Rastgele bir sayı eklenerek
- Her adımda, gradyanın tersi yönünde (w = w - öğrenme_oranı * gradyan) küçük bir hareket yapılarak -- gradyan pozitifse w azaltılıyor, negatifse w artırılıyor (doğru cevap)
- w her zaman sıfırlanarak
- Hedef değeri her adımda değiştirilerek
Neden: guncelleme-kurali bloğunda güncelleme kuralı açıkça gösteriliyor: w_yeni = w - öğrenme_oranı * gradyan(w).
2. ogrenme-orani-karsilastirma bloğunda öğrenme oranı=1.1 için w, 10 adım sonra -40.34'e ulaşıyor (başlangıç -4'ten bile uzak). Bu neyi gösteriyor?
- Bir hesaplama hatası
- Çok büyük bir öğrenme oranının, adımların hedefin etrafında giderek büyüyerek sekmesine (ıraksamasına) yol açabileceğini -- |1-2*1.1|=1.20>1 olduğu için hata her adımda büyüyor (doğru cevap)
- Hedefin yanlış seçildiğini
- Gradyanın hesaplanamadığını
Neden: ogrenme-orani-karsilastirma bloğunda bu açıkça belirtiliyor: katsayı=1.20 (>1) olduğu için 'ıraksıyor (hata büyüyor)'.
3. Makine Öğrenmesi kategorisindeki GradyanİnişiDemo bileşeninde gördüğün 'adımlar', bu dersteki hangi hesapla ilişkilidir?
- Hiçbir ilişkisi yoktur
- Tam olarak aynı hesaptır -- w_yeni = w - öğrenme_oranı * gradyan(w) güncelleme kuralı, o bileşende görsel bir kayıp yüzeyinde canlı gösterilir (doğru cevap)
- O bileşen sadece rastgele adımlar atar
- O bileşen türev kullanmaz
Neden: kullanım bölümünde bu açıkça bağlanıyor: GradyanİnişiDemo, bu dersteki hesabı görsel bir kayıp yüzeyinde canlı gösterir.
Özet
Özet
- Gradyan inişi, gradyanın tersi yönünde küçük adımlar atarak bir fonksiyonun en küçük olduğu noktayı arar.
- Güncelleme kuralı: w_yeni = w - öğrenme_oranı * gradyan(w).
- Bu dersteki örnekte 40 adım sonra w, hedefe (3.0) neredeyse tam ulaştı (kayıp neredeyse sıfır).
- Öğrenme oranı çok küçükse yavaş ama güvenli, çok büyükse (bu fonksiyon için >1) ıraksar.
- Bu, Makine Öğrenmesi kategorisindeki GradyanİnişiDemo bileşeninin ve tüm derin öğrenme eğitiminin temel algoritmasıdır.