

Logaritma ve üstel: neden her yerdeler
Önkoşul:Gradyan inişi
Kanca
Bir söylenti, her saat sadece 2 kişiye daha yayılsa, 10 saat sonra 1024 kişiye ulaşır. Peki 20 saat sonra kaç kişiye ulaşır — 2048 mi, yoksa başka bir şey mi?
Sezgi
Üstel (exponential) fonksiyon, bir şeyin her adımda aynı oranda katlanarak büyümesini (ya da küçülmesini) anlatır — ilk başta yavaş görünür ama hızla patlar. Logaritma ise, üstelin tam tersidir: “kaçıncı adımda bu sayıya ulaşırım?” sorusunu cevaplar.
Mekanizma
Katlanarak yayılan bir söylentiyi izleyelim:
Üstel büyüme: yavaş başlar, hızla patlar
# Üstel (exponential) fonksiyon, bir şeyin her adımda aynı oranda katlanarak
# büyümesini (ya da küçülmesini) anlatır. Örnek: bir söylenti, her saatte
# 2 kişiye daha yayılıyor olsun (katlanarak).
def ustel_yayilma(saat):
    return 2 ** saat

print("Saat  ->  Duyan kişi sayısı (2^saat)")
for saat in [0, 1, 2, 5, 10, 20]:
    print(f"  {saat:3d}   ->  {ustel_yayilma(saat):,}")

print("\nİlk 10 saatte sadece 1024 kişiye ulaşırken, 20. saatte bir milyonu aşıyor --")
print("üstel büyüme, ilk başta yavaş görünür ama hızla patlar.")
Saat -> Duyan kişi sayısı (2^saat)
0 -> 1
1 -> 2
2 -> 4
5 -> 32
10 -> 1,024
20 -> 1,048,576
İlk 10 saatte sadece 1024 kişiye ulaşırken, 20. saatte bir milyonu aşıyor --
üstel büyüme, ilk başta yavaş görünür ama hızla patlar.Şimdi bunun tersini soralım: “2 üzeri kaç, 1024 eder?”
Logaritma = üstelin tersi
# Logaritma, üstel fonksiyonun tersidir: "kaçıncı adımda bu sayıya ulaşırım?"
# sorusunu cevaplar.
sayi = 1024
kacinci_adim = np.log2(sayi)
print(f"\n2 üzeri kaç, {sayi} eder? log2({sayi}) = {kacinci_adim}")
print(f"Doğrulama: 2^{kacinci_adim:.0f} = {2**int(kacinci_adim)}")

# Genel olarak: log(exp(x)) = x ve exp(log(x)) = x -- birbirinin tam tersidir.
x_test = 5.0
print(f"\nlog(exp({x_test})) = {np.log(np.exp(x_test)):.4f}  (x'e geri dönüyor)")
print(f"exp(log({x_test})) = {np.exp(np.log(x_test)):.4f}  (x'e geri dönüyor)")
print("Logaritma ve üstel, birbirini iptal eden iki işlemdir -- tıpkı toplama/çıkarma gibi.")
2 üzeri kaç, 1024 eder? log2(1024) = 10.0
Doğrulama: 2^10 = 1024

log(exp(5.0)) = 5.0000  (x'e geri dönüyor)
exp(log(5.0)) = 5.0000  (x'e geri dönüyor)
Logaritma ve üstel, birbirini iptal eden iki işlemdir -- tıpkı toplama/çıkarma gibi.
Matematik
Logaritmanın çarpmayı toplamaya çevirme özelliği
Bu özellik, logaritmanın ML’deki en pratik faydasının kaynağıdır: küçük olasılıkların çarpımı yerine, logaritmalarının toplamını almak, sayısal olarak çok daha kararlıdır.
Kod
Bunu gerçek bir sayısal sorunla gösterelim — küçük olasılıkları doğrudan çarpmak ne olur?
Çarpım sıfıra yuvarlanır, log-toplamı yuvarlanmaz
# Logaritmanın ML'de en önemli pratik faydası: çarpmayı toplamaya çevirmesi --
# log(a*b) = log(a) + log(b). Bu, sayısal kararlılık için kritiktir.
olasiliklar = np.full(400, 0.01)  # 400 tane küçük olasılık (örn. bir dilin kelime olasılıkları)

carpim_dogrudan = np.prod(olasiliklar)
print(f"\n400 tane 0.01 olasılığı doğrudan çarpınca: {carpim_dogrudan}")
print("Bu sıfıra yuvarlandı (float64'ün gösterebileceğinden daha küçük oldu) --")
print("bu, 'sayısal alt taşma' (underflow) denen bir sorundur.")

log_toplami = np.sum(np.log(olasiliklar))
print(f"\nAynı 400 olasılığın logaritmalarını toplayınca: {log_toplami:.4f}")
print("Bu sayı, gayet normal ve kullanılabilir bir sayı -- hiç alt taşma yok.")
print("\nİşte bu yüzden, ML modelleri (ve NLP kategorisindeki dil modelleri), olasılıkları")
print("doğrudan çarpmak yerine, logaritmalarını toplar -- 'log-olasılık' (log-likelihood).")
400 tane 0.01 olasılığı doğrudan çarpınca: 0.0
Bu sıfıra yuvarlandı (float64'ün gösterebileceğinden daha küçük oldu) --
bu, 'sayısal alt taşma' (underflow) denen bir sorundur.
Aynı 400 olasılığın logaritmalarını toplayınca: -1842.0681
Bu sayı, gayet normal ve kullanılabilir bir sayı -- hiç alt taşma yok.
İşte bu yüzden, ML modelleri (ve NLP kategorisindeki dil modelleri), olasılıkları
doğrudan çarpmak yerine, logaritmalarını toplar -- 'log-olasılık' (log-likelihood).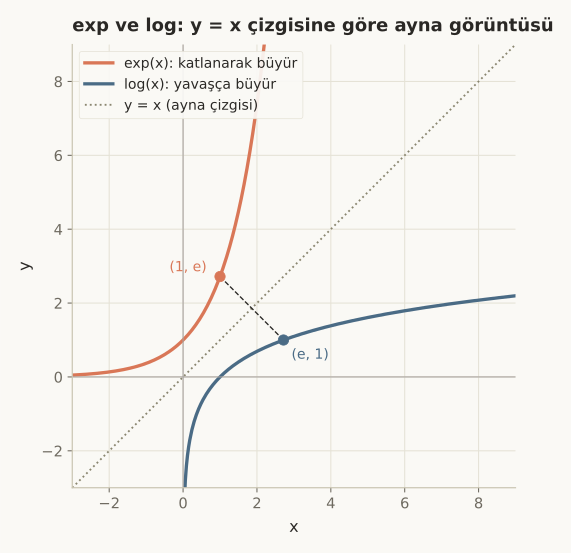 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Logaritma ve üstel, kursun daha önce gördüğün birçok formülün içinde saklıydı:
- Prompt Mühendisliği kategorisindeki softmax, üstel (exp) fonksiyonunu kullanarak, sayıları pozitif ve karşılaştırılabilir olasılıklara çevirir.
- ML ve DL kategorilerindeki “çapraz entropi” (cross-entropy) kaybı, logaritma kullanır — tam olarak bu dersteki “log-olasılık” fikri.
- Bu dersteki 400-olasılık örneği, dil modellerinin (NLP kategorisi) neden olasılıkları doğrudan çarpmak yerine, logaritmalarını topladığını gösteriyor.
Bu 2 hatayı yaparsın:
- Üstel büyümeyi “doğrusal büyümenin biraz hızlısı” sanmak — hayır, notebook’ta 10. saatte 1024 iken 20. saatte 1 milyonu aşıyor; üstel büyüme niteliksel olarak farklıdır.
- Logaritmayı “sadece matematik dersi konusu” sanmak — hayır, ML modellerinin sayısal olarak çökmeden çalışabilmesinin arkasındaki pratik araçtır.
Kendini test et
1. ustel-buyume-tanimi bloğunda 10. saatte 1024 kişi varken, 20. saatte sadece 2048 değil, 1,048,576 kişiye ulaşılıyor. Bu neden?
- Bir hesaplama hatası
- Üstel büyüme, her adımda aynı oranda (burada 2 katına) katlanır -- bu yüzden büyüme doğrusal değil, katlanaraktır; 10 adım daha eklemek, sayıyı 2^10=1024 katına çıkarır (doğru cevap)
- Söylenti yayılması durur ve sonra tekrar başlar
- 20. saat özel bir sayıdır
Neden: ustel-buyume-tanimi bloğunda bu açıkça belirtiliyor: 'üstel büyüme, ilk başta yavaş görünür ama hızla patlar'.
2. neden-log-kullanilir bloğunda 400 tane 0.01 olasılığı doğrudan çarpınca sıfır çıkıyor, ama logaritmalarını toplayınca -1842.07 (normal bir sayı) çıkıyor. Bu fark neden?
- Logaritma toplamı yanlış hesaplanmıştır
- float64 sayı tipi, çok küçük sayıları (400 tane 0.01'in çarpımı gibi) temsil edemez ve sıfıra yuvarlar (alt taşma) -- ama logaritmaları toplamak, aynı bilgiyi sayısal olarak kararlı bir sayıda saklar (doğru cevap)
- 0.01 sayısı özel bir durumdur
- NumPy bir hata vermelidir ama vermiyor
Neden: neden-log-kullanilir bloğunda bu açıkça belirtiliyor: doğrudan çarpım 0.0'a yuvarlanıyor ('sayısal alt taşma'), log-toplamı ise -1842.07 gibi kullanılabilir bir sayı veriyor.
3. ML ve DL kategorilerindeki 'çapraz entropi' (cross-entropy) kaybının logaritma kullanmasının pratik nedeni nedir?
- Sadece matematiksel gelenek
- Bir modelin tahmin olasılıklarını doğrudan çarpmak yerine logaritmalarını toplamak, bu dersteki 400-olasılık örneğindeki gibi, sayısal alt taşmayı önler (doğru cevap)
- Logaritma, hesaplamayı yavaşlatmak için kullanılır
- Çapraz entropi logaritma kullanmaz
Neden: kullanım bölümünde bu açıkça bağlanıyor: çapraz entropi kaybı, bu dersteki 'log-olasılık' fikrini kullanır.
Özet
Özet
- Üstel fonksiyon, katlanarak büyümeyi (ya da küçülmeyi) anlatır -- ilk başta yavaş, sonra hızla patlar.
- Logaritma, üstelin tam tersidir: log(exp(x))=x ve exp(log(x))=x.
- Logaritmanın en pratik faydası: log(a·b) = log(a) + log(b) -- çarpmayı toplamaya çevirir.
- Bu dersteki 400-olasılık örneği, doğrudan çarpımın sıfıra yuvarlandığını (alt taşma), log-toplamının ise kararlı kaldığını gösterdi.
- Softmax (exp) ve çapraz entropi (log), bu dersteki fikirlerin, kursun ilerideki kategorilerindeki doğrudan uygulamalarıdır.