

Bağlam penceresi, token ve maliyet
Önkoşul:Prompt nedir, model ne "görüyor"
Kanca
Uzun bir sohbetin ortasında, model birdenbire konuşmanın başında ne konuştuğunu “unutuyormuş” gibi davranabilir. Bu bir hata değil — 1. derste gördüğümüz token dizisinin, gerçekten sınırlı bir “bağlam penceresine” sığması gerekiyor.
Sezgi
Her model, bir seferde işleyebileceği maksimum token sayısına (bağlam penceresi) sahiptir. Bu pencere dolunca, en eski mesajlar sessizce düşer — model onları bir daha görmez. Aşağıda öğretici amaçlı küçük bir pencereyle (100 token), bir sohbetin adım adım nasıl dolduğunu ve neyin düştüğünü izle:
Pencerede 42 / 100 token
Şimdiye kadarki kümülatif girdi maliyeti: $0.000000(Sonnet 5, 1M girdi token = $2, Eylül 2026)
Mekanizma
Önce 1. dersteki aynı tokenizer’ı kullanarak, gerçek bir sohbetin her mesajının kaç token olduğunu sayalım:
Bir sohbetteki her mesajın gerçek token sayısı
# Bir sohbet uzadıkça, her mesajın gerçek token sayısını hesaplayalım.
KONUSMA = [
    ("system", "Sen yardımcı bir müşteri hizmetleri asistanısın."),
    ("user", "Merhaba, siparişim nerede?"),
    ("assistant", "Merhaba! Sipariş numaranızı paylaşabilir misiniz?"),
    ("user", "12345"),
    ("assistant", "Teşekkürler, hemen kontrol ediyorum."),
    ("user", "Ne kadar sürer?"),
    ("assistant", "Birkaç dakika içinde size bilgi vereceğim."),
    ("user", "Tamam, bekliyorum."),
    ("assistant", "Siparişiniz kargoya verildi, yarın elinizde olur."),
    ("user", "Harika, teşekkürler!"),
]

token_sayilari = [mesaj_token_sayisi(mesaj) for _, mesaj in KONUSMA]
print(f"{'Rol':<12} {'Token':<8} Mesaj")
for (rol, mesaj), t in zip(KONUSMA, token_sayilari):
    print(f"{rol:<12} {t:<8} {mesaj}")
print(f"\nToplam (10 mesaj): {sum(token_sayilari)} token.")
Rol Token Mesaj
system 42 Sen yardımcı bir müşteri hizmetleri asistanısın.
user 22 Merhaba, siparişim nerede?
assistant 38 Merhaba! Sipariş numaranızı paylaşabilir misiniz?
user 6 12345
assistant 30 Teşekkürler, hemen kontrol ediyorum.
user 13 Ne kadar sürer?
assistant 38 Birkaç dakika içinde size bilgi vereceğim.
user 15 Tamam, bekliyorum.
assistant 41 Siparişiniz kargoya verildi, yarın elinizde olur.
user 19 Harika, teşekkürler!
Toplam (10 mesaj): 264 token.Şimdi bu sohbeti, küçük bir pencereden (100 token) geçirelim:
Pencere dolunca, en eski mesajlar düşer
# Gerçek modellerin bir "bağlam penceresi" (context window) sınırı var -- ötesi
# hatırlanmaz. Öğretici amaçlı küçük bir pencere (100 token) ile simüle edelim:
# sistem mesajı sabit kalır, en eski user/assistant mesajları pencere dolunca düşer.
PENCERE_LIMITI = 100

def pencereyi_guncelle(pencere, yeni_indeks, token_sayilari, konusma):
    pencere.append(yeni_indeks)
    while sum(token_sayilari[i] for i in pencere) > PENCERE_LIMITI:
        # Sistem mesajı hariç, en eski mesajı düşür.
        dusecek = next(i for i in pencere if konusma[i][0] != "system")
        pencere.remove(dusecek)
    return pencere

pencere = [0]  # sistem mesajı en baştan pencerede
print(f"\nBağlam penceresi limiti: {PENCERE_LIMITI} token (öğretici amaçlı küçük tutuldu)\n")
for i in range(1, len(KONUSMA)):
    pencere = pencereyi_guncelle(pencere, i, token_sayilari, KONUSMA)
    pencere_toplami = sum(token_sayilari[j] for j in pencere)
    pencerede_olanlar = [KONUSMA[j][0] for j in sorted(pencere)]
    print(f"Mesaj {i} eklendi -- pencerede {len(pencere)} mesaj, {pencere_toplami} token: {pencerede_olanlar}")

dusenler = [i for i in range(len(KONUSMA)) if i not in pencere]
print(f"\nPencereden tamamen düşen mesajlar (indeks): {dusenler}")
print("Sistem mesajı hiçbir zaman düşmedi -- ama en eski user/assistant mesajları, pencere")
print("dolunca sessizce unutuluyor. Model, konuşmanın başında ne konuşulduğunu artık 'hatırlamıyor'.")
Bağlam penceresi limiti: 100 token (öğretici amaçlı küçük tutuldu)

Mesaj 1 eklendi -- pencerede 2 mesaj, 64 token: ['system', 'user']
Mesaj 2 eklendi -- pencerede 2 mesaj, 80 token: ['system', 'assistant']
Mesaj 3 eklendi -- pencerede 3 mesaj, 86 token: ['system', 'assistant', 'user']
Mesaj 4 eklendi -- pencerede 3 mesaj, 78 token: ['system', 'user', 'assistant']
Mesaj 5 eklendi -- pencerede 4 mesaj, 91 token: ['system', 'user', 'assistant', 'user']
Mesaj 6 eklendi -- pencerede 3 mesaj, 93 token: ['system', 'user', 'assistant']
Mesaj 7 eklendi -- pencerede 3 mesaj, 95 token: ['system', 'assistant', 'user']
Mesaj 8 eklendi -- pencerede 3 mesaj, 98 token: ['system', 'user', 'assistant']
Mesaj 9 eklendi -- pencerede 2 mesaj, 61 token: ['system', 'user']

Pencereden tamamen düşen mesajlar (indeks): [1, 2, 3, 4, 5, 6, 7, 8]
Sistem mesajı hiçbir zaman düşmedi -- ama en eski user/assistant mesajları, pencere
dolunca sessizce unutuluyor. Model, konuşmanın başında ne konuşulduğunu artık 'hatırlamıyor'.
10 mesajlık bir sohbette, sistem mesajı dışında 8 mesaj tamamen unutuldu — sadece sistem talimatı ve en son mesaj pencerede kaldı.
Matematik
Neden maliyet karesel büyür
Bir sohbet API’si “hafızasızdır” (stateless): her yeni cevap için, o ana kadarki tüm geçmiş girdi olarak yeniden gönderilir.
mesaj sayısı, her mesajın token sayısı, ortalama mesaj uzunluğudur. Mesaj sayısı arttıkça, toplam girdi token’ı ile değil, ile büyür — bu yüzden uzun sohbetler, mesaj başına orantısız derecede pahalı hâle gelir.
Kod
Bunu gerçek, güncel bir fiyatla hesaplayalım:
Her tur, tüm geçmişi yeniden gönderir
# Gerçek bir sohbet API'sinde, her yeni mesaj için tüm önceki geçmiş tekrar gönderilir
# (girdi olarak) -- bu yüzden toplam maliyet, mesaj sayısıyla doğrusal değil, yaklaşık
# karesel büyür. Fiyat: Claude Sonnet 5, Eylül 2026 itibarıyla, 1M girdi token'ı için $2
# (kaynak: finout.io, Eylül 2026 fiyatlandırma özeti).
GIRDI_FIYATI_1M = 2.0  # $ / 1.000.000 girdi token'ı (Sonnet 5, Eylül 2026)

kumulatif_girdi_token = 0
toplam_maliyet_dolar = 0.0
print(f"\n{'API çağrısı':<14} {'Bu çağrının girdisi (token)':<30} {'Kümülatif maliyet ($)':<22}")
for i in range(1, len(KONUSMA)):
    if KONUSMA[i][0] != "assistant":
        continue
    # Bu assistant cevabını üretmek için, i'ye kadar olan tüm mesajlar girdi olarak gönderilir.
    bu_cagri_girdisi = sum(token_sayilari[:i])
    kumulatif_girdi_token += bu_cagri_girdisi
    maliyet = kumulatif_girdi_token / 1_000_000 * GIRDI_FIYATI_1M
    print(f"{i:<14} {bu_cagri_girdisi:<30} {maliyet:<22.6f}")

print(f"\n5 asistan cevabı için toplam kümülatif girdi maliyeti: ${maliyet:.6f}")
print("Bu sohbet kısa olduğu için mutlak rakam küçük -- ama örüntüye dikkat: her yeni tur,")
print("tüm geçmişi yeniden gönderir. 100 turluk bir sohbette bu, mesaj başına maliyetin")
print("doğrusal değil, yaklaşık karesel büyümesi demektir.")
API çağrısı Bu çağrının girdisi (token) Kümülatif maliyet ($)
2 64 0.000128
4 108 0.000344
6 151 0.000646
8 204 0.001054
5 asistan cevabı için toplam kümülatif girdi maliyeti: $0.001054
Bu sohbet kısa olduğu için mutlak rakam küçük -- ama örüntüye dikkat: her yeni tur,
tüm geçmişi yeniden gönderir. 100 turluk bir sohbette bu, mesaj başına maliyetin
doğrusal değil, yaklaşık karesel büyümesi demektir.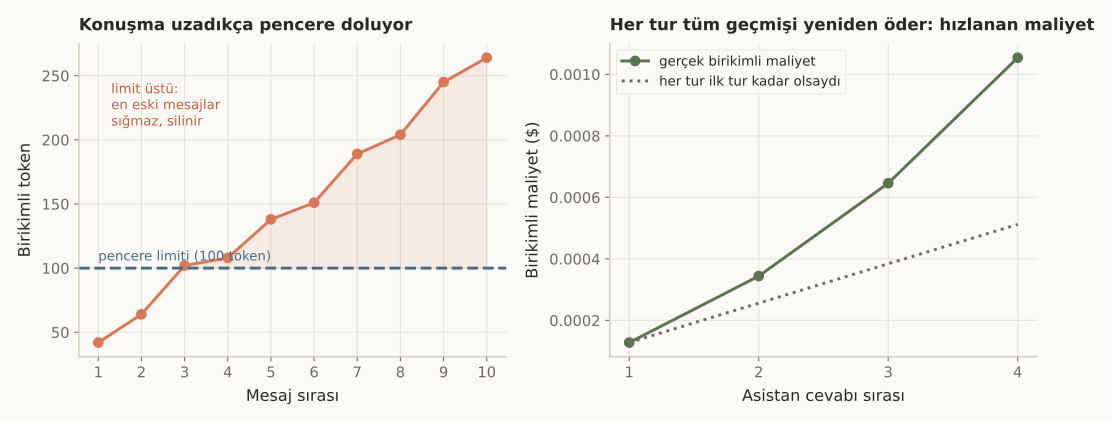 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bağlam penceresi yönetimi, pratikte günlük bir mühendislik kararıdır:
- Uzun sohbetlerde, geçmişi özetleyip (summarize) sıkıştırmak yaygın bir teknik — tüm geçmişi ham hâliyle taşımak yerine, önemli noktaları kısa bir özete indirger.
- Sistem mesajı genelde sabit tutulur (bu dersteki simülasyonda olduğu gibi) — talimatların her turda unutulmaması için.
- RAG (11. ders), bağlam penceresi sorununa kısmen bir çözümdür — ilgili bilgiyi, tüm geçmişi taşımak yerine, ihtiyaç anında arayıp ekler.
Bu 2 hatayı yaparsın:
- Bağlam penceresinin “sonsuz hafıza” olduğunu varsaymak — hayır, pencere dolunca, en eski bilgi sessizce (hatasız görünen ama yanlış bir şekilde) kaybolur.
- Uzun bir sohbetin maliyetinin mesaj sayısıyla doğrusal arttığını sanmak — her yeni mesaj, tüm geçmişi yeniden gönderdiği için büyüme yaklaşık kareseldir.
Kendini test et
1. Notebook'ta 100 token'lık pencerede, 10 mesajlık sohbetin 8 mesajı tamamen düşüyor. Bu neden oluyor?
- Bir hata nedeniyle
- Bağlam penceresi sınırlı olduğu için, yeni bir mesaj eklendiğinde ve toplam token limiti aştığında, sistem mesajı hariç en eski mesajlar sırayla düşürülüyor -- pencere sadece son birkaç mesajı tutabiliyor (doğru cevap)
- Sistem tüm mesajları rastgele siliyor
- Kullanıcı mesajları her zaman öncelikli olarak silinir
Neden: baglam-penceresi-doluyor bloğunda pencereyi_guncelle fonksiyonu, toplam token PENCERE_LIMITI'ni aşınca sistem mesajı hariç en eski mesajı düşürüyor -- 8 mesajın (indeks 1-8) tamamen düşmesi bunun sonucu.
2. Bir sohbet API'sinde maliyetin mesaj sayısıyla yaklaşık karesel büyümesinin nedeni nedir?
- API sağlayıcıları fiyatı kasten yükseltiyor
- API 'hafızasız' (stateless) olduğu için, her yeni cevap üretilirken tüm önceki geçmiş girdi olarak yeniden gönderilir -- bu yüzden N. mesajın maliyeti, önceki N-1 mesajın tamamını da içerir (doğru cevap)
- Her mesaj otomatik olarak 2 katına çıkar
- Sadece uzun mesajlarda karesel büyüme görülür
Neden: maliyet-buyumesi bloğunda her API çağrısının girdisi, o ana kadarki tüm mesajların toplamı (sum(token_sayilari[:i])) -- MathBox'taki toplam girdi formülü bu tekrarlı gönderimin neden N² ile ölçeklendiğini gösteriyor.
3. Sistem mesajının bağlam penceresi dolduğunda düşmemesi neden önemlidir?
- Önemli değildir, sistem mesajı da düşebilir
- Sistem mesajı modelin temel talimatlarını (rol, kısıtlar, ton) taşır -- eğer o da düşerse, model konuşmanın ortasında aniden farklı bir 'kişiliğe' bürünmüş gibi davranabilir (doğru cevap)
- Sistem mesajı zaten çok kısadır, bu yüzden önemi yoktur
- Sistem mesajı sadece dekoratif amaçlıdır
Neden: baglam-penceresi-doluyor bloğunda pencereyi_guncelle fonksiyonu açıkça sistem mesajını korumak için tasarlandı (dusecek = next(i for i in pencere if konusma[i][0] != 'system')) -- bu, gerçek sistemlerde yaygın bir tasarım kararıdır.
Özet
Özet
- Her model, sabit bir bağlam penceresi (maksimum token) sınırına sahiptir.
- Pencere dolunca, en eski mesajlar (genelde sistem mesajı hariç) sessizce düşer -- model onları bir daha görmez.
- Sohbet API'leri hafızasızdır: her yeni cevap için tüm geçmiş yeniden gönderilir.
- Bu yüzden uzun bir sohbetin toplam maliyeti, mesaj sayısıyla doğrusal değil yaklaşık karesel büyür.
- Özetleme ve RAG (11. ders) gibi teknikler, bu pencere sınırını yönetmek için kullanılır.