

Örnekle öğretme (few-shot)
Önkoşul:Rol ve persona verme
Kanca
Bir göreve kural yazmak yerine, birkaç örnek göstersen ne olur? “Bu incelemeyi olumlu/olumsuz diye etiketle” demek yerine, üç örnek incelemeyi etiketleriyle birlikte göstersen?
Sezgi
“Few-shot” prompting, görevi yazılı kurallarla açıklamak yerine, birkaç (girdi, çıktı) örneği göstermektir — model, bu örneklerden görevin kuralını kendisi çıkarsar. Bu, 5. kategoride (NLP & LLM, 20. ders) gördüğümüz gerçek bir bulgunun doğrudan bir uzantısıdır.
Mekanizma
Aynı sınıflandırma görevini, zero-shot (sıfır örnek) ve 3-shot (üç örnek) olarak karşılaştıralım:
Zero-shot vs 3-shot: aynı görev, farklı öğretim yöntemi
# "Few-shot" (örnekle öğretme): göreve ait kuralı yazılı olarak açıklamak yerine,
# birkaç (girdi, çıktı) örneği göstermek -- model, örüntüyü çıkarsar.
ZERO_SHOT = "Classify the sentiment of this review as positive or negative: The food was cold and the service was slow."
FEW_SHOT = """Classify the sentiment of each review as positive or negative.
Review: The staff were friendly and the food was delicious. Sentiment: positive
Review: I waited an hour and the order was wrong. Sentiment: negative
Review: Best meal I have had all year, highly recommend. Sentiment: positive
Review: The food was cold and the service was slow. Sentiment:"""

t_zero = mesaj_token_sayisi(ZERO_SHOT)
t_few = mesaj_token_sayisi(FEW_SHOT)

print(f"Zero-shot ({t_zero} token):\n  {ZERO_SHOT}")
print(f"\n3-shot ({t_few} token):\n{FEW_SHOT}")
print(f"\n3 örnek eklemek, maliyeti {t_few/t_zero:.1f}x artırdı -- ama görev tanımı hiç")
print("değişmedi. Fark: model, 'sentiment nedir, nasıl etiketlenir' kuralını yazılı bir")
print("açıklamadan değil, üç somut örnekten çıkarsamak zorunda.")
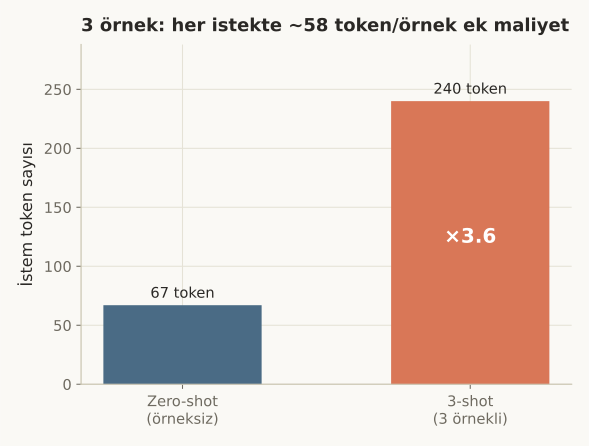
Zero-shot (67 token):
Classify the sentiment of this review as positive or negative: The food was cold and the service was slow.
3-shot (240 token):
Classify the sentiment of each review as positive or negative.
Review: The staff were friendly and the food was delicious. Sentiment: positive
Review: I waited an hour and the order was wrong. Sentiment: negative
Review: Best meal I have had all year, highly recommend. Sentiment: positive
Review: The food was cold and the service was slow. Sentiment:
3 örnek eklemek, maliyeti 3.6x artırdı -- ama görev tanımı hiç
değişmedi. Fark: model, 'sentiment nedir, nasıl etiketlenir' kuralını yazılı bir
açıklamadan değil, üç somut örnekten çıkarsamak zorunda.Matematik
Neden örnekler işe yarar: NLP kategorisinin 20. dersinden gerçek bir kanıt
Few-shot prompting’in neden çalıştığını, gerçekten eğitilmiş bir modelle zaten görmüştük:
NLP kategorisinin 20. dersindeki genelleme bulgusu, few-shot'un temelini açıklıyor
# 20. derste (NLP kategorisi) gerçek bir bulgu vardı: gradyan inişiyle eğitilen mini-GPT,
# 'ABCABC...' örüntüsünü gördükten sonra, hiç görmediği bağlam uzunluklarında bile
# (örn. tek başına 'C') doğru bir sonraki token'ı tahmin edebiliyordu -- örüntüyü genelledi,
# ezberlemedi. Few-shot prompting, aynı mekanizmadan yararlanır:
print("\n5. kategori (NLP & LLM), 20. ders bulgusu:")
print("  Model 'ABCABC...' dizisini gördükten sonra, hiç görmediği bir bağlamda ('C' tek başına)")
print("  bile doğru devamı ('A') tahmin etti -- spesifik diziyi değil, genel kuralı öğrenmişti.")
print("\nFew-shot prompting aynı ilkeye dayanır: birkaç (girdi->çıktı) örneği gördükten sonra,")
print("model bağlamdaki örüntüyü (görev kuralını) çıkarsar ve yeni bir girdiye uygular --")
print("bu, ayrı bir eğitim adımı olmadan, tek bir ileri geçişte (19. ders) gerçekleşir.")
5. kategori (NLP & LLM), 20. ders bulgusu:
  Model 'ABCABC...' dizisini gördükten sonra, hiç görmediği bir bağlamda ('C' tek başına)
  bile doğru devamı ('A') tahmin etti -- spesifik diziyi değil, genel kuralı öğrenmişti.

Few-shot prompting aynı ilkeye dayanır: birkaç (girdi->çıktı) örneği gördükten sonra,
model bağlamdaki örüntüyü (görev kuralını) çıkarsar ve yeni bir girdiye uygular --
bu, ayrı bir eğitim adımı olmadan, tek bir ileri geçişte (19. ders) gerçekleşir.
Kod
 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Few-shot prompting kullanırken dikkat edilmesi gereken pratik noktalar:
- Örnek sayısı arttıkça fayda azalır (diminishing returns) — genelde 2-5 örnek çoğu görev için yeterlidir; onlarca örnek eklemek, hem maliyeti artırır hem de her zaman orantılı bir iyileşme sağlamaz.
- Örneklerin sırası ve çeşitliliği önemlidir — sadece olumlu örnekler göstermek, modelin her şeyi “olumlu” etiketlemesine yol açabilir; dengeli bir karışım daha güvenilirdir.
- Few-shot, 4. dersteki persona gibi, modelin bilgi tabanını genişletmez — sadece görev formatını ve kriterlerini netleştirir; model hâlâ eğitiminde ne gördüyse onu bilir.
Bu 2 hatayı yaparsın:
- Few-shot’un her zaman zero-shot’tan daha iyi olduğunu düşünmek — basit, net görevlerde (2. dersteki gibi) zero-shot genelde yeterlidir ve daha ucuzdur.
- Tutarsız veya birbiriyle çelişen örnekler seçmek — model, örüntüyü çıkarsamaya çalışırken, tutarsız örnekler net bir kural bulmasını zorlaştırır.
Kendini test et
1. Few-shot prompting, zero-shot'tan (sıfır örnek) nasıl farklıdır?
- Few-shot, görevi tamamen farklı bir şeye dönüştürür
- Few-shot'ta görev kuralı, yazılı bir açıklama yerine birkaç (girdi, çıktı) örneğiyle gösterilir -- model, kuralı örneklerden çıkarsar; görev tanımı aynı kalır (doğru cevap)
- Few-shot, modelin eğitim verisini günceller
- Few-shot sadece görsel görevlerde kullanılır
Neden: zero-shot-vs-few-shot bloğunda hem ZERO_SHOT hem FEW_SHOT aynı sınıflandırma görevini soruyor -- fark, kuralın yazılı mı yoksa örneklerle mi iletildiğidir.
2. 5. kategorinin (NLP & LLM) 20. dersindeki hangi bulgu, few-shot prompting'in neden işe yaradığını açıklıyor?
- Modelin daha fazla parametreye sahip olması
- Eğitilen bir modelin, hiç görmediği bağlam uzunluklarında bile (örn. tek başına 'C') doğru tahmin yapabilmesi -- yani spesifik örnekleri ezberlemek yerine genel bir kuralı öğrenip yeni durumlara uygulayabilmesi (doğru cevap)
- Modelin internet erişimine sahip olması
- Modelin daha yavaş çalışması
Neden: neden-ise-yarar bloğu, NLP kategorisinin 20. dersindeki 'ABCABC...' genelleme bulgusunu açıkça few-shot'un temel mekanizması olarak gösteriyor: örüntüden kural çıkarsama, yeni girdilere uygulama.
3. Few-shot prompting'te sadece 'olumlu' etiketli örnekler göstermenin riski nedir?
- Hiçbir riski yoktur
- Model, gösterilen örüntüye (hepsi olumlu) dayanarak yeni girdileri de 'olumlu' etiketleme eğiliminde olabilir -- dengesiz örnekler, dengesiz bir çıkarsamaya yol açar (doğru cevap)
- Model bu durumda çalışmayı reddeder
- Sadece olumlu örnekler göstermek daha hızlı sonuç verir
Neden: Kullanım bölümünde açıkça belirtildiği gibi, örneklerin çeşitliliği önemlidir -- model örüntüyü çıkarsadığı için, gösterilen örneklerdeki dengesizlik doğrudan çıktıya yansır.
Özet
Özet
- Few-shot prompting, görev kuralını yazılı açıklama yerine birkaç (girdi, çıktı) örneğiyle gösterir.
- Model, bu örneklerden görevin örüntüsünü çıkarsar -- 20. dersteki (NLP kategorisi) genelleme bulgusuyla aynı mekanizma.
- Her eklenen örnek, doğrudan token maliyetini artırır (bu dersteki örnekte 3.6x).
- Örnek sayısı arttıkça fayda azalır -- genelde 2-5 örnek çoğu görev için yeterlidir.
- Tutarlı ve çeşitli örnekler seçmek, modelin doğru kuralı çıkarsaması için kritiktir.