

Yaygın başarısızlık kalıpları
Önkoşul:Prompt'u iyileştirme döngüsü: ölç, değiştir, karşılaştır
Kanca
“Fiyatlardan bahset” ile “Fiyatlardan bahsetme” — bu iki cümle, tam ters anlama gelir. Ama token düzeyinde bakınca, ne kadar farklı görünüyorlar?
Sezgi
3-8. derste öğrendiğimiz tekniklerin (persona, few-shot, CoT, format) hepsi, doğru kullanılmazsa başarısızlığa yol açabilecek yapısal riskler taşır. Bu ders, bu risklerin en yaygın 5 kalıbını katalogluyor — ilki, gerçek bir token sayımıyla ölçülebilir.
Mekanizma
Olumlu ve olumsuz bir talimatın token dizilerini gerçekten karşılaştıralım:
Olumsuzlama: en az değişiklikle en büyük anlam farkı
# Yaygın başarısızlık kalıbı #1: olumsuzlama (negation). "X yap" ile "X yapma" arasındaki
# yüzey (token düzeyinde) benzerliğe bak:
OLUMLU = "Mention pricing in your response."
OLUMSUZ = "Do not mention pricing in your response."

t_olumlu = token_listesi(OLUMLU)
t_olumsuz = token_listesi(OLUMSUZ)
ortak = set(t_olumlu) & set(t_olumsuz)
tum_benzersiz = set(t_olumlu) | set(t_olumsuz)

print(f"'{OLUMLU}' -> {len(t_olumlu)} token")
print(f"'{OLUMSUZ}' -> {len(t_olumsuz)} token")
print(f"\nOrtak (paylaşılan) benzersiz token sayısı: {len(ortak)} / {len(tum_benzersiz)} (%{100*len(ortak)/len(tum_benzersiz):.0f})")
print("Fark: sadece 'do', 'n', 'ot' token'ları -- ama bu 3 token, cümlenin anlamını")
print("tamamen tersine çeviriyor. Bu, 5. kategorideki (NLP) 1. dersle aynı derse gelen bir")
print("uyarı: yüzeysel benzerlik, anlamsal benzerlik demek değildir -- ve olumsuzlama,")
print("bu farkı en az token değişikliğiyle yaratan yapıdır.")
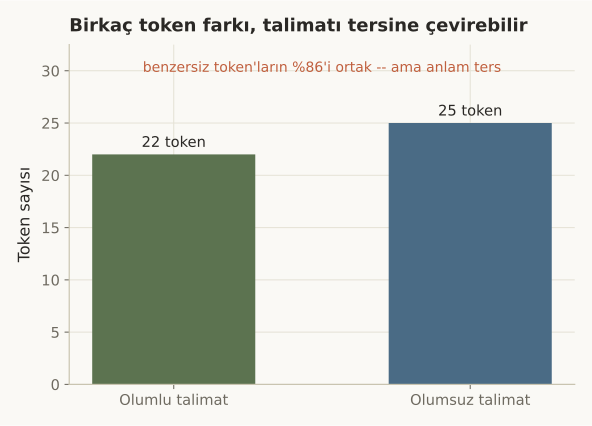
'Mention pricing in your response.' -> 22 token
'Do not mention pricing in your response.' -> 25 token
Ortak (paylaşılan) benzersiz token sayısı: 18 / 21 (%86)
Fark: sadece 'do', 'n', 'ot' token'ları -- ama bu 3 token, cümlenin anlamını
tamamen tersine çeviriyor. Bu, 5. kategorideki (NLP) 1. dersle aynı derse gelen bir
uyarı: yüzeysel benzerlik, anlamsal benzerlik demek değildir -- ve olumsuzlama,
bu farkı en az token değişikliğiyle yaratan yapıdır.Matematik
Yüzey benzerliği ≠ anlamsal benzerlik
Bu bulgu, 5. kategorinin (NLP & LLM) ilk dersindeki bulguyla aynı ailededir: “Bu film çok iyi, hiç kötü değil” ile “Bu film hiç iyi değil, çok kötü” bag-of-words’te birebir aynı vektöre dönüşüyordu — iki cümle yüzeysel olarak (kelime kümesi) özdeş ama anlamsal olarak tersti. Bu dersteki bulgu, aynı riskin token düzeyinde bir yansıması: az sayıda token değişikliği, büyük bir anlam değişikliğine yol açabilir.
Kod
 (grafiği tam boyutta, yeni sekmede aç)
Diğer dört yaygın kalıp, önceki derslerle doğrudan bağlantılıdır:
4 kalıp daha: çelişki, varsayılan bağlam, aşırı yükleme, belirsiz referans
# Yaygın başarısızlık kalıpları #2-5 (bunlar kavramsal, önceki derslerle bağlantılı):
print("\nDiğer yaygın başarısızlık kalıpları:")
print("  #2 çelişkili talimatlar: 'kısa ve öz ol' + 'her detayı ayrıntılı açıkla' gibi")
print("     birbiriyle çatışan istekler -- model, hangisine öncelik vereceğini kendisi seçer,")
print("     bu da öngörülemeyen sonuçlara yol açar.")
print("  #3 varsayılan bağlam: modelin senin ekranını, önceki bir konuşmayı, ya da güncel")
print("     (eğitim kesim tarihinden sonraki) bir olayı bildiğini varsaymak -- 2. dersteki")
print("     bağlam penceresi kavramının bir uzantısı: model sadece kendisine verileni bilir.")
print("  #4 aşırı yükleme: tek bir promptta 10'dan fazla talimat sıralamak -- 8. dersteki")
print("     'tek seferde tek değişken' ilkesinin tersi; hangi talimatın uygulanmadığını")
print("     teşhis etmek zorlaşır.")
print("  #5 belirsiz referanslar: 'bunu düzelt', 'yukarıdaki gibi yap' gibi, neye işaret")
print("     ettiği bağlamdan net olmayan ifadeler -- 10. dersteki (NLP) 'o' zamiri örneğinin")
print("     tersi: orada bağlam netti, burada belirsiz.")
Diğer yaygın başarısızlık kalıpları:
  #2 çelişkili talimatlar: 'kısa ve öz ol' + 'her detayı ayrıntılı açıkla' gibi
     birbiriyle çatışan istekler -- model, hangisine öncelik vereceğini kendisi seçer,
     bu da öngörülemeyen sonuçlara yol açar.
  #3 varsayılan bağlam: modelin senin ekranını, önceki bir konuşmayı, ya da güncel
     (eğitim kesim tarihinden sonraki) bir olayı bildiğini varsaymak -- 2. dersteki
     bağlam penceresi kavramının bir uzantısı: model sadece kendisine verileni bilir.
  #4 aşırı yükleme: tek bir promptta 10'dan fazla talimat sıralamak -- 8. dersteki
     'tek seferde tek değişken' ilkesinin tersi; hangi talimatın uygulanmadığını
     teşhis etmek zorlaşır.
  #5 belirsiz referanslar: 'bunu düzelt', 'yukarıdaki gibi yap' gibi, neye işaret
     ettiği bağlamdan net olmayan ifadeler -- 10. dersteki (NLP) 'o' zamiri örneğinin
     tersi: orada bağlam netti, burada belirsiz.
Nerede işe yarar
Bu 5 kalıba karşı pratik önlemler:
- Olumsuzlama yerine olumlu çerçeveleme tercih et: “başka dilde yanıt verme” yerine “sadece İngilizce yanıt ver” — aynı kısıtı, olumsuzlama olmadan ifade eder.
- Çelişkili talimatları fark etmek için, promptunu sesli oku — “kısa ol” ve “her detayı açıkla” aynı cümlede varsa, bu bir çatışma sinyalidir.
- Varsayılan bağlamı asla varsaymamak — modelin görmediği hiçbir şeyi (ekran görüntüsü, önceki bir e-posta, güncel haberler) “bilmesini” bekleme.
- Aşırı yüklemeyi 8. dersteki döngüyle test et: tek bir promptta çok fazla talimat varsa, hangisinin uygulanmadığını teşhis etmek için, talimatları tek tek ekleyerek yeniden dene.
Bu 2 hatayı yaparsın:
- Bu 5 kalıbı “nadir köşe durumları” sanmak — bunlar günlük prompt yazımında sıkça karşılaşılan, yaygın hatalardır.
- Bir başarısızlığı fark edince “model kötü” diye düşünüp vazgeçmek — 8. dersteki döngüyü (ölç, değiştir, karşılaştır) uygulayarak, kalıbı tanıyıp düzeltmek genelde mümkündür.
Kendini test et
1. Notebook'ta 'Mention pricing' (22 token) ile 'Do not mention pricing' (25 token) arasındaki token örtüşmesi %86. Bu neyi gösteriyor?
- İki cümlenin aynı anlama geldiğini
- Anlamı tamamen tersine çeviren bir değişikliğin (olumsuzlama), token düzeyinde çok küçük bir fark (sadece 3 token) olarak görünebileceğini -- yüzey benzerliği ile anlamsal benzerlik aynı şey değildir (doğru cevap)
- Tokenizer'ın hatalı çalıştığını
- Olumsuzlamanın hiçbir riski olmadığını
Neden: olumsuzlama-tuzagi bloğunda %86 ortak token oranı, sadece 'do', 'n', 'ot' token'larının farklı olduğunu gösteriyor -- bu küçük fark, cümlenin anlamını tamamen tersine çeviriyor.
2. 5. kategorinin (NLP & LLM) 1. dersindeki bag-of-words bulgusuyla, bu dersteki olumsuzlama bulgusu arasındaki ortak tema nedir?
- Hiçbir ortak temaları yoktur
- İkisi de 'yüzeysel (surface-level) benzerliğin, anlamsal benzerlik anlamına gelmediğini' gösteriyor -- biri kelime kümesi düzeyinde (bag-of-words), diğeri token dizisi düzeyinde aynı riski ortaya koyuyor (doğru cevap)
- İkisi de tokenization ile ilgisizdir
- İkisi de sadece İngilizce için geçerlidir
Neden: MathBox'ta bu bağlantı açıkça kuruluyor: 'Bu film çok iyi, hiç kötü değil' ile 'Bu film hiç iyi değil, çok kötü' bag-of-words'te özdeşti (5. kategori, 1. ders) -- aynı mantık, bu dersteki token benzerliğinde de geçerli.
3. 'Aşırı yükleme' (tek promptta çok fazla talimat) neden 8. dersteki döngüyle ilişkilidir?
- Hiçbir ilişkisi yoktur
- 8. ders, her adımda sadece tek bir değişkenin değiştirilmesini öğütlüyordu -- aşırı yükleme bunun tam tersidir: birçok talimat aynı anda verildiğinde, hangisinin uygulanmadığını teşhis etmek zorlaşır (doğru cevap)
- Aşırı yükleme sadece JSON çıktılarında görülür
- Aşırı yükleme token maliyetini azaltır
Neden: diger-kaliplar bloğunda #4 kalıp açıkça 8. dersteki 'tek seferde tek değişken' ilkesinin tersi olarak tanımlanıyor.
Özet
Özet
- Olumsuzlama ("X yapma"), yüzeysel olarak "X yap" ile neredeyse özdeştir (bu dersteki örnekte %86 token örtüşmesi) -- ama anlam tam terstir.
- Bu, 5. kategorinin (NLP) 1. dersindeki bag-of-words bulgusuyla aynı ailededir: yüzey benzerliği, anlam benzerliği demek değildir.
- Diğer yaygın kalıplar: çelişkili talimatlar, varsayılan bağlam, aşırı yükleme, belirsiz referanslar.
- Olumlu çerçeveleme ("sadece X yap"), olumsuzlamadan ("Y yapma") genelde daha güvenilirdir.
- Bu kalıpları tanımak, 8. dersteki iyileştirme döngüsünü daha hedefli uygulamayı sağlar.