

Yapılandırılmış çıktı alma (JSON, şema)
Önkoşul:Düşünce zinciri (chain-of-thought) ve sınırları
Kanca
Bir modelden “kullanıcının adını ve yaşını JSON olarak ver” istedin. Cevap geldi. Şimdi bunu bir programda nasıl kullanacaksın? Cevap “neredeyse doğru” bir JSON’sa, kodun çöker.
Sezgi
Serbest metin, insan için okunabilir ama program için güvenilmezdir. Yapılandırılmış çıktı (JSON, şema), 3. dersteki “format” parçasının en kesin biçimidir — ve gerçek modellerin JSON isterken yaptığı yaygın hatalar vardır.
Mekanizma
Dört gerçekçi model çıktısını, gerçek bir Python json.loads() ile ayrıştırmayı deneyelim:
4 örnekten sadece 1'i doğrudan ayrıştırılabiliyor
# Bir modelden "kullanıcının adını ve yaşını JSON olarak ver" istediğinde, gerçekte
# aşağıdaki gibi dört farklı (ama hepsi yaygın) biçimde cevap alabilirsin. Üçü,
# doğrudan json.loads() ile ayrıştırılamaz -- bunlar gerçek Python hatalarıdır.
ORNEK_CIKTILAR = [
    '{"isim": "Ayşe", "yas": 29}',
    '```json\n{"isim": "Ayşe", "yas": 29}\n```',
    'Elbette, işte istediğiniz JSON: {"isim": "Ayşe", "yas": 29}',
    '{"isim": "Ayşe", "yas": 29,}',
]
ACIKLAMALAR = ["Temiz JSON", "Markdown kod bloğuna sarılmış", "Ekstra açıklama metniyle", "Sondaki virgül (trailing comma) ile"]

print(f"{'#':<3} {'Açıklama':<38} {'Doğrudan json.loads() sonucu'}")
basarili_sayisi = 0
for i, (cikti, aciklama) in enumerate(zip(ORNEK_CIKTILAR, ACIKLAMALAR)):
    try:
        json.loads(cikti)
        sonuc = "BAŞARILI"
        basarili_sayisi += 1
    except json.JSONDecodeError as e:
        sonuc = f"BAŞARISIZ ({e})"
    print(f"{i:<3} {aciklama:<38} {sonuc}")
print(f"\nDoğrudan ayrıştırma: {basarili_sayisi}/{len(ORNEK_CIKTILAR)} başarılı.")
print("Modeller sıkça JSON'ı markdown bloğuna sarar, öncesine/sonrasına açıklama ekler,")
print("veya son elemandan sonra fazladan bir virgül bırakır -- hepsi, saf json.loads() için ölümcüldür.")
# Açıklama Doğrudan json.loads() sonucu
0 Temiz JSON BAŞARILI
1 Markdown kod bloğuna sarılmış BAŞARISIZ (Expecting value: line 1 column 1 (char 0))
2 Ekstra açıklama metniyle BAŞARISIZ (Expecting value: line 1 column 1 (char 0))
3 Sondaki virgül (trailing comma) ile BAŞARISIZ (Expecting property name enclosed in double quotes: line 1 column 28 (char 27))
Doğrudan ayrıştırma: 1/4 başarılı.
Modeller sıkça JSON'ı markdown bloğuna sarar, öncesine/sonrasına açıklama ekler,
veya son elemandan sonra fazladan bir virgül bırakır -- hepsi, saf json.loads() için ölümcüldür.Matematik
Kısıtlı örnekleme (constrained decoding)
- dersteki (NLP kategorisi) top-k/top-p filtrelemesini hatırla: bir sonraki token’ın olasılık dağılımından, geçersiz adayları elemek mümkündü. Bazı API’ler “JSON modu” sunar — bu, her adımda sadece geçerli JSON grameriyle devam edebilecek token’lara izin vererek, modelin geçersiz bir çıktı üretmesini matematiksel olarak imkansız hâle getirir.
Kod
Ayrıştırma sorununu sonradan çözen sağlam (robust) bir fonksiyon yazalım:
Sağlam ayrıştırıcı: 1/4'ten 4/4'e
# Bu yaygın sorunları önceden temizleyen bir "sağlam" (robust) ayrıştırıcı yazalım.
def saglam_ayristir(metin):
    temiz = re.sub(r"```(json)?", "", metin).strip()
    eslesme = re.search(r"(\{.*\}|\[.*\])", temiz, re.DOTALL)
    if eslesme:
        temiz = eslesme.group(1)
    temiz = re.sub(r",\s*([}\]])", r"\1", temiz)  # sondaki virgülü temizle
    return json.loads(temiz)

print(f"\n{'#':<3} {'Açıklama':<38} {'Sağlam ayrıştırıcı sonucu'}")
basarili_sayisi_2 = 0
for i, (cikti, aciklama) in enumerate(zip(ORNEK_CIKTILAR, ACIKLAMALAR)):
    try:
        sonuc_json = saglam_ayristir(cikti)
        sonuc = f"BAŞARILI -> {sonuc_json}"
        basarili_sayisi_2 += 1
    except json.JSONDecodeError as e:
        sonuc = f"BAŞARISIZ ({e})"
    print(f"{i:<3} {aciklama:<38} {sonuc}")
print(f"\nSağlam ayrıştırma: {basarili_sayisi_2}/{len(ORNEK_CIKTILAR)} başarılı -- {basarili_sayisi} → {basarili_sayisi_2} yükseldi.")
#   Açıklama                               Sağlam ayrıştırıcı sonucu
0   Temiz JSON                             BAŞARILI -> {'isim': 'Ayşe', 'yas': 29}
1   Markdown kod bloğuna sarılmış          BAŞARILI -> {'isim': 'Ayşe', 'yas': 29}
2   Ekstra açıklama metniyle               BAŞARILI -> {'isim': 'Ayşe', 'yas': 29}
3   Sondaki virgül (trailing comma) ile    BAŞARILI -> {'isim': 'Ayşe', 'yas': 29}

Sağlam ayrıştırma: 4/4 başarılı -- 1 → 4 yükseldi.
En iyisi ise, sorunu en baştan önlemek — net bir şema istemek:
Şema, formatı baştan netleştirir
# En iyi çözüm: ayrıştırma sorununu sonradan düzeltmek yerine, modelden istenen
# formatı baştan net bir şema ile belirtmek (3. dersteki "format" parçası).
BELIRSIZ_ISTEM = "Tell me about a user named Ayşe who is 29 years old."
SEMALI_ISTEM = (
    'Return ONLY valid JSON matching this schema, with no other text: '
    '{"isim": string, "yas": integer}. User: Ayşe, 29 years old.'
)
print(f"\nBelirsiz istem: \"{BELIRSIZ_ISTEM}\"")
print(f"Şemalı istem:   \"{SEMALI_ISTEM}\"")
print("\nŞemalı istem, modele tam olarak hangi alanları, hangi tipte beklediğini söylüyor --")
print("bu, 3. dersteki format parçasının en kesin biçimidir.")
Belirsiz istem: "Tell me about a user named Ayşe who is 29 years old."
Şemalı istem: "Return ONLY valid JSON matching this schema, with no other text: {"isim": string, "yas": integer}. User: Ayşe, 29 years old."
Şemalı istem, modele tam olarak hangi alanları, hangi tipte beklediğini söylüyor --
bu, 3. dersteki format parçasının en kesin biçimidir.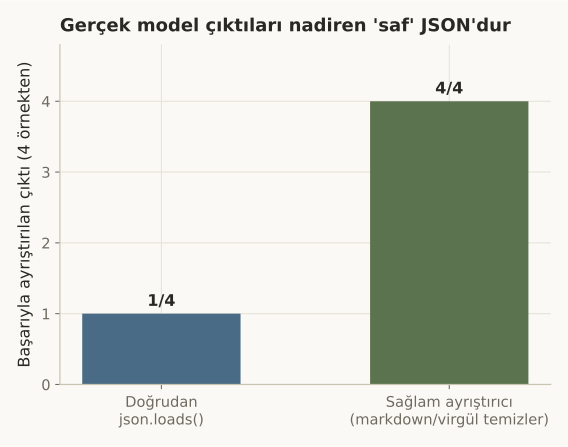 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Yapılandırılmış çıktı almanın pratikte iki tamamlayıcı stratejisi var:
- Önleyici: istemde açıkça bir şema belirt (“sadece bu JSON’ı döndür, başka metin ekleme”) — 3. dersteki format parçasının en net uygulaması.
- Düzeltici: modelin çıktısını, yaygın hataları (markdown sarma, ekstra metin, sondaki virgül) temizleyen sağlam bir ayrıştırıcıdan geçir — önleyici strateji her zaman %100 çalışmaz.
- Doğrulama + yeniden deneme: ayrıştırma başarısız olursa, hatayı modele geri bildir ve tekrar sormak yaygın bir üretim (production) tekniğidir.
Bu 2 hatayı yaparsın:
- Modelin “JSON döndür” dediğinde her zaman saf, temiz JSON döndüreceğini varsaymak — bu dersteki 4 örnekten 3’ü bunu çürütüyor.
- Sağlam bir ayrıştırıcıyı gereksiz bulup atlamak — üretim ortamında (production), tek bir ayrıştırma hatası bile tüm bir işlem hattını çökertebilir.
Kendini test et
1. Notebook'ta 4 gerçekçi model çıktısından sadece 1'i doğrudan json.loads() ile ayrıştırılabiliyor. Diğer 3'ünün başarısız olmasının nedenleri nelerdir?
- Hepsi aynı nedenle başarısız oluyor
- Markdown kod bloğuna sarılmış olması, öncesine/sonrasına açıklama metni eklenmiş olması, ve JSON'ın sonunda fazladan bir virgül (trailing comma) bırakılması -- üçü de modellerin gerçekten yaptığı yaygın hatalardır (doğru cevap)
- Türkçe karakterler JSON formatını bozar
- json.loads() fonksiyonu hatalıdır
Neden: dogrudan-ayristirma-basarisiz bloğunda üç farklı gerçek Python hatası (JSONDecodeError) görülüyor -- her biri farklı bir yaygın formatlama sorununa karşılık geliyor.
2. Sağlam (robust) ayrıştırıcı, başarı oranını 1/4'ten 4/4'e nasıl çıkarıyor?
- Modelin kendisini değiştirerek
- json.loads() çağrılmadan önce, markdown kod bloğu işaretlerini kaldırarak, metindeki ilk { } veya [ ] bloğunu bularak, ve sondaki fazladan virgülleri temizleyerek -- yani ayrıştırma öncesi bir 'temizlik' adımı ekleyerek (doğru cevap)
- Rastgele deneme yaparak
- Hataları görmezden gelerek
Neden: saglam-ayristirici bloğundaki saglam_ayristir() fonksiyonu üç adımda (markdown temizleme, JSON alt-dizisini bulma, virgül temizleme) metni json.loads()'a geçerli hale getiriyor.
3. 'Kısıtlı örnekleme' (constrained decoding / JSON modu) nasıl çalışır?
- Model çıktısını üretimden sonra düzeltir
- NLP kategorisinin 22. dersindeki top-k/top-p filtrelemesine benzer şekilde, her üretim adımında sadece geçerli JSON grameriyle uyumlu token'lara izin verir -- bu da geçersiz bir çıktının üretilmesini baştan imkansız kılar (doğru cevap)
- Modelin eğitim verisini JSON ile sınırlar
- Sadece İngilizce JSON üretebilir
Neden: MathBox'ta bu açıkça NLP kategorisinin 22. dersindeki top-k/top-p filtrelemesiyle karşılaştırılıyor -- ikisi de olasılık dağılımından geçersiz adayları eleme fikrine dayanıyor.
Özet
Özet
- Serbest metin çıktısı, program tarafından güvenilir şekilde ayrıştırılamayabilir.
- 4 gerçekçi örnekten sadece 1'i doğrudan json.loads() ile ayrıştırılabildi -- diğerleri markdown sarma, ekstra metin, veya sondaki virgül yüzünden başarısız oldu.
- Sağlam bir ayrıştırıcı (temizleme adımlarıyla), başarı oranını 4/4'e çıkardı.
- En iyi strateji önleyicidir: istemde net bir şema belirtmek (3. dersteki format parçası).
- Bazı API'ler, NLP kategorisinin 22. dersindeki top-k/top-p filtrelemesine benzer 'kısıtlı örnekleme' ile geçersiz JSON üretimini baştan engeller.