

Prompt nedir, model ne "görüyor"
Kanca
Bir sohbet penceresine bir cümle yazdığında, model senin cümleni “okumuyor”. 5. kategoride (Derin Öğrenme: NLP & LLM) kurduğumuz tüm boru hattı, senin yazdığın metni önce bir sayı dizisine çeviriyor — ve model, sadece bu sayılarla çalışıyor.
Sezgi
Bir “prompt” (istem), model için üç adımdan geçer: (1) tokenizasyon — metin sayılara dönüşür, (2) ileri geçiş — Transformer bu sayılardan bir olasılık dağılımı üretir (NLP kategorisi, 19. ders), (3) örnekleme — bu dağılımdan bir kelime seçilir (NLP kategorisi, 22. ders). Aşağıda üç örnek prompt için bu son adımı, farklı ayarlarla deneyebilirsin:
Neredeyse kesin bir cevap -- factual bir soru.
Bu ayarlarla örneklenecek en olası kelime: "Ankara" (94.0%)
Mekanizma
Önce 5. kategoride (3. ders) eğittiğimiz aynı tokenizer’ı yeniden kurup, gerçek bir prompt’u tokenlara çevirelim:
Bir prompt, token dizisine dönüşüyor
# Bir "prompt" yazdığında, model senin cümleni okumuyor -- tokenizer'ın ürettiği
# sayı dizisini görüyor. Bunu gerçek bir prompt üzerinde gösterelim.
PROMPT = "explain quantum computing to a five year old"
kelimeler_p = PROMPT.split()

print(f"\nPrompt: \"{PROMPT}\"")
print(f"Kelime sayısı: {len(kelimeler_p)}\n")
toplam_token = 0
for k in kelimeler_p:
    parcalar = bpe_encode(k, birlestirme_kurallari)
    toplam_token += len(parcalar)
    print(f"  {k:<12} -> {parcalar} ({len(parcalar)} token)")

print(f"\nToplam: {len(kelimeler_p)} kelime -> {toplam_token} token (kelime başına {toplam_token/len(kelimeler_p):.1f} token).")
print("'to', 'a' gibi corpus'ta sık geçen kelimeler tek token kalıyor. 'quantum', 'explain',")
print("'five', 'year' gibi corpus'ta hiç ya da nadir geçen kelimeler parça parça bölünüyor --")
print("kelime sayısı ile token sayısı aynı şey değil, ve bu fark, bir sonraki derste maliyete dönüşüyor.")
Prompt: "explain quantum computing to a five year old"
Kelime sayısı: 8

  explain      -> ['ex', 'p', 'la', 'in</w>'] (4 token)
  quantum      -> ['qu', 'an', 't', 'um', '</w>'] (5 token)
  computing    -> ['compu', 't', 'ing</w>'] (3 token)
  to           -> ['to</w>'] (1 token)
  a            -> ['a</w>'] (1 token)
  five         -> ['f', 'i', 'v', 'e</w>'] (4 token)
  year         -> ['y', 'e', 'ar', '</w>'] (4 token)
  old          -> ['o', 'l', 'd</w>'] (3 token)

Toplam: 8 kelime -> 25 token (kelime başına 3.1 token).
'to', 'a' gibi corpus'ta sık geçen kelimeler tek token kalıyor. 'quantum', 'explain',
'five', 'year' gibi corpus'ta hiç ya da nadir geçen kelimeler parça parça bölünüyor --
kelime sayısı ile token sayısı aynı şey değil, ve bu fark, bir sonraki derste maliyete dönüşüyor.
8 kelime, 25 token’a bölündü — kelime sayısı ile token sayısı aynı şey değil. “to”, “a” gibi tokenizer’ın sık gördüğü kelimeler tek parça kalırken, “quantum” gibi hiç görmediği bir kelime 5 parçaya bölünüyor.
Matematik
Model, bir sonraki token için olasılık üretir
Model “anlamaz” — NLP kategorisinin 20. dersinde gördüğümüz gibi tek yaptığı şey, bağlam verildiğinde kelime dağarcığındaki her token için bir olasılık hesaplamaktır. Bu ortamda gerçek bir LLM API’sine erişim olmadığı için, aşağıdaki örnek dağılımlar öğretici amaçlı elle tasarlandı — ama softmax hesaplaması gerçektir:
Kod
Üç prompt, üç farklı belirsizlik seviyesi
# Token dizisi modele girdikten sonra (19. ders), model tek bir şey üretir:
# kelime dağarcığındaki her olası "sonraki kelime" için bir olasılık. Model "anlamaz" --
# sadece bu dağılımı hesaplar. Üç öğretici amaçlı örnek (gerçek bir LLM API'sine bu ortamda
# erişim olmadığı için, hedef olasılıklar elle tasarlandı, ama softmax hesaplaması gerçek):
ORNEKLER = {
    "Türkiye'nin başkenti": {
        "kelimeler": ["Ankara", "İstanbul", "bir", "şehridir", "diğer"],
        "hedef_p": [0.94, 0.03, 0.01, 0.01, 0.01],
        "aciklama": "Neredeyse kesin bir cevap -- factual bir soru.",
    },
    "Bugün hava çok": {
        "kelimeler": ["güzel", "soğuk", "sıcak", "kötü", "değişken"],
        "hedef_p": [0.28, 0.22, 0.18, 0.17, 0.15],
        "aciklama": "Gerçekten belirsiz -- açık uçlu bir devam, tek doğru cevap yok.",
    },
    "Bir varmış bir yokmuş,": {
        "kelimeler": ["evvel", "zaman", "gün", "memlekette", "diğer"],
        "hedef_p": [0.55, 0.20, 0.10, 0.08, 0.07],
        "aciklama": "Kalıplaşmış bir ifade -- yüksek ama kesin olmayan bir tercih.",
    },
}

for prompt, veri in ORNEKLER.items():
    logit = torch.log(torch.tensor(veri["hedef_p"]))
    p_dogrulanan = F.softmax(logit, dim=-1)
    print(f"\n\"{prompt}\" -> {veri['aciklama']}")
    for k, p in zip(veri["kelimeler"], p_dogrulanan.tolist()):
        print(f"    {k:<12} P={p:.3f}")
    fark = (p_dogrulanan - torch.tensor(veri['hedef_p'])).abs().max().item()
    print(f"    (softmax(log(p)) ile hedef p arasındaki fark: {fark:.2e} -- yani softmax hesaplaması gerçek)")
"Türkiye'nin başkenti" -> Neredeyse kesin bir cevap -- factual bir soru.
Ankara P=0.940
İstanbul P=0.030
bir P=0.010
şehridir P=0.010
diğer P=0.010
(softmax(log(p)) ile hedef p arasındaki fark: 1.19e-07 -- yani softmax hesaplaması gerçek)
"Bugün hava çok" -> Gerçekten belirsiz -- açık uçlu bir devam, tek doğru cevap yok.
güzel P=0.280
soğuk P=0.220
sıcak P=0.180
kötü P=0.170
değişken P=0.150
(softmax(log(p)) ile hedef p arasındaki fark: 2.98e-08 -- yani softmax hesaplaması gerçek)
"Bir varmış bir yokmuş," -> Kalıplaşmış bir ifade -- yüksek ama kesin olmayan bir tercih.
evvel P=0.550
zaman P=0.200
gün P=0.100
memlekette P=0.080
diğer P=0.070
(softmax(log(p)) ile hedef p arasındaki fark: 1.49e-08 -- yani softmax hesaplaması gerçek)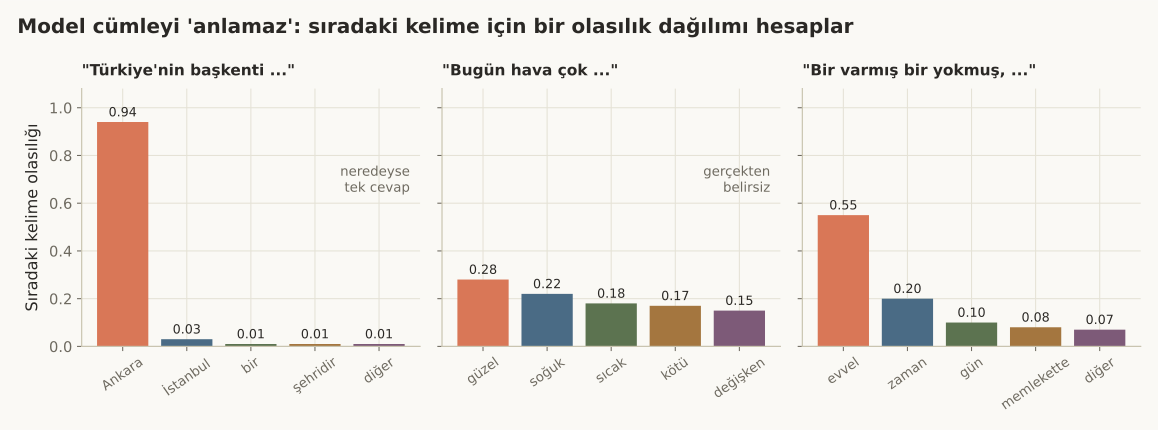 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu basit gerçek, prompt yazarken pratik sonuçlar doğurur:
- Kelime seçimi, token sayısını (ve dolayısıyla maliyeti) etkiler — yaygın, kısa kelimeler ucuzken, nadir/teknik terimler ve başka dillerdeki kelimeler daha pahalıdır (2. ders bunu maliyete bağlayacak).
- Model, tek bir “doğru” cevaba değil, bir olasılık dağılımına sahiptir — bazı promptlar (factual sorular) nettir, bazıları (açık uçlu devam) gerçekten belirsizdir.
- “Prompt mühendisliği”, özünde, bu olasılık dağılımını senin istediğin yöne kaydırma sanatıdır — 3-12. ders, bunu yapmanın farklı tekniklerini ele alacak.
Bu 2 hatayı yaparsın:
- Modelin cümleni bir insan gibi “okuduğunu” düşünmek — hayır, gördüğü şey sadece bir token ID dizisidir; senin için “aynı” görünen iki ifade (örn. büyük/küçük harf farkı) farklı tokenlara bölünebilir.
- Modelin her zaman “en doğru” cevabı bildiğini varsaymak — bazı promptlar (bu dersteki “Bugün hava çok” örneği gibi) doğası gereği belirsizdir, model bunu bir olasılık dağılımıyla dürüstçe yansıtır.
Kendini test et
1. Notebook'ta 'explain quantum computing to a five year old' prompt'u 8 kelime ama 25 token'a bölünüyor. Bu farkın nedeni ne?
- Bir hesaplama hatası
- Tokenizer, eğitim corpus'unda sık gördüğü kelimeleri (örn. 'to', 'a') tek token olarak tutarken, hiç ya da nadir gördüğü kelimeleri (örn. 'quantum', 'explain') karakter karakter parçalıyor (doğru cevap)
- Her kelime her zaman tam olarak 3 token'a bölünür
- Uzun kelimeler daima tek token olur
Neden: prompt-tokenlara-donusur bloğunda 'to' ve 'a' tek token kalırken, 'quantum' 5, 'explain' 4 parçaya bölünüyor -- BPE'nin eğitim verisindeki sıklığa dayalı çalıştığının kanıtı (5. kategori, 3. ders).
2. 'Türkiye'nin başkenti' ile 'Bugün hava çok' promptları arasındaki temel fark nedir (bu dersteki örnek dağılımlara göre)?
- İkisi de aynı derecede belirsizdir
- İlki neredeyse kesin bir cevaba (Ankara, %94) işaret ederken, ikincisi gerçekten belirsizdir (en yüksek olasılık sadece %28) -- çünkü açık uçlu bir cümlenin tek doğru devamı yoktur (doğru cevap)
- İkisi de yanlış cevap üretir
- 'Bugün hava çok' promptu daha uzun olduğu için daha güvenilirdir
Neden: model-ne-goruyor bloğunda 'Türkiye'nin başkenti' için P(Ankara)=0.940 iken 'Bugün hava çok' için en yüksek olasılık P(güzel)=0.280 -- ikinci dağılım çok daha düz, yani belirsiz.
3. Bu derste 'model ne görüyor' sorusunun cevabı nedir?
- Model, cümleni bir insan gibi anlamlandırır
- Model, tokenizasyondan geçmiş bir sayı dizisi görür ve bu diziden, kelime dağarcığındaki her token için bir sonraki-token olasılığı hesaplar -- "anlama" değil, olasılık hesaplama (doğru cevap)
- Model, cümlenin gramer yapısını ayrıştırır
- Model, promptu doğrudan bir veritabanında arar
Neden: Sezgi bölümünde üç adım (tokenizasyon -> ileri geçiş -> örnekleme) özetleniyor; MathBox'taki P(x_t | x_1...x_{t-1}) formülü (NLP kategorisi, 20. ders) bu sürecin matematiksel özüdür.
Özet
Özet
- Bir prompt, modele ulaşmadan önce tokenizasyondan geçer -- kelime sayısı ile token sayısı farklı şeylerdir.
- Tokenizer'ın eğitim verisinde sık geçen kelimeler az token, nadir/teknik kelimeler çok token alır.
- Model, tokenlardan bir sonraki token için bir olasılık dağılımı hesaplar -- "anlama" değil, hesaplama.
- Bazı promptlar (factual sorular) net bir dağılıma, bazıları (açık uçlu devamlar) gerçekten belirsiz bir dağılıma yol açar.
- Prompt mühendisliği, bu dağılımı istenen yöne kaydırma sanatıdır -- sonraki derslerin konusu budur.