

RAG'e giriş
Önkoşul:Halüsinasyon: neden olur, nasıl azaltılır
Kanca
- derste gördük: bir model, bilmediği bir şey sorulduğunda bile %100 güvenle bir cevap üretir. Peki modele, cevabı uydurmak yerine, gerçekten bilinen bir kaynaktan bakmasını nasıl sağlarız?
Sezgi
RAG (Retrieval-Augmented Generation), üç adımlı bir tariftir: getir (sorguyla en ilgili belgeyi bir bilgi tabanından bul), zenginleştir (bu belgeyi promptun bağlamına ekle), üret (model, artık elindeki bu bilgiye dayanarak cevap versin). Bu, 10. dersteki halüsinasyon sorununa doğrudan bir ÇÖZÜMdür.
Mekanizma
Küçük bir bilgi tabanı kurup, 5. kategorideki (NLP & LLM, 4. ders) aynı TF-IDF fikrini bir getirme motoru olarak kullanalım:
Getir: sorguya en benzer belgeyi bul
# 5. kategorideki (NLP & LLM, 4. ders) aynı TF-IDF fikrini, şimdi bir "getirme"
# (retrieval) motoru olarak kullanıyoruz.
def tokenize(s):
    return s.lower().replace(".", "").replace(",", "").replace("'", "").split()

def tf(belge):
    kelimeler = tokenize(belge)
    sayac = Counter(kelimeler)
    toplam = len(kelimeler)
    return {k: v / toplam for k, v in sayac.items()}

def idf(belgeler):
    N = len(belgeler)
    kelime_belge_sayisi = Counter()
    for b in belgeler:
        for k in set(tokenize(b)):
            kelime_belge_sayisi[k] += 1
    return {k: math.log(N / v) for k, v in kelime_belge_sayisi.items()}

idf_degerleri = idf(BELGELER)
tum_kelimeler = sorted(set(k for b in BELGELER for k in tokenize(b)))

def tfidf_vektor(belge):
    tf_degerleri = tf(belge)
    return [tf_degerleri.get(k, 0) * idf_degerleri.get(k, 0) for k in tum_kelimeler]

def kosinus(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    na = math.sqrt(sum(x * x for x in a))
    nb = math.sqrt(sum(x * x for x in b))
    return dot / (na * nb + 1e-10)

belge_vektorleri = [tfidf_vektor(b) for b in BELGELER]

SORGU = "Academyou AI kaç dilde ders sunuyor?"
sorgu_vektor = tfidf_vektor(SORGU)

benzerlikler = sorted(
    [(i, kosinus(sorgu_vektor, bv)) for i, bv in enumerate(belge_vektorleri)],
    key=lambda x: -x[1],
)
print(f"Sorgu: \"{SORGU}\"\n")
print(f"{'Benzerlik':<12} Belge")
for i, s in benzerlikler:
    print(f"{s:<12.3f} {BELGELER[i]}")

en_ilgili_indeks = benzerlikler[0][0]
en_ilgili_belge = BELGELER[en_ilgili_indeks]
print(f"\nEn ilgili belge (retrieval sonucu): \"{en_ilgili_belge}\"")
Sorgu: "Academyou AI kaç dilde ders sunuyor?"
Benzerlik Belge
0.422 Academyou AI platformunda Türkçe dilinde 150'den fazla ders bulunur.
0.110 Academyou AI ücretsiz derslerini 2026 yılında yayınlamaya başladı.
0.105 Academyou AI, yapay zeka eğitimi sunan bir platformdur.
0.000 İade politikamıza göre, satın alınan ürünler 30 gün içinde iade edilebilir.
0.000 Müşteri destek ekibimize hafta içi 09.00-18.00 arasında ulaşabilirsiniz.
0.000 Şirketimiz 2023 yılında İstanbul'da kuruldu.
En ilgili belge (retrieval sonucu): "Academyou AI platformunda Türkçe dilinde 150'den fazla ders bulunur."Matematik
Getirme: kosinüs benzerliği
Bu, 5. kategoride (NLP & LLM) tekrar tekrar kullandığımız aynı kosinüs benzerliği formülüdür — burada sorgunun, ise bir belgenin TF-IDF vektörüdür. En yüksek benzerlikli belge, “Getirilen” (retrieved) belge olur.
Kod
Şimdi zenginleştir ve üret adımlarını görelim:
Zenginleştir: getirilen bilgiyi bağlama ekle
# Augment: getirilen belgeyi, sorguyla birlikte bağlama ekle.
NAIF_PROMPT = SORGU
RAG_PROMPT = (
    f'Aşağıdaki bilgiye dayanarak soruyu cevapla. Bilgi: "{en_ilgili_belge}" '
    f"Soru: {SORGU}"
)

print(f"\nNaif prompt (10. dersteki gibi, modelin kendi hafızasına güvenmesi gerekir):")
print(f"  \"{NAIF_PROMPT}\"")
print(f"\nRAG prompt (getirilen belgeyle temellendirilmiş):")
print(f"  \"{RAG_PROMPT}\"")
print("\nNaif promptta model, 10. dersteki 'AAAA' örneğindeki gibi, bilgisi olmasa bile")
print("bir cevap uydurabilir. RAG promptta ise, cevap zaten bağlamda var -- model sadece")
print("bunu bulup aktarmak zorunda, icat etmek değil.")
Naif prompt (10. dersteki gibi, modelin kendi hafızasına güvenmesi gerekir):
  "Academyou AI kaç dilde ders sunuyor?"

RAG prompt (getirilen belgeyle temellendirilmiş):
  "Aşağıdaki bilgiye dayanarak soruyu cevapla. Bilgi: "Academyou AI platformunda Türkçe dilinde 150'den fazla ders bulunur." Soru: Academyou AI kaç dilde ders sunuyor?"

Naif promptta model, 10. dersteki 'AAAA' örneğindeki gibi, bilgisi olmasa bile
bir cevap uydurabilir. RAG promptta ise, cevap zaten bağlamda var -- model sadece
bunu bulup aktarmak zorunda, icat etmek değil.
Peki bilgi tabanında olmayan bir şey sorulursa?
İlgisiz bir sorguda benzerlik neredeyse sıfır
# RAG'in güvenilirliği, getirme (retrieval) adımının kalitesine bağlıdır -- ilgisiz
# bir sorguyla ne olur?
ILGISIZ_SORGU = "Bugün hava nasıl?"
ilgisiz_vektor = tfidf_vektor(ILGISIZ_SORGU)
ilgisiz_benzerlikler = sorted(
    [(i, kosinus(ilgisiz_vektor, bv)) for i, bv in enumerate(belge_vektorleri)],
    key=lambda x: -x[1],
)
print(f"\nİlgisiz sorgu: \"{ILGISIZ_SORGU}\"")
print(f"En yüksek benzerlik: {ilgisiz_benzerlikler[0][1]:.3f} (\"{BELGELER[ilgisiz_benzerlikler[0][0]]}\")")
print("\nBilgi tabanında bu soruyla ilgili hiçbir şey yok -- en yüksek benzerlik bile çok")
print("düşük. İyi bir RAG sistemi, bu durumda 'ilgili bilgi bulunamadı' demelidir --")
print("düşük benzerlikli bir belgeyi zorla bağlama eklemek, yanlış yönlendirebilir.")
İlgisiz sorgu: "Bugün hava nasıl?"
En yüksek benzerlik: 0.000 ("Academyou AI, yapay zeka eğitimi sunan bir platformdur.")
Bilgi tabanında bu soruyla ilgili hiçbir şey yok -- en yüksek benzerlik bile çok
düşük. İyi bir RAG sistemi, bu durumda 'ilgili bilgi bulunamadı' demelidir --
düşük benzerlikli bir belgeyi zorla bağlama eklemek, yanlış yönlendirebilir.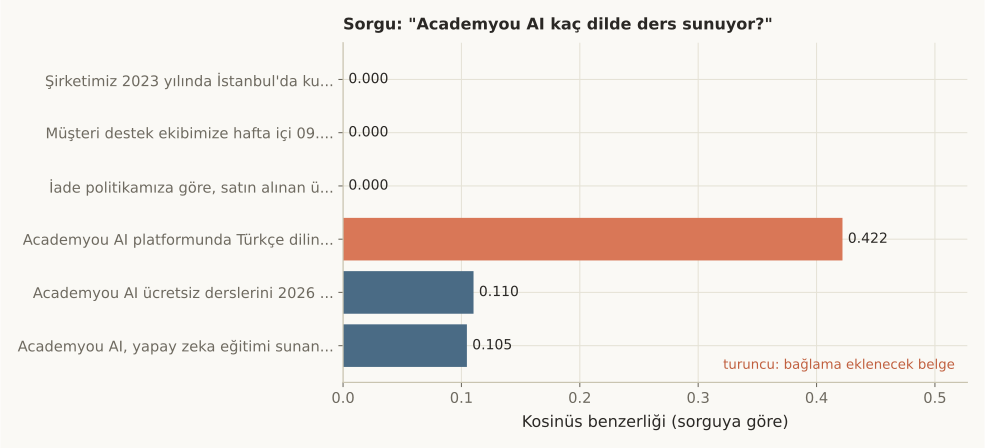 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
RAG, halüsinasyonu azaltır ama sıfırlamaz — güvenilirliği getirme adımının kalitesine bağlıdır:
- “Garbage in, garbage out”: bilgi tabanı yanlış veya güncel olmayan bilgi içeriyorsa, RAG bu yanlış bilgiyi de aynı güvenle aktarır.
- Düşük benzerlikli sonuçlar işaret sayılmalıdır: bu dersteki ilgisiz sorgu örneğinde olduğu gibi, en yüksek benzerlik bile düşükse, sistem “ilgili bilgi bulunamadı” demelidir — zorla bir belge eklemek yerine.
- Gerçek sistemler TF-IDF yerine genelde yoğun (dense) embedding’ler kullanır (5. kategori, 5. ders) — bunlar eş anlamlı kelimeleri de (örn. “ücretsiz” ve “bedava”) yakalayabilir, TF-IDF’nin yakalayamadığı bir esneklik sağlar.
Bu 2 hatayı yaparsın:
- RAG’in halüsinasyonu tamamen ortadan kaldırdığını düşünmek — 10. dersteki matematiksel gerçek (softmax her zaman bir dağılım üretir) HÂLÂ geçerlidir; RAG sadece modele daha iyi bir temel sağlar.
- Düşük benzerlikli bir getirme sonucunu yine de bağlama eklemek — bu, modeli yanlış bir yöne itebilir, hiç bağlam vermemekten bile kötü olabilir.
Kendini test et
1. RAG'deki üç adım (Getir, Zenginleştir, Üret) ne işe yarar?
- Modelin parametrelerini kalıcı olarak günceller
- Sorguyla en ilgili belgeyi bir bilgi tabanından bulur (Getir), bu belgeyi promptun bağlamına ekler (Zenginleştir), model bu bağlama dayanarak cevap üretir (Üret) -- modelin kendi hafızasına güvenmesi yerine verilen bir kaynağı kullanmasını sağlar (doğru cevap)
- Modeli daha hızlı çalıştırır
- Sadece görsel içerik için kullanılır
Neden: tfidf-getirme ve augment-ve-generate bloklarında bu üç adım açıkça sırayla uygulanıyor: TF-IDF ile en ilgili belge bulunuyor, sonra bu belge promptun içine ekleniyor.
2. Notebook'ta 'Bugün hava nasıl?' gibi ilgisiz bir sorguda en yüksek benzerlik bile 0.000 çıkıyor. İyi bir RAG sistemi bu durumda ne yapmalıdır?
- En yüksek benzerlikli belgeyi yine de bağlama eklemeli
- 'İlgili bilgi bulunamadı' şeklinde bir sinyal vermeli -- düşük benzerlikli bir belgeyi zorla bağlama eklemek, modeli yanlış bir yöne yönlendirebilir (doğru cevap)
- Hata vermeli ve çökmelidir
- Rastgele bir belge seçmelidir
Neden: getirme-kalitesinin-onemi bloğunda açıkça belirtildiği gibi, çok düşük bir benzerlik skoru, bilgi tabanında ilgili hiçbir şey olmadığının işaretidir -- bu durumda bağlam eklememek daha güvenlidir.
3. RAG, 10. dersteki halüsinasyon sorununu tamamen mi çözer?
- Evet, RAG kullanan bir model asla halüsinasyon görmez
- Hayır -- 10. dersteki matematiksel gerçek (softmax her zaman bir dağılım üretir) HÂLÂ geçerlidir; RAG sadece modele daha iyi bir temel (bağlam) sağlayarak riski azaltır, tamamen ortadan kaldırmaz (doğru cevap)
- Evet, çünkü RAG modelin mimarisini değiştirir
- RAG halüsinasyonla hiç ilgili değildir
Neden: kullanım bölümünde açıkça belirtildiği gibi, RAG'in bilgi tabanı yanlış veya belirsiz olduğunda, ya da getirme kalitesi düşük olduğunda, halüsinasyon riski hâlâ vardır.
Özet
Özet
- RAG üç adımdan oluşur: Getir (en ilgili belgeyi bul), Zenginleştir (bağlama ekle), Üret (bu bağlama dayanarak cevap ver).
- Getirme, kosinüs benzerliği (5. kategorideki aynı formül) ile ölçülür -- bu dersteki örnekte doğru belge 0.422 benzerlikle bulundu.
- İlgisiz bir sorguda benzerlik skorları çok düşük kalır -- bu, "ilgili bilgi yok" sinyali olarak kullanılmalıdır.
- RAG, 10. dersteki halüsinasyon riskini azaltır ama tamamen ortadan kaldırmaz.
- Gerçek sistemler, TF-IDF yerine genelde yoğun embedding'ler (5. kategori, 5. ders) kullanır -- eş anlamlı kelimeleri de yakalayabilmek için.