

Eksik veri stratejileri
Önkoşul:Birleştirme (merge, join, concat)
Kanca
200 müşteri kaydından, herhangi bir sütununda eksik veri olan satırları sildiğinde geriye 148 satır kalıyor — %26’lık bir kayıp. Bu kadar veriyi atmak doğru mu, yoksa eksikleri bir şekilde doldurmak mı daha iyi? Ve doldursan bile, hangi değerle?
Sezgi
Eksik veri, veri bilimindeki en sık karşılaşılan ve en kolay göz ardı edilen sorundur. İki temel strateji var: silmek (eksik içeren satırı/sütunu tamamen at) ve doldurmak (eksik yerine mantıklı bir tahmini değer koy). Hangisini seçtiğin, kaç veri kaybettiğin ve sonuçlarının ne kadar yanlı olduğu arasında bir denge kurar.
Silmek basit ama pahalıdır — özellikle eksik oranı yüksekse, veri setinin büyük bir kısmını kaybedersin. Doldurmak veriyi korur ama yanlış bir varsayım (örneğin “eksikler rastgele dağılmış” varsayımı) yanlışsa, sonuçları sessizce çarpıtabilir.
Mekanizma
Önce eksik veriyi tespit edelim:
Eksik veriyi tespit et
# 200 müşteri kaydı — yaş ve gelir sütunlarında gerçekçi oranda eksik veri var.
n = 200
musteriler = pd.DataFrame({
    "musteri_id": range(1, n + 1),
    "yas": rng.integers(18, 70, size=n).astype(float),
    "gelir": rng.normal(18000, 6000, size=n).round(0),
    "sehir": rng.choice(["İstanbul", "Ankara", "İzmir", None], size=n, p=[0.4, 0.25, 0.25, 0.10]),
})
# Rastgele bazı yaş ve gelir hücrelerini eksik yap.
musteriler.loc[rng.choice(n, size=24, replace=False), "yas"] = np.nan
musteriler.loc[rng.choice(n, size=16, replace=False), "gelir"] = np.nan

print("Sütun bazında eksik değer sayısı:")
print(musteriler.isna().sum())
print(f"\nEksik veri oranı (yaş): %{musteriler['yas'].isna().mean() * 100:.1f}")
Sütun bazında eksik değer sayısı:
musteri_id 0
yas 24
gelir 16
sehir 20
dtype: int64
Eksik veri oranı (yaş): %12.0Üç sütunda da eksik var. Şimdi silme stratejisini deneyelim:
Silme stratejisi
# En basit strateji: eksik içeren satırları SİL. Ama bu veri kaybı demektir.
tam_satirlar = musteriler.dropna()
print(f"\nOrijinal satır sayısı: {len(musteriler)}")
print(f"dropna() sonrası: {len(tam_satirlar)}  (kayıp: {len(musteriler) - len(tam_satirlar)} satır, %{(1 - len(tam_satirlar) / len(musteriler)) * 100:.1f})")

# Daha az agresif: sadece BELİRLİ bir sütunda eksik olan satırları sil.
sadece_yas_tam = musteriler.dropna(subset=["yas"])
print(f"Sadece 'yas' eksikse sil: {len(sadece_yas_tam)} satır kaldı")
Orijinal satır sayısı: 200
dropna() sonrası: 148  (kayıp: 52 satır, %26.0)
Sadece 'yas' eksikse sil: 176 satır kaldı
dropna() (hiçbir parametre vermeden) herhangi bir sütununda eksik olan HER satırı siliyor — %26 veri kaybı. subset=["yas"] ile sadece belirli bir sütuna odaklanınca kayıp %12’ye iniyor. Şimdi doldurma stratejisini deneyelim:
Doldurma stratejisi
# Silmek yerine DOLDURMAK: sayısal sütunlarda medyan (aykırı değere dayanıklı, 1. ders),
# kategorik sütunlarda en sık görülen değer (mod).
musteriler_dolu = musteriler.copy()
yas_medyan = musteriler_dolu["yas"].median()
gelir_medyan = musteriler_dolu["gelir"].median()
sehir_mod = musteriler_dolu["sehir"].mode()[0]

musteriler_dolu["yas"] = musteriler_dolu["yas"].fillna(yas_medyan)
musteriler_dolu["gelir"] = musteriler_dolu["gelir"].fillna(gelir_medyan)
musteriler_dolu["sehir"] = musteriler_dolu["sehir"].fillna(sehir_mod)

print(f"\nYaş medyanı ile dolduruldu: {yas_medyan}")
print(f"Gelir medyanı ile dolduruldu: {gelir_medyan}")
print(f"Şehir modu ile dolduruldu: {sehir_mod}")
print(f"Doldurma sonrası eksik sayısı:\n{musteriler_dolu.isna().sum()}")
Yaş medyanı ile dolduruldu: 43.5
Gelir medyanı ile dolduruldu: 17242.5
Şehir modu ile dolduruldu: İstanbul
Doldurma sonrası eksik sayısı:
musteri_id    0
yas           0
gelir         0
sehir         0
dtype: int64
Sayısal sütunlarda medyan kullandık (1. derste gördüğümüz gibi, aykırı değerlere karşı dayanıklı), kategorik sütunda ise mod (en sık görülen değer). Çoğu kişi eksik veriyi ortalamayla doldurmanın “güvenli” olduğunu sanır. Değil, çünkü veri çarpıksa (1. ve 8. derste gördüğümüz gibi) ortalama uç değerlerden etkilenir — medyan bu duruma karşı daha dayanıklıdır.
Matematik
Hangi strateji ne zaman?
| Strateji | Ne zaman uygun |
|---|---|
Satırı sil (dropna) | Eksik oranı düşükse (~%5’in altı) ve veri rastgele eksikse |
| Medyan/mod ile doldur | Eksik oranı orta düzeydeyse, hızlı bir çözüm gerekiyorsa |
| Ayrı bir kategori olarak işaretle | Eksikliğin kendisi anlamlı bir bilgi taşıyorsa (örn. “gelir belirtilmedi” bir segment olabilir) |
| Modelle tahmin et | Eksik oranı yüksekse ve diğer sütunlarla güçlü bir ilişki varsa (ileri seviye teknik) |
Kritik soru şu: eksik veri RASTGELE mi, yoksa bir ÖRÜNTÜ mü izliyor? Rastgele eksiklikte (bizim örneğimizdeki gibi) hangi stratejiyi seçersen seç sonuçlar birbirine yakın çıkar. Örüntülü eksiklikte (örn. sadece düşük gelirli müşteriler geliri boş bırakmışsa) doldurma stratejisi ciddi yanlılık yaratabilir.
Kod
Üç yaklaşımın ortalamayı nasıl etkilediğini karşılaştıralım:
Silme vs doldurma karşılaştırması
# Silme mi doldurma mı, ortalamayı nasıl etkiliyor?
print(f"\nOrijinal (eksikler hariç) yaş ortalaması: {musteriler['yas'].mean():.2f}")
print(f"dropna() sonrası yaş ortalaması:           {tam_satirlar['yas'].mean():.2f}")
print(f"Medyan ile doldurma sonrası yaş ortalaması: {musteriler_dolu['yas'].mean():.2f}")
print("\nÜçü de birbirine yakın çıktı çünkü eksik veri RASTGELE dağılmıştı —")
print("gerçek hayatta eksik veri bir örüntü izliyorsa (örn. sadece yüksek gelirliler boş bırakmışsa) bu üçü çok farklılaşabilir.")
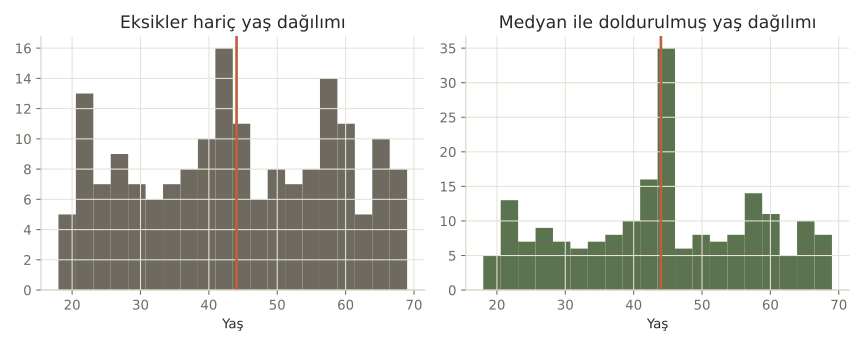
Orijinal (eksikler hariç) yaş ortalaması: 44.05
dropna() sonrası yaş ortalaması:           44.05
Medyan ile doldurma sonrası yaş ortalaması: 43.98

Üçü de birbirine yakın çıktı çünkü eksik veri RASTGELE dağılmıştı —
gerçek hayatta eksik veri bir örüntü izliyorsa (örn. sadece yüksek gelirliler boş bırakmışsa) bu üçü çok farklılaşabilir.
Üçü de birbirine çok yakın (44.05, 44.05, 43.98) — çünkü bu örnekte eksiklik rastgeleydi. Gerçek veride bu her zaman böyle olmaz.
Nerede işe yarar
Eksik veri stratejisi, her gerçek veri setinde karşına çıkan bir karardır:
- Anket verisi. Katılımcıların bazı soruları atlaması son derece yaygındır — hangi sorunun neden atlandığı bile bir bilgi taşıyabilir.
- Sensör/IoT verisi. Bağlantı kopmaları nedeniyle zaman serisinde boşluklar oluşur — burada genelde “forward fill” (bir önceki değeri taşımak) tercih edilir.
- Müşteri veritabanları. Formda zorunlu olmayan alanlar (telefon, ikinci e-posta) sıkça boş kalır.
Bu 3 hatayı yaparsın:
- Eksik veri oranını kontrol etmeden
dropna()çağırıp veri setinin önemli bir kısmını sessizce kaybetmek. - Her durumda ortalama ile doldurmayı “varsayılan doğru” saymak — çarpık dağılımda medyan çoğu zaman daha güvenlidir.
- Eksikliğin RASTGELE olup olmadığını hiç sorgulamadan doldurma stratejisi uygulamak.
Kendini test et
1. `musteriler.dropna()` (parametresiz) ne yapar?
- Sadece tamamen boş satırları siler
- HERHANGİ bir sütununda eksik değer olan her satırı siler (doğru cevap)
- Eksik değerleri otomatik doldurur
- Hiçbir şey yapmaz
Neden: Parametresiz dropna(), en az bir sütununda NaN olan HER satırı siler — bu genelde subset kullanmaktan daha fazla veri kaybına yol açar.
2. Sayısal bir sütunu doldururken neden ortalama yerine medyan tercih edilebilir?
- Medyan her zaman daha büyük bir sayıdır
- Medyan, çarpık dağılımlarda ve aykırı değerlerin varlığında ortalamadan daha dayanıklıdır (doğru cevap)
- Ortalama hesaplamak daha yavaştır
- Aralarında fark yoktur
Neden: 1. derste gördüğümüz gibi, ortalama aykırı değerlerden etkilenirken medyan sıraya baktığı için daha dayanıklıdır — çarpık dağılımlarda tercih edilir.
3. Eksik veriyi doldurma stratejisinin ne zaman ciddi bir sorun yaratabileceği belirtiliyor?
- Eksik veri hiçbir zaman sorun yaratmaz
- Eksiklik rastgele değil, belirli bir örüntü (örn. sadece belirli bir gruptaki kişiler) izliyorsa (doğru cevap)
- Sadece kategorik sütunlarda sorun olur
- Sadece veri seti çok büyükse sorun olur
Neden: Eksiklik bir örüntü izliyorsa (örneğin sadece düşük gelirliler geliri boş bırakmışsa), medyan/mod ile doldurmak o örüntüyü gizler ve sonuçları yanlı hale getirir.
Özet
Özet
- Eksik veri için iki temel strateji vardır: silmek (dropna) ve doldurmak (fillna).
- dropna() parametresiz kullanıldığında, herhangi bir sütunda eksik olan her satırı siler — subset ile bu daraltılabilir.
- Sayısal sütunlarda medyan, kategorik sütunlarda mod ile doldurma yaygın ve güvenli bir başlangıç noktasıdır.
- Eksik verinin RASTGELE mi yoksa bir örüntü mü izlediği, hangi stratejinin güvenli olduğunu belirler.
- Doldurma stratejisi veriyi korur ama yanlış varsayımlar altında sonuçları sessizce çarpıtabilir.