

Keşifçi veri analizi (EDA) yöntemi
Önkoşul:Aykırı değer tespiti
Kanca
Yeni bir sipariş veri seti elinize geçti. Hiç incelemedin. İlk yapacağın şey ne — doğrudan bir grafik mi çizersin, yoksa modele mi sokarsın? Deneyimli bir veri bilimci burada asla rastgele davranmaz: keşifçi veri analizi (EDA), izlenen sistematik bir sıradır.
Sezgi
EDA, 5-11. derslerde tek tek öğrendiğimiz araçların (shape, dtypes, describe, eksik değer kontrolü, aykırı değer tespiti, korelasyon) birleşip tek bir rutine dönüşmesidir. Amaç, veriye herhangi bir varsayımda bulunmadan önce onu “tanımak” — büyüklüğünü, tiplerini, eksiklerini, aykırılarını, değişkenler arası ilişkilerini.
EDA’nın altın kuralı: her zaman genelden özele git. Önce büyük resme bak (kaç satır, kaç sütun, hangi tipler), sonra kaliteye bak (eksik, aykırı), en son ilişkilere bak (korelasyon, gruplar arası fark). Bu sırayı tersine çevirirsen, henüz temizlenmemiş veride yanlış ilişkiler “keşfedebilirsin”.
Mekanizma
Hiç tanımadığımız bir sipariş veri setiyle başlayalım. Adım 1: genel bakış.
Adım 1: Genel bakış
# EDA'nın 1. adımı: veriye "önce genel bakış" — büyüklük, tipler, ilk birkaç satır.
print(f"Şekil: {siparisler.shape}")
print(f"\nSütun tipleri:\n{siparisler.dtypes}")
print(f"\nİlk 3 satır:\n{siparisler.head(3)}")
print(f"\nSayısal özet:\n{siparisler.describe().round(2)}")
Şekil: (250, 3)
Sütun tipleri:
tutar float64
indirim_orani float64
kategori str
dtype: object
İlk 3 satır:
tutar indirim_orani kategori
0 163.85 0.232 Elektronik
1 84.19 0.132 Ev & Yaşam
2 87.09 0.258 Kitap
Sayısal özet:
tutar indirim_orani
count 240.00 250.00
mean 205.24 0.15
std 123.18 0.09
min 30.81 0.00
25% 143.86 0.07
50% 187.52 0.15
75% 233.38 0.22
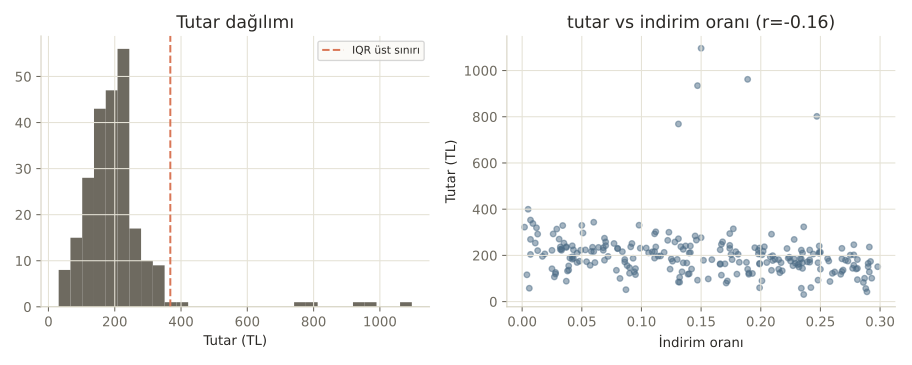
max 1096.38 0.30describe() çıktısında dikkat çeken bir şey var: tutar sütununun max değeri (1096.38), 75% çeyreğinden (233.38) çok uzak — bu, aykırı değerlerin bir işareti. Adım 2: kalite kontrolü (eksik ve aykırı).
Adım 2: Eksik ve aykırı kontrolü
# 2. adım: eksik ve aykırı değerleri (10. ve 11. ders) sistematik olarak kontrol et.
print(f"\nEksik değer sayısı:\n{siparisler.isna().sum()}")

gecerli_tutar = siparisler["tutar"].dropna()
q1, q3 = gecerli_tutar.quantile([0.25, 0.75])
iqr = q3 - q1
ust_sinir = q3 + 1.5 * iqr
aykiri_sayisi = (gecerli_tutar > ust_sinir).sum()
print(f"\nIQR üst sınırı: {ust_sinir:.2f} TL")
print(f"Üst sınırı aşan aykırı değer sayısı: {aykiri_sayisi}")
Eksik değer sayısı:
tutar            10
indirim_orani     0
kategori          0
dtype: int64

IQR üst sınırı: 367.66 TL
Üst sınırı aşan aykırı değer sayısı: 6
10 eksik tutar, 6 aykırı değer bulduk — 10. ve 11. derste öğrendiğimiz araçları burada rutin olarak uyguladık. Adım 3: ilişkilere bak.
Adım 3: İlişkiler
# 3. adım: değişkenler arası ilişkilere bak. İndirim oranı yüksekken tutar düşük mü?
korelasyon = siparisler[["tutar", "indirim_orani"]].corr().iloc[0, 1]
print(f"\ntutar ile indirim_orani arasındaki korelasyon: {korelasyon:.3f}")

kategori_ortalama = siparisler.groupby("kategori")["tutar"].mean().sort_values(ascending=False)
print(f"\nKategoriye göre ortalama tutar:\n{kategori_ortalama.round(2)}")
tutar ile indirim_orani arasındaki korelasyon: -0.157

Kategoriye göre ortalama tutar:
kategori
Elektronik    223.85
Ev & Yaşam    207.09
Giyim         199.84
Kitap         193.91
Name: tutar, dtype: float64
tutar ile indirim_orani arasında zayıf negatif bir korelasyon (-0.157) var — indirim arttıkça tutar hafifçe düşüyor gibi görünüyor (ama zayıf, kesin bir sonuç değil). Çoğu kişi EDA’yı “veriye bakıp birkaç grafik çizmek” sanır. Değil, çünkü sistemsiz bakış, önemli bir sorunu (eksik veri, aykırı değer) fark etmeden doğrudan yanlış bir modele veya yanlış bir karara gitmene yol açabilir — EDA’nın sırası, bu riskleri erken yakalamak için var.
Matematik
EDA'nın üç adımı
| Adım | Sorular | Kullanılan araçlar |
|---|---|---|
| 1. Genel bakış | Kaç satır/sütun var? Tipler doğru mu? | .shape, .dtypes, .head(), .describe() |
| 2. Kalite kontrolü | Eksik veri var mı? Aykırı değer var mı? | .isna().sum(), IQR/z-skoru (10-11. ders) |
| 3. İlişkiler | Değişkenler birbirini nasıl etkiliyor? | .corr(), .groupby(), serpme grafikleri |
Bu üç adım, bu kursun 5-11. derslerinde öğrendiğin her aracı tek bir tutarlı iş akışında birleştiriyor. EDA yeni bir araç değil — öğrendiğin araçları doğru sırada kullanma disiplinidir.
Kod
Nerede işe yarar
EDA, her veri projesinin ilk ve vazgeçilmez adımıdır:
- Model kurmadan önce. Bir makine öğrenmesi modeli eğitmeden önce EDA yapmamak, temeli sağlam olmayan bir binaya kat çıkmak gibidir.
- Yeni bir veri kaynağıyla çalışırken. Her yeni veri seti, kendine özgü kalite sorunları taşır — EDA bunları erken keşfeder.
- Paydaşlarla iletişimde. EDA bulguları (“veri setinin %4’ü eksik, birkaç aykırı değer var”) bir projenin güvenilirliğini şeffaf şekilde raporlamanın temelidir.
Bu 3 hatayı yaparsın:
- Doğrudan modele geçip EDA’yı atlamak — sonra modelin neden garip sonuçlar verdiğini anlayamamak.
- Sadece güzel görünen grafikleri çizip kalite kontrolünü (eksik, aykırı) atlamak.
- EDA’yı bir kerelik iş sanmak — yeni veri geldikçe veya veri güncellendikçe tekrar yapılması gerekir.
Kendini test et
1. EDA'nın "altın kuralı" olarak belirtilen sıralama nedir?
- Önce ilişkilere, sonra genel bakışa bak
- Önce genel bakış, sonra kalite kontrolü, sonra ilişkiler (doğru cevap)
- Sıra önemli değildir
- Önce model kur, sonra veriye bak
Neden: Genelden özele gitmek — önce büyük resim (shape, dtype), sonra kalite (eksik, aykırı), en son ilişkiler — henüz temizlenmemiş veride yanlış sonuçlar çıkarma riskini azaltır.
2. `describe()` çıktısında `max` değerinin `75%` çeyreğinden çok uzak olması ne anlama gelebilir?
- Hesaplama hatası olduğunu
- Veri setinde aykırı değerler olabileceğini (doğru cevap)
- Veri setinin boş olduğunu
- Hiçbir şey, bu normaldir
Neden: Q3'ten (75. yüzdelik) çok uzak bir max değeri, dağılımın uzun bir sağ kuyruğu (muhtemelen aykırı değerler) olduğunun ilk işaretidir — 11. derste öğrendiğimiz IQR yöntemiyle doğrulanabilir.
3. EDA neden "yeni bir araç" değil, "bir disiplin" olarak tanımlanıyor?
- Çünkü hiç kod gerektirmez
- Çünkü daha önce öğrenilen araçları (describe, isna, corr) belirli bir sırayla kullanma alışkanlığıdır (doğru cevap)
- Çünkü sadece büyük veri setlerinde uygulanır
- Çünkü sadece bir kez yapılır
Neden: EDA, 5-11. derslerde öğrenilen tekil araçları (shape, dtypes, isna, IQR, corr, groupby) tutarlı ve tekrarlanabilir bir sırada bir araya getiren bir iş akışıdır.
Özet
Özet
- EDA, veriyi tanımak için izlenen sistematik bir üç adımlı süreçtir: genel bakış → kalite kontrolü → ilişkiler.
- describe(), dtypes ve shape ile başlamak, veri setinin büyüklüğü ve yapısı hakkında hızlı bir resim verir.
- Eksik ve aykırı değer kontrolü, modellemeden veya karar vermeden ÖNCE yapılmalıdır.
- Korelasyon ve gruplama, değişkenler arası ilişkileri ortaya çıkarır — ama nedensellik göstermez (20. istatistik dersini hatırla).
- EDA bir kerelik değil, her yeni veya güncellenen veri setinde tekrarlanan bir alışkanlıktır.