

Veri okuma ve tip sorunları
Önkoşul:pandas: Series ve DataFrame
Kanca
Bir CSV’den sipariş verisi okudun. tutar sütunu gözle “1.250,50 TL” gibi bir sayı gibi görünüyor ama .sum() çağırınca hata alıyorsun — pandas bu sütunu metin (str) olarak okumuş. Neden, ve gerçek bir sayıya nasıl çevirirsin?
Sezgi
pandas, bir CSV sütununu okurken “bu sütundaki HER hücre sayı olarak ayrıştırılabiliyor mu?” diye kontrol eder. Tek bir hücre bile (“TL” eki, virgüllü ondalık, eksik değer işareti gibi) bu kontrolü geçemezse, pandas güvenli tarafta kalıp tüm sütunu metin olarak okur — yarısını sayı, yarısını metin bırakmaz.
Bu yüzden “veri okuma” aslında “veriyi doğru tipe zorlama” işidir — CSV’den gelen her şey ilk başta şüpheyle karşılanmalı. Görünüşte sayı olan bir sütun, gerçekte hep metin olarak gelebilir; görünüşte tarih olan bir sütun, farklı biçimlerin karışımı olabilir.
Mekanizma
Gerçekçi kirli bir CSV okuyalım:
Kirli CSV oku
# Gerçek dünyadan bir CSV parçası: tutarlar Türkçe biçimli ("1.250,50 TL"),
# bazı hücreler eksik ("-"), tarih sütunu tutarsız biçimlerde.
kirli_csv = """siparis_no,tutar,tarih,musteri_notu
S2001,"1.250,50 TL",2026-01-05,-
S2002,"89,90 TL",05/01/2026,İyi
S2003,-,2026-01-06,-
S2004,"340,00 TL",06.01.2026,Hızlı kargo
S2005,"1.899,00 TL",2026-01-07,-
"""

siparisler_ham = pd.read_csv(io.StringIO(kirli_csv))
print(siparisler_ham)
print(f"\ntutar sütununun dtype'ı: {siparisler_ham['tutar'].dtype}")
print("Bu sütunla toplama yapmaya çalışırsak hata alırız — sayı değil, metin.")
siparis_no tutar tarih musteri_notu
0 S2001 1.250,50 TL 2026-01-05 -
1 S2002 89,90 TL 05/01/2026 İyi
2 S2003 - 2026-01-06 -
3 S2004 340,00 TL 06.01.2026 Hızlı kargo
4 S2005 1.899,00 TL 2026-01-07 -
tutar sütununun dtype'ı: str
Bu sütunla toplama yapmaya çalışırsak hata alırız — sayı değil, metin.tutar sütununun dtype’ı str çıktı — “TL” eki ve virgüllü ondalık yüzünden pandas bunu sayı olarak tanıyamadı. Şimdi hem tutarı hem tarihi temizleyelim:
Tip düzeltme
# tutar sütununu temizle: "TL" ve boşlukları at, binlik ayıracı (.) sil, ondalık virgülü noktaya çevir.
def tutar_temizle(deger):
    if deger == "-" or pd.isna(deger):
        return np.nan
    return float(deger.replace(" TL", "").replace(".", "").replace(",", "."))

siparisler = siparisler_ham.copy()
siparisler["tutar"] = siparisler["tutar"].apply(tutar_temizle)

# Tarih sütunu ÜÇ farklı biçim karışımı: ISO (2026-01-05), gün/ay/yıl (05/01/2026),
# gün.ay.yıl (06.01.2026). pandas'ın otomatik "mixed" modu bunları karıştırabiliyor
# (ISO tarihleri bile ay/gün yer değiştirerek yanlış okuyabiliyor) — bu yüzden HER
# biçimi kendi kuralıyla, elle ayırt ediyoruz.
def tarih_temizle(deger):
    if re.fullmatch(r"\d{4}-\d{2}-\d{2}", deger):
        return pd.to_datetime(deger, format="%Y-%m-%d")
    if re.fullmatch(r"\d{2}/\d{2}/\d{4}", deger):
        return pd.to_datetime(deger, format="%d/%m/%Y")
    if re.fullmatch(r"\d{2}\.\d{2}\.\d{4}", deger):
        return pd.to_datetime(deger, format="%d.%m.%Y")
    raise ValueError(f"Tanınmayan tarih biçimi: {deger}")

siparisler["tarih"] = siparisler["tarih"].apply(tarih_temizle)

print(siparisler)
print(f"\ntutar dtype: {siparisler['tutar'].dtype}")
print(f"tarih dtype: {siparisler['tarih'].dtype}")
siparis_no tutar tarih musteri_notu
0 S2001 1250.5 2026-01-05 -
1 S2002 89.9 2026-01-05 İyi
2 S2003 NaN 2026-01-06 -
3 S2004 340.0 2026-01-06 Hızlı kargo
4 S2005 1899.0 2026-01-07 -
tutar dtype: float64
tarih dtype: datetime64[us]Tarih sütununda üç FARKLI biçim var aynı anda: 2026-01-05 (ISO), 05/01/2026 (gün/ay/yıl), 06.01.2026 (gün.ay.yıl). pandas’ın otomatik “mixed” modunu denediğimizde ISO tarihleri bile yanlış ayrıştırdı (ay ve günü karıştırdı) — bu yüzden her biçimi kendi deseniyle elle ayırt eden bir fonksiyon yazdık.
Çoğu kişi “pandas’ın otomatik tarih algılaması her zaman doğru çalışır” sanır. Değil, çünkü karışık biçimli tarihlerde otomatik algılama yanlış varsayımlar yapabilir — özellikle gün ve ayın ikisi de 12’den küçükse (05/01 gibi), hangisinin gün hangisinin ay olduğu biçime bakmadan asla kesin bilinemez.
Matematik
Tip dönüşümünün mantığı
Bu derste formül değil, bir karar ağacı var — her “kirli” hücre için:
| Durum | Yapılacak şey |
|---|---|
Sayı ama metin gibi görünüyor ("340,00 TL") | Bilinen kalıpları temizle (" TL", ".", ","), sonra float() ile çevir |
Eksik değer özel bir işaretle gösterilmiş ("-") | NaN’e çevir — pandas’ın “eksik” için evrensel dili |
| Tarih birden fazla biçimde | Deseni tanı (regex), her deseni kendi format’ıyla ayrıştır |
| Hangi biçimde olduğu belirsiz veri | Hata fırlat (raise ValueError) — sessizce yanlış bir tahmin yapmaktan iyidir |
Son satır önemli: tarih_temizle fonksiyonu, tanımadığı bir biçimle karşılaşınca sessizce yanlış bir şey üretmek yerine hata fırlatıyor. Sessiz bir yanlış, gürültülü bir hatadan daha tehlikelidir — hata en azından fark edilir.
Kod
Artık gerçek sayısal işlemler yapabiliyoruz:
Temizlenmiş veriyle işlem
# Artık gerçek sayısal işlemler yapabiliyoruz.
print(f"\nToplam ciro: {siparisler['tutar'].sum():.2f} TL")
print(f"Ortalama sipariş: {siparisler['tutar'].mean():.2f} TL")
print(f"Eksik tutar sayısı: {siparisler['tutar'].isna().sum()}")
print(f"En eski sipariş tarihi: {siparisler['tarih'].min().date()}")
Toplam ciro: 3579.40 TL
Ortalama sipariş: 894.85 TL
Eksik tutar sayısı: 1
En eski sipariş tarihi: 2026-01-05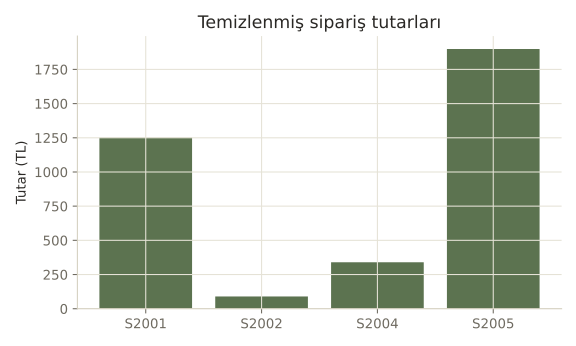
Nerede işe yarar
Veri okuma ve tip düzeltme, her gerçek veri projesinin ilk (ve genelde en uzun) adımıdır:
- Muhasebe ve finans verisi. Para birimleri, binlik ayraçlar, farklı ondalık gösterimleri (Türkçe virgül vs İngilizce nokta) sürekli karşına çıkar.
- Çoklu kaynaktan veri birleştirme. Farklı sistemlerden gelen veriler genelde farklı tarih/sayı biçimleri kullanır.
- Kullanıcı girdisi içeren veri. Serbest metin alanları (form girdileri gibi) neredeyse her zaman tutarsız biçimlerde gelir.
Bu 3 hatayı yaparsın:
- dtype kontrolü yapmadan doğrudan
.sum()veya.mean()çağırıp hatayla karşılaşmak. pd.to_datetime’ın otomatik biçim algılamasına karışık biçimli veride körü körüne güvenmek.- Eksik değerleri (
"-","N/A", boş hücre) fark etmeden bırakıp, onları da bir kategori/sayı gibi işlemeye çalışmak.
Kendini test et
1. Bir sayısal görünen sütun neden pandas tarafından `str` olarak okunabilir?
- pandas her zaman metni tercih eder
- Sütundaki en az bir hücre (örn. 'TL' eki, eksik değer işareti) doğrudan sayı olarak ayrıştırılamadığı için (doğru cevap)
- CSV dosyaları hiçbir zaman sayı içeremez
- Rastgele bir hata
Neden: pandas, sütundaki HER hücrenin sayı olarak ayrıştırılabilir olmasını arar; tek bir uyumsuz hücre (birim eki, farklı ondalık ayracı, eksik değer işareti) tüm sütunu metin olarak okutur.
2. Karışık biçimli tarih verisinde (`2026-01-05`, `05/01/2026` bir arada) pandas'ın otomatik "mixed" modu neden riskli olabilir?
- Hiçbir zaman riskli değildir
- ISO biçimli tarihleri bile yanlış ayrıştırıp ay ile günü karıştırabilir (doğru cevap)
- Sadece 2026 yılından önceki tarihlerde çalışır
- Sadece Türkçe tarihlerde sorun çıkarır
Neden: Notebook'ta tam olarak bunu gördük: format="mixed" + dayfirst=True, açıkça yıl-ay-gün sırasında olan ISO tarihleri bile yanlış ayrıştırdı. Her biçimi kendi deseniyle elle ayırt etmek daha güvenilirdir.
3. Tanınmayan bir tarih biçimiyle karşılaşınca fonksiyonun hata fırlatması (sessizce None döndürmek yerine) neden tercih edilir?
- Hata fırlatmak her zaman daha hızlıdır
- Sessiz bir yanlış veri, fark edilmeden ilerleyip yanlış sonuçlara yol açabilir; hata en azından görünür olur (doğru cevap)
- Python'da başka seçenek yoktur
- Hiçbir fark yaratmaz
Neden: Sessizce yanlış (veya eksik) bir değer üretmek, hatayı sonraki analizlerde gizler; açık bir hata fırlatmak sorunu kaynağında yakalamayı sağlar.
Özet
Özet
- pandas bir sütunu, TÜM hücreleri sayı olarak ayrıştırılabiliyorsa sayısal okur — tek bir uyumsuz hücre tüm sütunu metne çevirir.
- Sayısal görünen metin sütunlarını temizlemek için bilinen kalıpları (birim, ayraç) kaldırıp float() ile çevirmek standart yoldur.
- Karışık biçimli tarih verisinde otomatik algılamaya güvenmek yerine, her biçimi kendi deseniyle elle ayırt etmek daha güvenilirdir.
- Eksik değerleri (özel işaretlerle gösterilmiş olsalar bile) NaN'e çevirmek, sonraki analizlerin doğru çalışması için şarttır.
- Tanınmayan bir veri biçimiyle karşılaşınca sessizce yanlış tahmin yapmak yerine hata fırlatmak daha güvenlidir.