

groupby ve pivot
Önkoşul:Seçme, filtreleme, indeksleme
Kanca
- derste “her kategorinin ortalama tutarını” bulmak için 4 kategoriyi tek tek filtreleyip 4 ayrı
.mean()çağırmıştık. Ya 50 kategori olsaydı?siparisler.groupby("kategori")["tutar"].mean()— tek satır, kaç kategori olursa olsun.
Sezgi
groupby, “böl-uygula-birleştir” (split-apply-combine) mantığıyla çalışır: veriyi bir sütuna göre gruplara BÖLER, her gruba aynı işlemi UYGULAR, sonuçları tek bir tabloda BİRLEŞTİRİR. Bu, 7. derste elle yaptığımız “her kategori için filtrele, sonra ortalama al” döngüsünün, pandas içinde optimize edilmiş hâlidir.
pivot_table ise groupby’ın iki boyutlu bir sonucunu, bir Excel çapraz tablosu gibi DÜZLEŞTİRİR — satırlar bir kategori, sütunlar başka bir kategori olur, hücrelerde de özet değer durur.
Mekanizma
Tek bir sütuna göre gruplayarak başlayalım:
Tek sütuna göre groupby
# groupby: "kategoriye göre GRUPLA, sonra her grup için bir özet hesapla."
kategori_ozet = siparisler.groupby("kategori")["tutar"].mean()
print("Kategoriye göre ortalama tutar:")
print(kategori_ozet.sort_values(ascending=False))

# Aynı anda birden fazla istatistik: .agg()
kategori_detay = siparisler.groupby("kategori")["tutar"].agg(["count", "mean", "sum"])
print("\nKategori bazında sayı, ortalama, toplam:")
print(kategori_detay)
Kategoriye göre ortalama tutar:
kategori
Kitap 169.766410
Giyim 161.701429
Ev & Yaşam 160.827121
Elektronik 157.555773
Name: tutar, dtype: float64
Kategori bazında sayı, ortalama, toplam:
count mean sum
kategori
Elektronik 97 157.555773 15282.91
Ev & Yaşam 66 160.827121 10614.59
Giyim 98 161.701429 15846.74
Kitap 39 169.766410 6620.89.agg(["count", "mean", "sum"]) ile aynı anda birden fazla istatistik hesapladık — Kitap kategorisinin ortalama tutarı en yüksek (169.77 TL) ama sadece 39 siparişle en az satılan kategori. Şimdi iki sütuna birden gruplayalım:
Çoklu sütuna göre groupby
# Birden fazla sütuna göre gruplamak: liste ver.
bolge_kategori = siparisler.groupby(["bolge", "kategori"])["tutar"].mean()
print("\nBölge + kategori kırılımında ortalama tutar (ilk 8 satır):")
print(bolge_kategori.head(8))
print(f"\nSonucun tipi: {type(bolge_kategori).__name__}  (çok seviyeli indeksli bir Series)")
Bölge + kategori kırılımında ortalama tutar (ilk 8 satır):
bolge    kategori
Akdeniz  Elektronik    137.711154
         Ev & Yaşam    227.546000
         Giyim         162.902667
         Kitap         117.888000
Ege      Elektronik    152.400000
         Ev & Yaşam    157.511852
         Giyim         152.267222
         Kitap         146.330000
Name: tutar, dtype: float64

Sonucun tipi: Series  (çok seviyeli indeksli bir Series)
Sonuç, çok seviyeli (multi-index) bir Series — her satır hem bölge hem kategori etiketi taşıyor. Bu okunabilir ama bir “tablo” gibi görünmüyor. Çoğu kişi bu noktada “veri kayboldu” sanır. Değil, çünkü veri kaybolmadı, sadece iki boyutlu bir bilgiyi tek boyutlu (uzun formatlı) bir yapıda tutuyoruz — pivot_table bunu görsel olarak daha tanıdık bir tabloya çevirir.
Matematik
groupby'ın üç adımı
| Adım | Ne olur |
|---|---|
| Böl (split) | Veri, gruplama sütunundaki her benzersiz değer için ayrı bir alt kümeye ayrılır |
| Uygula (apply) | Her alt kümeye aynı fonksiyon (ortalama, toplam, sayım…) uygulanır |
| Birleştir (combine) | Her grubun sonucu, tek bir Series veya DataFrame’de bir araya getirilir |
pivot_table(values=, index=, columns=, aggfunc=) aslında groupby([index, columns])[values].agg(aggfunc) ile aynı hesabı yapar — tek fark, sonucu çok seviyeli bir Series yerine iki boyutlu bir tabloya “yayar” (unstack eder).
Kod
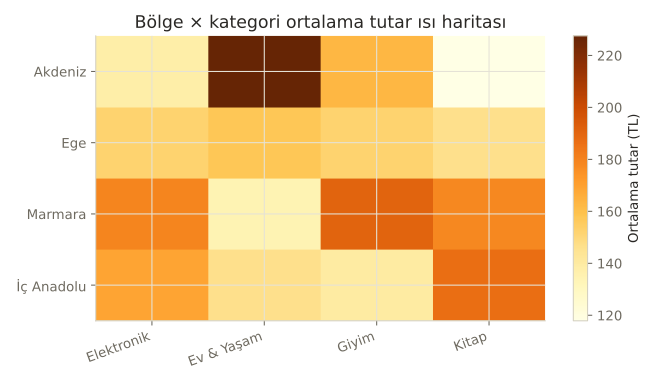
Aynı bölge×kategori kırılımını pivot_table ile gerçek bir tabloya çevirelim:
pivot_table ile çapraz tablo
# pivot_table: aynı iki-boyutlu kırılımı, bir Excel çapraz tablosu gibi DÜZLEŞTİRİR.
capraz_tablo = siparisler.pivot_table(values="tutar", index="bolge", columns="kategori", aggfunc="mean")
print("\nÇapraz tablo (bölge × kategori):")
print(capraz_tablo.round(1))
Çapraz tablo (bölge × kategori):
kategori    Elektronik  Ev & Yaşam  Giyim  Kitap
bolge
Akdeniz          137.7       227.5  162.9  117.9
Ege              152.4       157.5  152.3  146.3
Marmara          179.4       134.2  191.1  178.3
İç Anadolu       169.2       146.4  139.8  186.9
Şimdi bölgeler satırda, kategoriler sütunda — Excel’deki “PivotTable” özelliğiyle birebir aynı mantık.
Nerede işe yarar
groupby ve pivot_table, veri özetlemenin en sık kullanılan iki aracıdır:
- İş raporlama. “Aya göre, bölgeye göre satış” gibi çapraz özetler doğrudan pivot_table ile üretilir.
- Kohort analizi. Kullanıcıları kayıt ayına göre gruplayıp, her kohortun davranışını karşılaştırmak.
- A/B test sonuçları. Test grubuna göre gruplayıp her grubun ortalama metriğini karşılaştırmak — 14. derste z-testiyle birleşen bir adım.
Bu 3 hatayı yaparsın:
- groupby sonucunu “kayıp veri” sanıp
pivot_tableyerine tekrar filtrelemeye dönmek. aggfuncbelirtmeden pivot_table çağırıp varsayılan (ortalama) davranışın beklentiyle uyuşmadığını fark etmemek.- Çok seviyeli indeksli bir Series’e normal tek seviyeli bir Series gibi erişmeye çalışmak —
.loc[("Ege", "Kitap")]gibi bir demet (tuple) gerekir.
Kendini test et
1. groupby'ın "böl-uygula-birleştir" mantığında "uygula" adımında ne olur?
- Veri gruplara ayrılır
- Her gruba aynı özet fonksiyonu (ortalama, toplam vb.) uygulanır (doğru cevap)
- Sonuçlar tek tabloda birleştirilir
- Veri silinir
Neden: "Böl" veriyi gruplara ayırır, "uygula" her gruba aynı fonksiyonu (mean, sum, count gibi) uygular, "birleştir" sonuçları tek bir yapıda toplar.
2. `siparisler.groupby(["bolge", "kategori"])["tutar"].mean()` ifadesinin sonucu neden "kaybolmuş" gibi görünebilir?
- Veri gerçekten kaybolmuştur
- Sonuç çok seviyeli (multi-index) bir Series'tir, tanıdık bir tablo görünümünde değildir ama tüm bilgiyi içerir (doğru cevap)
- groupby hatalıdır
- Sadece ilk grup gösterilir
Neden: İki sütuna göre gruplamanın sonucu, her iki etiketi de taşıyan çok seviyeli bir indekse sahiptir — veri kaybolmaz, sadece görünüm "uzun format"tadır.
3. pivot_table, groupby ile elde edilen sonuçtan farklı olarak ne yapar?
- Farklı bir hesaplama yapar
- Aynı hesabı yapar ama sonucu iki boyutlu, satır×sütun şeklinde bir tabloya yayar (doğru cevap)
- Veriyi filtreler
- Hiçbir farkı yoktur, aynı fonksiyondur
Neden: pivot_table, groupby([index, columns])[values].agg(aggfunc) ile aynı hesabı yapıp sonucu "unstack" ederek iki boyutlu, Excel çapraz tablosu formatına çevirir.
Özet
Özet
- groupby, "böl-uygula-birleştir" mantığıyla veriyi bir sütuna göre gruplayıp her gruba özet fonksiyon uygular.
- .agg(["count","mean","sum"]) ile aynı anda birden fazla istatistik hesaplanabilir.
- Birden fazla sütuna göre gruplamak çok seviyeli (multi-index) bir sonuç üretir.
- pivot_table, aynı gruplama hesabını iki boyutlu, tanıdık bir çapraz tabloya dönüştürür.
- aggfunc parametresini her zaman açıkça belirtmek, beklenmedik varsayılan davranışları önler.