

Veri bilimi süreci: soru → veri → model → karar
Kanca
Bir e-ticaret sitesinin sepet terk etme oranı yüksek. “Veri bilimiyle çözelim” diyorsun — ama nereden başlıyorsun? Elindeki veriyi açıp rastgele grafikler mi çiziyorsun, yoksa bir sıra mı var? 2000 sipariş denemesiyle bu süreci baştan sona, gerçek bir kararla bitirecek şekilde yürütüyoruz.
Sezgi
Veri bilimi, “veriye bak ve bir şeyler bul” değildir — bu, sonu belirsiz bir keşif gezisine çıkmaktır. Gerçek süreç dört adımlı bir döngüdür: önce net bir SORU sor, sonra o soruyu cevaplayacak VERİYİ topla, veriyi anlaşılır bir MODELE (çoğu zaman basit bir karşılaştırma bile olur) indirgeyip, sonunda somut bir KARAR ver ve etkisini ölç.
Sondaki “karar” adımı olmayan bir analiz, veri bilimi değil sadece meraktır. Her adım bir sonrakini kısıtlar: net olmayan bir soru, hangi veriyi toplayacağını bilemezsin demektir; yanlış veri, ne kadar iyi bir model kursan da yanlış sonuç verir.
Mekanizma
Somut bir örnekle ilerleyelim.
- SORU. “Sepet terk etme oranını nasıl azaltırız?” — çok genel. Daha keskin bir soruya indirgeyelim: “Kargo ücretinin ödeme adımına kadar gizli kalması, terk etme oranını artırıyor mu?”
- VERİ. Bu soruyu cevaplayacak veriyi topla: 2000 sipariş denemesi, yarısında kargo ücreti baştan görünür, yarısında ödeme adımına kadar gizli.
Soru ve veri
# SORU: "Sepet terk etme oranını nasıl azaltırız?"
# VERİ: 2000 sipariş denemesi. Bir kısmında kargo ücreti ödeme adımına kadar
# gizli kaldı (sürpriz oldu), bir kısmında baştan gösterildi.
n = 2000
kargo_gizli = rng.random(n) < 0.5  # deneylerin yarısında kargo ücreti gizli

# Kargo gizliyken terk etme olasılığı daha yüksek olsun (gerçek dünya deseni)
terk_olasiligi = np.where(kargo_gizli, 0.42, 0.24)
terk_etti = rng.random(n) < terk_olasiligi

print(f"Toplam deneme: {n}")
print(f"Kargo ücreti gizli olan: {kargo_gizli.sum()}")
print(f"Kargo ücreti baştan görünen: {(~kargo_gizli).sum()}")
Toplam deneme: 2000
Kargo ücreti gizli olan: 1008
Kargo ücreti baştan görünen: 992- MODEL. Burada “model” karmaşık bir makine öğrenmesi algoritması değil — iki grubun terk etme oranını karşılaştırmak.
Basit ama net bir model
# MODEL: karmaşık bir makine öğrenmesi modeline gerek yok — burada "model" basitçe
# iki grubun terk etme oranını karşılaştırmak. Bazen en iyi model en basit olandır.
oran_gizli = terk_etti[kargo_gizli].mean()
oran_gorunur = terk_etti[~kargo_gizli].mean()

print(f"\nKargo gizliyken terk etme oranı:  %{oran_gizli * 100:.1f}")
print(f"Kargo görünürken terk etme oranı: %{oran_gorunur * 100:.1f}")
print(f"Fark: {(oran_gizli - oran_gorunur) * 100:.1f} puan")
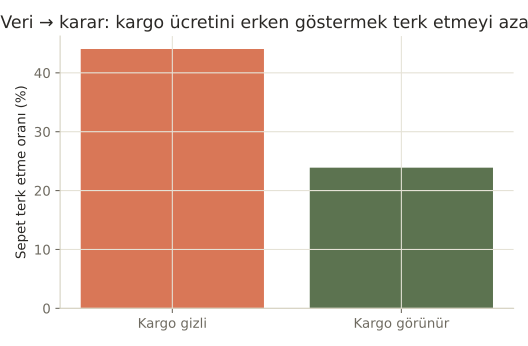
Kargo gizliyken terk etme oranı:  %44.0
Kargo görünürken terk etme oranı: %23.9
Fark: 20.2 puan
Kargo gizliyken terk etme %44.0, görünürken %23.9 — 20.2 puanlık bir fark. Çoğu kişi “veri bilimi” deyince akla hemen karmaşık modeller gelir. Değil, çünkü burada iki oranı karşılaştırmak sorunun cevabı için fazlasıyla yeterli — daha karmaşık bir model, daha iyi bir karar anlamına gelmez.
- KARAR. Bulguyu somut bir karara çevir ve etkisini tahmin et:
Kararın etkisini tahmin et
# KARAR: kargo ücretini sepetin en başında göster. Bu kararın olası etkisini
# mevcut trafiğe uygulayarak tahmin edelim.
aylik_ziyaretci = 50_000
mevcut_terk_sayisi = aylik_ziyaretci * oran_gizli
yeni_terk_sayisi = aylik_ziyaretci * oran_gorunur
kurtarilan_siparis = mevcut_terk_sayisi - yeni_terk_sayisi

print(f"\nAylık {aylik_ziyaretci} ziyaretçide:")
print(f"Mevcut durumda tahmini terk: {mevcut_terk_sayisi:.0f} sipariş")
print(f"Karardan sonra tahmini terk: {yeni_terk_sayisi:.0f} sipariş")
print(f"Kurtarılması beklenen sipariş: {kurtarilan_siparis:.0f} / ay")
Aylık 50000 ziyaretçide:
Mevcut durumda tahmini terk: 22024 sipariş
Karardan sonra tahmini terk: 11946 sipariş
Kurtarılması beklenen sipariş: 10078 / ay
Kargo ücretini baştan göstermek, ayda tahmini 10.078 siparişi kurtarabilir. İşte veri bilimi süreci burada biter — bir grafik değil, ölçülebilir bir iş kararı.
Matematik
Sürecin dört adımı
Bu derste formül yok — ama sürecin kendisi bir “formül” gibi işler: her adım bir öncekinin çıktısını girdi olarak alır.
| Adım | Girdi | Çıktı |
|---|---|---|
| Soru | İş problemi (belirsiz) | Test edilebilir, keskin bir soru |
| Veri | Soru | Sorunun cevabı için gereken, doğru ölçülmüş veri |
| Model | Veri | Veriyi özetleyen bir sayı, oran veya kural |
| Karar | Model çıktısı | Somut bir eylem + beklenen etki tahmini |
Bir adım atlanırsa (örn. doğrudan veriye bakıp soru sormadan model kurmak), sonuç genelde “ilginç ama eyleme dönüşmeyen” bir bulgu olur.
Kod
Nerede işe yarar
Bu döngü, veri biliminin yapıldığı her yerde (şirket içi analiz, akademik araştırma, ürün kararları) aynı şekilde işler:
- Ürün kararları. Bir özelliği yayınlamadan önce “bu değişiklik gerçekten metriği etkiliyor mu” sorusunu bu döngüyle test etmek.
- Pazarlama. Hangi kanalın gerçekten dönüşüm getirdiğini bulup bütçeyi ona göre kaydırmak.
- Operasyon. Bir sürecin neresinde zaman kaybedildiğini bulup, o adımı değiştirme kararı almak.
Bu 3 hatayı yaparsın:
- Net bir soru olmadan doğrudan veriye dalmak — sonunda “ilginç ama ne yapacağımı bilmiyorum” bulgularla çıkarsın.
- Kararı atlayıp analizi rapor olarak bırakmak — veri bilimi bir sunum değil, bir eylemdir.
- Basit bir karşılaştırmanın yeterli olduğu yerde gereksiz karmaşık bir model kurmaya çalışmak.
Kendini test et
1. Veri bilimi sürecinin dört adımı hangi sırayla ilerler?
- Model → Veri → Soru → Karar
- Soru → Veri → Model → Karar (doğru cevap)
- Veri → Soru → Karar → Model
- Karar → Soru → Veri → Model
Neden: Önce net bir soru sorulur, bu soruyu cevaplayacak veri toplanır, veri bir modelle özetlenir, ve sonunda somut bir karara dönüştürülür.
2. Notebook örneğinde "model" adımında neden karmaşık bir makine öğrenmesi algoritması kullanılmadı?
- Veri yetersizdi
- İki grubun oranını karşılaştırmak, sorunun cevabı için zaten yeterliydi (doğru cevap)
- Karmaşık modeller bu tür sorularda hiç kullanılmaz
- Zaman kısıtlıydı
Neden: Model, soruya en basit ve en anlaşılır şekilde cevap veren araçtır — burada iki oranı karşılaştırmak yeterliydi, daha karmaşık bir model gereksiz olurdu.
3. "Karar" adımı neden sürecin en kritik parçası sayılır?
- En çok zaman aldığı için
- Analizi ölçülebilir bir eyleme çevirmeden veri bilimi sadece merak olarak kalır (doğru cevap)
- En karmaşık matematiği içerdiği için
- Diğer adımlardan daha kolay olduğu için
Neden: Bir bulgu, somut bir karara ve beklenen etki tahminine dönüşmedikçe iş değeri üretmez — süreç burada tamamlanır.
Özet
Özet
- Veri bilimi süreci dört adımdır: soru → veri → model → karar.
- Net olmayan bir soru, doğru veriyi toplamayı imkansızlaştırır.
- Model, veriyi soruya cevap verecek şekilde özetleyen araçtır — her zaman karmaşık olması gerekmez.
- Süreç, ölçülebilir bir kararla ve beklenen etki tahminiyle biter — raporla değil.
- Bu döngü, kursun geri kalanındaki her aracın (NumPy, pandas, görselleştirme) neden var olduğunu açıklar.