

Öznitelik mühendisliği, ölçekleme ve kodlama
Önkoşul:seaborn: hangi grafik ne zaman
Kanca
Bir sipariş verisinde tutar sütunu 12 ile 715 arasında, adet sütunu 1 ile 5 arasında değişiyor. İkisini birlikte bir modele verirsen, model “tutar”ı “adet”ten 100 kat daha önemli sanabilir — sadece sayıları büyük olduğu için. Bu sorunu nasıl çözeriz, ve kategori gibi metin sütunlarını modele nasıl anlatırız?
Sezgi
Bu ders üç ayrı ama birbiriyle ilişkili hazırlık adımını kapsıyor: öznitelik mühendisliği (var olan sütunlardan modele daha faydalı yeni sütunlar türetmek), ölçekleme (sayısal sütunları aynı “birime” getirmek, böylece hiçbiri sırf büyük sayılı olduğu için haksız ağırlık kazanmasın) ve kodlama (kategorik sütunları modelin anlayabileceği sayılara çevirmek).
Çoğu makine öğrenmesi modeli sayılarla çalışır ve büyük sayıları “daha önemli” sanma eğilimindedir — ölçekleme bu yanlış izlenimi düzeltir. Kategorik veri ise modelin hiç anlamadığı bir dildir — kodlama bu dili sayıya çevirir.
Mekanizma
Önce öznitelik mühendisliği: var olan sütunlardan yeni, daha anlamlı sütunlar türetelim.
Yeni öznitelik türetme
# Öznitelik mühendisliği: VAR OLAN sütunlardan, modele daha faydalı YENİ bir sütun türetmek.
siparisler["birim_fiyat"] = (siparisler["tutar"] / siparisler["adet"]).round(2)
siparisler["buyuk_siparis_mi"] = (siparisler["adet"] >= 4).astype(int)

print("Türetilmiş öznitelikler:")
print(siparisler[["tutar", "adet", "birim_fiyat", "buyuk_siparis_mi"]].head())
print(f"\nbirim_fiyat, ham tutardan daha anlamlı bir sinyal olabilir — 'bu sipariş neden pahalı,")
print("çok mu ürün aldı yoksa ürünler mi pahalıydı' sorusunu ayırt ediyor.")
Türetilmiş öznitelikler:
tutar adet birim_fiyat buyuk_siparis_mi
0 167.35 2 83.68 0
1 226.83 2 113.42 0
2 146.98 3 48.99 0
3 131.61 1 131.61 0
4 246.34 5 49.27 1
birim_fiyat, ham tutardan daha anlamlı bir sinyal olabilir — 'bu sipariş neden pahalı,
çok mu ürün aldı yoksa ürünler mi pahalıydı' sorusunu ayırt ediyor.birim_fiyat, ham tutarın göstermediği bir bilgiyi ortaya çıkarıyor: pahalılığın sebebi çok ürün mü, yoksa pahalı ürün mü? Şimdi ölçekleme sorununa bakalım:
StandardScaler ve MinMaxScaler
# tutar (10-500 aralığında) ve adet (1-5 aralığında) ÇOK FARKLI ölçeklerde.
# Mesafeye dayalı modeller (KNN gibi, makine öğrenmesi kategorisinde göreceğiz) bu farktan yanılır.
print(f"\ntutar aralığı: [{siparisler['tutar'].min():.0f}, {siparisler['tutar'].max():.0f}]")
print(f"adet aralığı:  [{siparisler['adet'].min()}, {siparisler['adet'].max()}]")

standart_olcekleyici = StandardScaler()
minmax_olcekleyici = MinMaxScaler()

sayisal_sutunlar = ["tutar", "adet"]
standart_olcekli = standart_olcekleyici.fit_transform(siparisler[sayisal_sutunlar])
minmax_olcekli = minmax_olcekleyici.fit_transform(siparisler[sayisal_sutunlar])

print(f"\nStandardScaler sonrası ortalama: {standart_olcekli.mean(axis=0).round(3)}  (her sütun ~0 ortalama, ~1 std)")
print(f"MinMaxScaler sonrası aralık: [{minmax_olcekli.min(axis=0).round(2)}, {minmax_olcekli.max(axis=0).round(2)}]  (her sütun 0-1 arası)")
tutar aralığı: [12, 715]
adet aralığı:  [1, 5]

StandardScaler sonrası ortalama: [ 0. -0.]  (her sütun ~0 ortalama, ~1 std)
MinMaxScaler sonrası aralık: [[0. 0.], [1. 1.]]  (her sütun 0-1 arası)
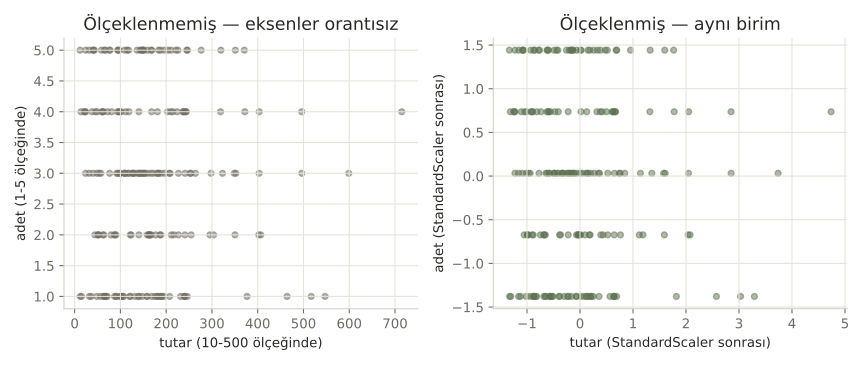
tutar (12-715) ve adet (1-5) çok farklı aralıklarda. StandardScaler, her sütunu ortalaması 0, standart sapması 1 olacak şekilde dönüştürüyor; MinMaxScaler ise her sütunu 0-1 aralığına sıkıştırıyor. İkisinden sonra da tutar ve adet artık “aynı birimde” — biri diğerini büyüklüğünden dolayı ezmiyor.
Çoğu kişi “sayılar zaten sayı, model bunu anlar” sanır. Değil, çünkü özellikle mesafeye dayalı modeller (K-En Yakın Komşu gibi, makine öğrenmesi kategorisinde göreceğiz) iki nokta arasındaki farkı doğrudan sayısal büyüklükle ölçer — ölçeklenmemiş veride tutardaki 100 birimlik fark, adetteki 100 birimlik farktan (ki mümkün bile değil, adet en fazla 5) “daha önemli” görünür.
Matematik
Ölçekleme formülleri
| Yöntem | Sonuç aralığı | Ne zaman tercih edilir |
|---|---|---|
| StandardScaler | Ortalama 0, std 1 (sınırsız aralık) | Veri yaklaşık Normal dağılıyorsa, aykırı değer azsa |
| MinMaxScaler | Tam olarak [0, 1] | Sınırlı bir aralık gerekiyorsa (örn. görüntü pikselleri) |
StandardScaler formülü tanıdık geliyor mu? 6. istatistik dersindeki z-skoru ile birebir aynı — ölçekleme, aslında her sütunu kendi z-skoruna çevirmekten başka bir şey değil.
Kod
Şimdi kategorik kategori sütununu sayıya çevirelim:
One-hot encoding
# Kategorik sütunlar sayısal DEĞİLDİR — modele vermeden önce sayıya çevrilmeli.
# One-hot encoding: her kategori için ayrı bir 0/1 sütun oluşturur.
kodlanmis = pd.get_dummies(siparisler[["kategori"]], prefix="kategori")
print(f"\nOne-hot encoding öncesi: 1 sütun (kategori)")
print(f"One-hot encoding sonrası: {kodlanmis.shape[1]} sütun")
print(kodlanmis.head())
One-hot encoding öncesi: 1 sütun (kategori)
One-hot encoding sonrası: 3 sütun
   kategori_Elektronik  kategori_Giyim  kategori_Kitap
0                False            True           False
1                 True           False           False
2                False           False            True
3                 True           False           False
4 True False Falsepd.get_dummies, her kategori için ayrı bir True/False sütunu oluşturdu — 1 sütun, 3 sütuna dönüştü. Bu one-hot encoding: her satırda sadece kendi kategorisine ait sütun True, diğerleri False.
Nerede işe yarar
Bu üç hazırlık adımı, neredeyse her makine öğrenmesi projesinin ön işleme aşamasında yer alır:
- Mesafeye dayalı modeller. K-En Yakın Komşu, K-Means kümeleme (makine öğrenmesi kategorisi) ölçeklenmemiş veride yanlış sonuç verir.
- Gradyan inişi kullanan modeller. Lojistik regresyon, sinir ağları (derin öğrenme kategorisi) ölçeklenmiş veride çok daha hızlı ve kararlı öğrenir.
- Kategorik veri içeren her model. Ağaç tabanlı modeller (Karar Ağaçları, Random Forest) bazen ölçeklemeye ihtiyaç duymaz ama kodlamaya her zaman ihtiyaç duyar.
Bu 3 hatayı yaparsın:
- Ölçeklemeyi atlayıp mesafeye dayalı bir modelin garip sonuçlar verdiğini fark etmemek.
- One-hot encoding sonrası oluşan çok sayıda sütunu (yüksek kardinaliteli bir kategori için) fark etmeden modele vermek — bu “boyut patlaması” yaratabilir.
- Ölçekleyiciyi (scaler) TEST verisine ayrı ayrı
fitetmek — 16. derste tam olarak bu hatanın veri sızıntısına yol açtığını göreceğiz.
Kendini test et
1. tutar (12-715) ve adet (1-5) sütunlarını ölçeklemeden bir mesafeye dayalı modele vermek neden sorunlu olabilir?
- Hiçbir zaman sorun olmaz
- tutar'daki sayısal farklar, sadece daha büyük ölçekli olduğu için adet'teki farklardan daha 'önemli' görünebilir (doğru cevap)
- Model hata verir, çalışmaz
- Sadece kategorik verilerde sorun olur
Neden: Mesafeye dayalı modeller iki nokta arasındaki farkı doğrudan sayısal büyüklükle ölçer; ölçeklenmemiş veride büyük ölçekli bir sütun, küçük ölçekli bir sütunun etkisini gölgeler.
2. StandardScaler formülü, hangi istatistiksel kavramla birebir aynıdır?
- Medyan
- z-skoru (doğru cevap)
- IQR
- Mod
Neden: StandardScaler, (x - ortalama) / std formülünü uygular — bu, istatistik dersindeki z-skorunun ta kendisidir.
3. One-hot encoding bir kategorik sütunu nasıl dönüştürür?
- Kategorileri rastgele sayılara çevirir
- Her kategori için ayrı bir True/False (0/1) sütun oluşturur (doğru cevap)
- Kategorileri siler
- Kategorileri tek bir ortalama değere indirger
Neden: One-hot encoding, N kategorili bir sütunu N ayrı sütuna dönüştürür; her satırda sadece kendi kategorisine karşılık gelen sütun True (1) olur.
Özet
Özet
- Öznitelik mühendisliği, var olan sütunlardan modele daha faydalı yeni sütunlar türetmektir.
- Ölçekleme (StandardScaler, MinMaxScaler), farklı büyüklükteki sayısal sütunları aynı "birime" getirir.
- StandardScaler formülü, istatistikteki z-skoru ile birebir aynıdır.
- One-hot encoding, kategorik bir sütunu modelin anlayabileceği 0/1 sütunlarına dönüştürür.
- Ölçekleyici ve kodlayıcıyı eğitim ve test verisine AYRI ayrı uygulamak, veri sızıntısına yol açar (bir sonraki ders).