

seaborn: hangi grafik ne zaman
Önkoşul:matplotlib ile grafiğin anatomisi
Kanca
Elindeki veriye bakıp “hangi grafiği çizsem?” diye düşünüyorsun. Histogram mı, kutu grafiği mi, serpme grafik mi? Cevap rastgele bir tercih değil — elindeki değişken SAYISI ve TİPİ, doğru grafiği neredeyse otomatik olarak belirler.
Sezgi
Grafik seçimi bir karar ağacıdır: önce kaç değişkeni birlikte incelediğine bak (bir mi, iki mi), sonra bu değişkenlerin sayısal mı kategorik mi olduğuna bak. Bu iki soru, doğru grafik türünü neredeyse her zaman tek başına belirler.
1. Kaç değişkeni incelemek istiyorsun?
2. Veri tipi?
Histogram
Tek sayısal değişkenin dağılım şeklini (simetrik mi, çarpık mı, kaç tepeli) gösterir.
sns.histplot(data=df, x="tutar")Farklı kombinasyonları dene: tek sayısal değişken histogram ister, iki sayısal değişken serpme grafik ister, sayısal+kategorik kutu grafiği ister. Bu ezber değil — her grafik türü, o veri kombinasyonunun sorusuna en doğal cevabı verdiği için seçilir.
Mekanizma
seaborn, bu grafikleri matplotlib’e göre çok daha az kodla üretir çünkü DataFrame’i doğrudan anlar:
matplotlib vs seaborn
# matplotlib'te kategoriye göre kutu grafiği çizmek için elle her kategoriyi ayırman gerekir.
kategoriler = siparisler["kategori"].unique()
veri_gruplari = [siparisler[siparisler["kategori"] == k]["tutar"].values for k in kategoriler]
print(f"matplotlib ile: her kategoriyi elle ayırmak gerekiyor — {len(veri_gruplari)} ayrı dizi hazırladık.")

# seaborn ile: DataFrame'i doğrudan veriyorsun, sütun adlarını söylüyorsun, o gruplamayı kendi yapıyor.
print("seaborn ile: sns.boxplot(data=siparisler, x='kategori', y='tutar') — TEK SATIR, gruplama otomatik.")
matplotlib ile: her kategoriyi elle ayırmak gerekiyor — 4 ayrı dizi hazırladık.
seaborn ile: sns.boxplot(data=siparisler, x='kategori', y='tutar') — TEK SATIR, gruplama otomatik.matplotlib’te her kategoriyi elle ayırmak gerekirken, seaborn’a sadece “hangi sütun x, hangi sütun y” demen yetiyor — gruplama işini kendisi yapıyor. Şimdi dört temel grafiği görelim:
histplot ve boxplot
# İki klasik seaborn grafiği: histplot (dağılım) ve boxplot (kategoriye göre karşılaştırma).
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(10, 4))

sns.histplot(data=siparisler, x="tutar", kde=True, ax=ax1, color="#d97757")
ax1.set_title("histplot: dağılım şekli")

sns.boxplot(data=siparisler, x="kategori", y="tutar", ax=ax2)
ax2.set_title("boxplot: kategoriye göre karşılaştırma")
plt.setp(ax2.get_xticklabels(), rotation=15, ha="right")

fig.tight_layout()
fig.savefig("scripts/figures/veri-bilimi/14-dagilim-ve-kategori.svg")
print("\nFigür kaydedildi: scripts/figures/veri-bilimi/14-dagilim-ve-kategori.svg")
Figür kaydedildi: scripts/figures/veri-bilimi/14-dagilim-ve-kategori.svg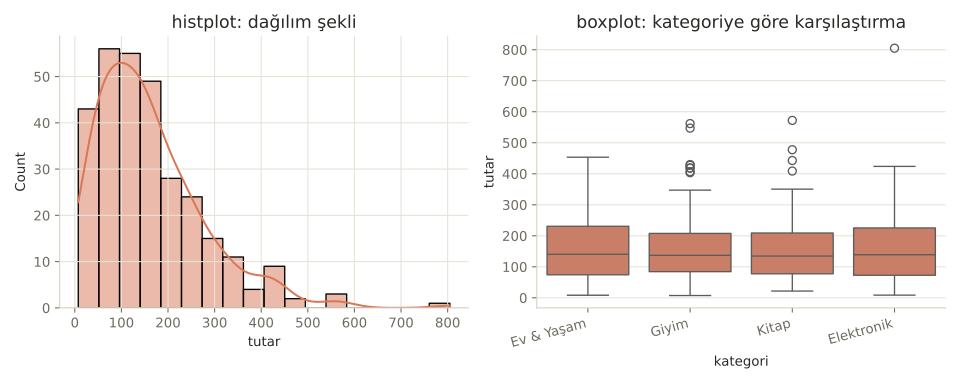
Çoğu kişi “her veri için bar chart yeterlidir” sanır. Değil, çünkü bar chart sadece kategori bazında TEK bir özet sayı (ortalama, toplam) gösterir — bir kutu grafiğinin gösterdiği dağılım şeklini, medyanı, aykırı değerleri gizler. Veri tipini yanlış grafikle eşleştirmek, gerçek örüntüyü gözden kaçırmana yol açar.
Matematik
Grafik seçim tablosu
| Değişken sayısı | Tipler | Grafik | Soru |
|---|---|---|---|
| 1 | Sayısal | Histogram (histplot) | Dağılım nasıl şekilli? |
| 1 | Kategorik | Çubuk grafik (countplot) | Hangi kategori ne kadar sık? |
| 2 | Sayısal + Sayısal | Serpme grafik (scatterplot) | Aralarında ilişki var mı? |
| 2 | Sayısal + Kategorik | Kutu grafiği (boxplot) | Kategoriler arası dağılım nasıl farklı? |
| 2 | Kategorik + Kategorik | Isı haritası (heatmap + crosstab) | Hangi kombinasyon ne kadar sık? |
Bu tablo ezberlenecek bir kural listesi değil — her satırın mantığı, o veri tipinin “doğal sorusuna” en kısa yoldan cevap vermesidir.
Kod
İki sayısal ve iki kategorik değişken kombinasyonunu da görelim:
scatterplot ve heatmap
# İki sayısal değişken arasındaki ilişki için scatterplot, kategorik×kategorik için heatmap.
siparisler["indirim_orani"] = rng.uniform(0, 0.3, size=n).round(3)

fig2, (ax3, ax4) = plt.subplots(1, 2, figsize=(10, 4))

sns.scatterplot(data=siparisler, x="indirim_orani", y="tutar", hue="kategori", alpha=0.6, ax=ax3, s=25)
ax3.set_title("scatterplot: iki sayısal değişken")
ax3.legend(fontsize=7, title_fontsize=8)

kontenjans = pd.crosstab(siparisler["kategori"], siparisler["bolge"])
sns.heatmap(kontenjans, annot=True, fmt="d", cmap="YlOrBr", ax=ax4, cbar=False)
ax4.set_title("heatmap: iki kategorik değişken")
plt.setp(ax4.get_xticklabels(), rotation=15, ha="right")

fig2.tight_layout()
fig2.savefig("scripts/figures/veri-bilimi/14-iliski-ve-isi.svg")
print("Figür kaydedildi: scripts/figures/veri-bilimi/14-iliski-ve-isi.svg")

print(f"\nKontenjans tablosu (kategori × bölge):\n{kontenjans}")
Figür kaydedildi: scripts/figures/veri-bilimi/14-iliski-ve-isi.svg
Kontenjans tablosu (kategori × bölge):
bolge Akdeniz Ege Marmara İç Anadolu
kategori
Elektronik 26 30 19 22
Ev & Yaşam 10 27 13 16
Giyim 30 18 24 26
Kitap 5 5 14 15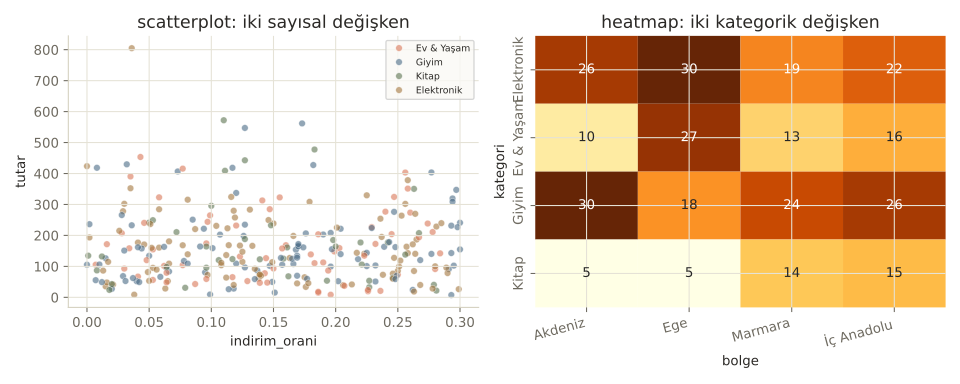
Nerede işe yarar
Doğru grafik seçimi, veri hikayesini doğru anlatmanın temelidir:
- EDA raporları. 12. derste öğrendiğimiz EDA sürecinin “ilişkiler” adımında hangi grafiği çizeceğini bu karar ağacıyla belirlersin.
- Sunumlar ve raporlar. Yanlış grafik türü (örn. çok kategorili veride pasta grafiği), izleyiciyi yanıltabilir veya okumayı zorlaştırabilir.
- Hızlı keşif. Yeni bir veri setiyle karşılaştığında, bu karar ağacı hangi grafikle başlayacağını saniyeler içinde belirlemeni sağlar.
Bu 3 hatayı yaparsın:
- Her durumda aynı grafik türünü (genelde çubuk grafik) kullanmaya alışmak.
- Kategorik değişkeni sayısalmış gibi bir serpme grafikte göstermeye çalışmak.
- Çok fazla kategorisi olan bir değişkeni ısı haritası veya kutu grafiğinde göstermek — okunamaz hale gelir, önce grupları azaltmak (en sık N kategori + “diğer”) gerekir.
Kendini test et
1. Tek bir sayısal değişkenin dağılım şeklini görmek için hangi grafik kullanılır?
- Isı haritası
- Histogram (doğru cevap)
- Serpme grafik
- Çubuk grafik
Neden: Histogram, tek bir sayısal değişkenin değerlerini aralıklara bölüp her aralıktaki sıklığı gösterir — dağılımın şeklini (simetrik, çarpık, kaç tepeli) ortaya çıkarır.
2. Bir sayısal değişkeni kategorilere göre karşılaştırmak (dağılım + aykırı değerlerle) için en uygun grafik hangisidir?
- Isı haritası
- Serpme grafik
- Kutu grafiği (boxplot) (doğru cevap)
- Histogram
Neden: boxplot, her kategori için medyan, çeyrekler ve aykırı değerleri aynı anda gösterir — sadece ortalamayı gösteren bar chart'tan çok daha bilgilendiricidir.
3. İki kategorik değişkenin birlikte görülme sıklığını görmek için hangi araç kombinasyonu kullanılır?
- histplot tek başına
- scatterplot + hue
- pd.crosstab() + sns.heatmap() (doğru cevap)
- boxplot tek başına
Neden: İki kategorik değişken arasındaki ilişkiyi görmek için önce crosstab ile bir kontenjans tablosu oluşturulur, sonra bu tablo heatmap ile renklendirilerek görselleştirilir.
Özet
Özet
- Grafik seçimi, değişken SAYISI (bir/iki) ve TİPİ (sayısal/kategorik) tarafından belirlenir.
- Tek sayısal → histogram; tek kategorik → çubuk grafik (sayım).
- İki sayısal → serpme grafik; sayısal+kategorik → kutu grafiği; iki kategorik → ısı haritası.
- seaborn, DataFrame sütun adlarını doğrudan anlayarak matplotlib'e göre çok daha az kodla aynı grafikleri üretir.
- Yanlış grafik türü, veri tipiyle uyuşmadığında hikayeyi gizler veya yanıltır.