

Attention'ın Python'la adım adım kurulumu
Önkoşul:Self-attention mekaniği (Q, K, V)
Kanca
- derste attention’ın adımlarını tek tek, ayrı ayrı kod hücrelerinde gördük. Bu ders bunları tek bir fonksiyonda toplayıp, sonucunu PyTorch’un kendi yerleşik fonksiyonuyla karşılaştıracağız — elle yazdığımız kod doğru mu?
Sezgi
Gerçek kütüphanelerin (PyTorch, Transformers, …) içinde, self-attention özünde sadece birkaç satır: nokta çarpım, ölçekleme, softmax, ağırlıklı toplam. Karmaşık görünen bir mekanizma, aslında küçük bir fonksiyona sığıyor — ve bunu kendimiz yazıp sayısal olarak doğrulayabiliriz (6. dersteki “elle RNN vs nn.RNN” doğrulamasıyla aynı yöntem).
Mekanizma
Yeniden kullanılabilir dikkat() fonksiyonu
# 10. derste attention'ın adımlarını tek tek gördük. Şimdi bunları tek, yeniden
# kullanılabilir bir fonksiyonda toplayalım -- gerçek kütüphanelerin (PyTorch,
# Transformers) içinde de, özünde, aynı birkaç satır var.
def dikkat(Q, K, V, maske=None):
    d_k = Q.shape[-1]
    puanlar = (Q @ K.transpose(-2, -1)) / (d_k ** 0.5)
    if maske is not None:
        puanlar = puanlar.masked_fill(maske == 0, float("-inf"))
    agirliklar = F.softmax(puanlar, dim=-1)
    cikti = agirliklar @ V
    return cikti, agirliklar

N, D = 5, 8
Q = torch.randn(N, D)
K = torch.randn(N, D)
V = torch.randn(N, D)

cikti, agirliklar = dikkat(Q, K, V)
print(f"Fonksiyon: {N} token x {D} boyut girdisiyle çağrıldı.")
print(f"Çıktı şekli: {tuple(cikti.shape)}, dikkat matrisi şekli: {tuple(agirliklar.shape)}")
print(f"Her satırın toplamı 1 mi? {torch.allclose(agirliklar.sum(-1), torch.ones(N))}")
Fonksiyon: 5 token x 8 boyut girdisiyle çağrıldı.
Çıktı şekli: (5, 8), dikkat matrisi şekli: (5, 5)
Her satırın toplamı 1 mi? TrueŞimdi bu fonksiyonu, PyTorch’un torch.nn.functional.scaled_dot_product_attention’ıyla karşılaştıralım:
Sayısal doğrulama
# Bu elle yazdığımız fonksiyon, PyTorch'un yerleşik scaled_dot_product_attention'ı
# ile aynı sonucu üretiyor mu? (6. dersteki "elle RNN vs nn.RNN" doğrulamasıyla aynı mantık.)
cikti_elle, agirliklar_elle = dikkat(Q, K, V)
cikti_pytorch = F.scaled_dot_product_attention(Q, K, V)

fark = (cikti_elle - cikti_pytorch).abs().max().item()
print(f"\nElle yazılan fonksiyon ile torch.nn.functional.scaled_dot_product_attention arasındaki")
print(f"maksimum fark: {fark:.2e}")
print(f"torch.allclose ile eşleşiyor mu? {torch.allclose(cikti_elle, cikti_pytorch, atol=1e-6)}")
Elle yazılan fonksiyon ile torch.nn.functional.scaled_dot_product_attention arasındaki
maksimum fark: 2.38e-07
torch.allclose ile eşleşiyor mu? True
Fark 2.4e-07 — kayan nokta (floating point) yuvarlama hassasiyetinin içinde, yani pratikte sıfır. Elle yazdığımız fonksiyon, kütüphanenin yaptığının aynısını yapıyor.
Matematik
Nedensel (causal) maske
‘a ayarlanan bir puan, softmax’tan geçtikten sonra tam olarak ağırlık üretir () — yani o token’a hiç dikkat edilmez. Bu basit numara, bir modelin geleceği görmesini engellemenin standart yoludur ve torch.tril (alt üçgen matris) ile tek satırda üretilir.
Kod
Neden böyle bir maskeye ihtiyaç duyarız? Bir dil modeli, bir sonraki kelimeyi tahmin ederken, o kelimeyi (ve sonrasını) zaten görmüş olmamalı — yoksa “tahmin” değil, “kopyalama” yapar (17-18. ders, GPT’nin temeli).
Nedensel maske: geleceği gizle
# Bir gerçek kullanım: bazı token'ların birbirini görmesini engellemek isteyebiliriz --
# örn. bir dil modeli, gelecekteki kelimeyi görememeli (17-18. ders, GPT'nin temeli).
# Buna "nedensel maske" (causal mask) denir: her token, sadece kendisinden öncekileri görebilir.
nedensel_maske = torch.tril(torch.ones(N, N))
print(f"\nNedensel maske (1=görebilir, 0=göremez):")
for satir in nedensel_maske.tolist():
    print(" ", [int(v) for v in satir])

_, agirliklar_maskeli = dikkat(Q, K, V, maske=nedensel_maske)
print(f"\nMaskesiz durumda token 0, token 4'e bakma ağırlığı: {agirliklar[0, 4].item():.4f}")
print(f"Maskeli durumda   token 0, token 4'e bakma ağırlığı: {agirliklar_maskeli[0, 4].item():.4f}")
print("Token 0, kendisinden sonra gelen token 4'ü artık hiç 'göremiyor' -- ağırlık tam sıfır.")
print(f"\nMaskeli token 4'ün ağırlıkları (tüm geçmişi görebilir): {[round(v,3) for v in agirliklar_maskeli[4].tolist()]}")
print(f"Maskesiz token 4'ün ağırlıkları (karşılaştırma için):    {[round(v,3) for v in agirliklar[4].tolist()]}")
Nedensel maske (1=görebilir, 0=göremez):
[1, 0, 0, 0, 0]
[1, 1, 0, 0, 0]
[1, 1, 1, 0, 0]
[1, 1, 1, 1, 0]
[1, 1, 1, 1, 1]
Maskesiz durumda token 0, token 4'e bakma ağırlığı: 0.2560
Maskeli durumda token 0, token 4'e bakma ağırlığı: 0.0000
Token 0, kendisinden sonra gelen token 4'ü artık hiç 'göremiyor' -- ağırlık tam sıfır.
Maskeli token 4'ün ağırlıkları (tüm geçmişi görebilir): [0.062, 0.156, 0.247, 0.494, 0.041]
Maskesiz token 4'ün ağırlıkları (karşılaştırma için): [0.062, 0.156, 0.247, 0.494, 0.041]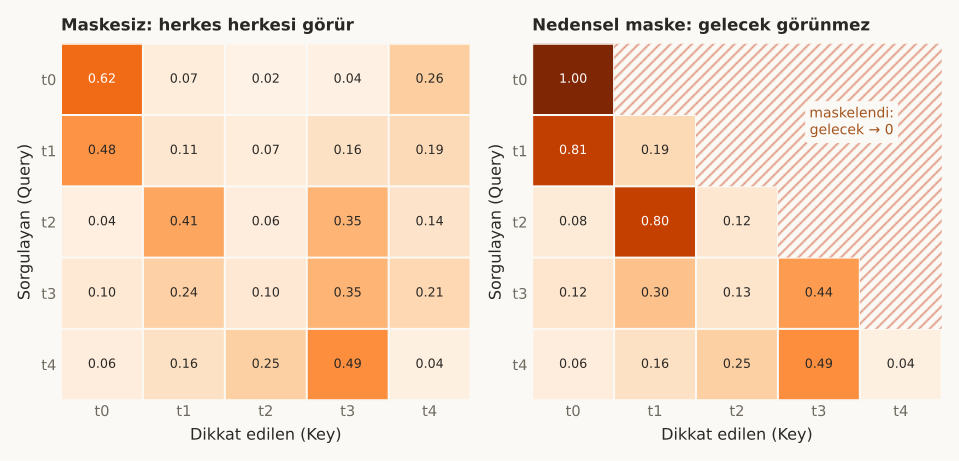 (grafiği tam boyutta, yeni sekmede aç)
İlk token (0), 4. token’a bakma ağırlığını 0.256’dan 0.000’a düşürüyor — artık kendisinden sonraki hiçbir şeyi “göremiyor”. Son token (4) ise zaten tüm geçmişi görebildiği için ağırlıkları değişmiyor.
Nerede işe yarar
Bu iki fikir — yeniden kullanılabilir bir fonksiyon ve sayısal doğrulama — ML mühendisliğinin günlük pratiği:
- Gerçek kütüphaneler bu fonksiyonu SizinLE aynı şekilde yazmaz — GPU’ya özel, bellek-verimli (
flash attentiongibi) versiyonlar kullanırlar — ama matematiksel sonuç aynıdır, doğruladığımız gibi. - Maskeleme, sadece nedensel (causal) modellerde gerekli değil — dolgu (padding) token’larını gizlemek için de aynı mekanizma kullanılır (kısa cümleleri uzatmak için eklenen “boş” token’lar).
- Bu fonksiyon, 12. derste “çoklu başlık” (multi-head) için tekrar tekrar çağrılacak — her başlık, aynı
dikkat()fonksiyonunu farklı Q/K/V projeksiyonlarıyla çalıştırır.
Bu 2 hatayı yaparsın:
- Maskelemeyi softmax’tan sonra (ağırlıkları sıfırlayarak) yapmak — yanlış, çünkü kalan ağırlıklar 1’e toplanmaz; maskeleme softmax’tan önce, ile yapılmalı.
- “Sayısal doğrulama” adımını gereksiz bir formalite sanmak — elle yazılan kodda tek bir işaret hatası (örn.
Q @ K.TyerineK @ Q.T), sonucu sessizce yanlış üretir;torch.allclosegibi bir kontrol olmadan bu fark edilmeyebilir.
Kendini test et
1. Elle yazılan dikkat() fonksiyonu ile PyTorch'un scaled_dot_product_attention'ı arasındaki 2.4e-07'lik fark neyi gösteriyor?
- Elle yazılan kodda bir hata olduğunu
- İki fonksiyonun matematiksel olarak aynı işlemi yaptığını -- kalan fark, kayan nokta (floating point) yuvarlama hassasiyetinin içinde, yani pratikte sıfır (doğru cevap)
- PyTorch'un daha yavaş olduğunu
- Sonuçların karşılaştırılamayacağını
Neden: torch.allclose(..., atol=1e-6) True döndürdü -- bu, iki hesaplamanın (6. dersteki 'elle RNN vs nn.RNN' doğrulamasıyla aynı standartta) matematiksel olarak eşdeğer olduğunu kanıtlar.
2. Nedensel (causal) maske neden softmax'tan önce, ağırlıkları sıfırlamak yerine puanları -∞ yaparak uygulanır?
- Hesaplama hızını artırmak için
- Softmax sonrası sıfırlama, kalan ağırlıkların toplamını 1'den küçük bırakır (geçerli bir olasılık dağılımı olmaz); -∞, softmax içinde otomatik olarak tam 0 ağırlığa dönüşür ve kalanlar hâlâ 1'e toplanır (doğru cevap)
- İkisi arasında matematiksel bir fark yoktur
- Bellek tasarrufu için
Neden: maskeleme-fikri bloğunda masked_fill ile puanlar -∞ yapılıyor, sonra softmax uygulanıyor -- bu sırayla, maskeli olmayan ağırlıklar hâlâ toplamda 1 olan geçerli bir dağılım oluşturuyor.
3. Notebook'ta token 0'ın token 4'e (gelecekteki bir kelimeye) bakma ağırlığı maskeleme sonrası 0.256'dan 0.000'a düşerken, token 4'ün ağırlıkları hiç değişmiyor. Bunun nedeni ne?
- Bu bir hesaplama hatasıdır
- Nedensel maskede her token sadece kendisinden öncekileri (ve kendisini) görebilir; token 4 dizinin son elemanı olduğu için zaten tüm geçmişi (0-4 arası her şeyi) görebiliyordu, maske onun için hiçbir şeyi engellemiyor (doğru cevap)
- Token 4'ün ağırlıkları rastgele sabitlenmiştir
- Maske sadece ilk token için çalışır
Neden: torch.tril ile üretilen maskenin son satırı tamamen 1'lerden oluşur (nedensel_maske bloğunda görüldüğü gibi) -- yani son token için hiçbir pozisyon maskelenmez, bu yüzden ağırlıkları maskesiz duruma özdeş kalır.
Özet
Özet
- Self-attention'ın tüm adımları (Q·Kᵀ, ölçekleme, softmax, ağırlıklı toplam) tek bir yeniden kullanılabilir fonksiyona sığar.
- Elle yazılan fonksiyon, torch.nn.functional.scaled_dot_product_attention ile 2.4e-07 farkla (pratikte sıfır) eşleşiyor -- sayısal doğrulama, ML mühendisliğinin standart pratiği.
- Nedensel (causal) maske, puanları softmax öncesi -∞ yaparak bir token'ın geleceği görmesini engeller.
- torch.tril ile üretilen alt üçgen matris, "sadece geçmişi gör" kuralını tek satırda kodlar.
- Bu dikkat() fonksiyonu, 12. derste multi-head attention'ın yapı taşı olacak.