

Dil modeli nedir, ne yapar
Önkoşul:Transformer mimarisi: bütün resim
Kanca
9-19. derste bir Transformer’ı baştan sona kurduk. Bu ders geri çekilip soruyor: tüm bu makine, özünde, tam olarak ne yapıyor — ve bunu “iyi yapıp yapmadığını” nasıl ölçeriz?
Sezgi
Bir dil modeli tek bir şeyi hesaplar: bir bağlam verildiğinde, kelime dağarcığındaki her token’ın “sıradaki token olma olasılığını”. 9-19. derste kurduğumuz self-attention, FFN, layer norm, artık bağlantı — hepsi, bu tek olasılık dağılımını ne kadar iyi tahmin edeceğimizi belirleyen parçalardı.
Mekanizma
- dersteki modeli tekrar eğitip, onu hiç görmediği bağlam uzunluklarıyla test edelim:
Aynı kural, her bağlamda
# "Dil modeli" tek bir şey yapar: bir bağlam (context) verildiğinde, kelime
# dağarcığındaki her token'ın "sıradaki token olma olasılığını" hesaplar --
# P(x_t | x_1, ..., x_{t-1}). Hepsi bu kadar. 9-19. derste kurduğumuz her şey,
# bu tek fonksiyonu hesaplamak içindi.
model = MiniGPT(V, D, PENCERE)
optimize_edici = torch.optim.Adam(model.parameters(), lr=0.01)
for adim in range(400):
    baslangic = torch.randint(0, len(ids) - PENCERE - 1, (8,))
    girdi = torch.stack([ids[b:b + PENCERE] for b in baslangic])
    hedef = torch.stack([ids[b + 1:b + PENCERE + 1] for b in baslangic])
    logit = model(girdi)
    kayip = F.cross_entropy(logit.reshape(-1, V), hedef.reshape(-1))
    optimize_edici.zero_grad()
    kayip.backward()
    optimize_edici.step()
print(f"Eğitim tamamlandı, son kayıp: {kayip.item():.6f}")

model.eval()
print("\nFarklı bağlamlar için P(sıradaki token | bağlam):")
for baglam in ["A", "AB", "ABC", "ABCA", "BC", "C"]:
    girdi_ids = torch.tensor([[stoi[c] for c in baglam]])
    with torch.no_grad():
        olasiliklar = F.softmax(model(girdi_ids)[0, -1], dim=-1)
    dagilim = ", ".join(f"{t}={p:.3f}" for t, p in zip(VOCAB, olasiliklar.tolist()))
    print(f"  '{baglam}' -> {dagilim}")
print("\nModel, hiç görmediği bir bağlam uzunluğunda bile (örn. tek başına 'C'), 'sıradaki A'")
print("kuralını doğru uyguluyor -- spesifik dizileri ezberlemedi, genel bir kuralı öğrendi.")
Eğitim tamamlandı, son kayıp: 0.000117
Farklı bağlamlar için P(sıradaki token | bağlam):
'A' -> A=0.000, B=1.000, C=0.000
'AB' -> A=0.000, B=0.000, C=1.000
'ABC' -> A=1.000, B=0.000, C=0.000
'ABCA' -> A=0.000, B=1.000, C=0.000
'BC' -> A=1.000, B=0.000, C=0.000
'C' -> A=1.000, B=0.000, C=0.000
Model, hiç görmediği bir bağlam uzunluğunda bile (örn. tek başına 'C'), 'sıradaki A'
kuralını doğru uyguluyor -- spesifik dizileri ezberlemedi, genel bir kuralı öğrendi.Model, tek bir “C” harfinden bile doğru “sıradaki A” kuralını çıkarabiliyor — bu, ezberlemek değil, öğrenmek.
Matematik
Şaşırma (perplexity)
Şaşırma, çapraz entropi kaybının (17. ders) üstel’idir. Sezgisel anlamı: model her adımda, ortalama kaç kelime arasında “eşit derecede kararsız” kalıyormuş gibi davranıyor. Şaşırma (kelime dağarcığı boyutu) model her token’a eşit olasılık veriyor, yani tamamen kararsız. Rastgele ağırlıklı bir model bunun da üstüne çıkabilir: yanlış token’lara fazladan güvendiği için eşit tahminden bile kötüdür. Şaşırma model neredeyse hiç belirsizlik yaşamıyor.
Kod
Bu metriği, eğitilmiş ve eğitilmemiş modeller üzerinde sayılarla ölçelim:
Şaşırma: eğitim öncesi vs sonrası
# Bir dil modelini nasıl "puanlarız"? Standart metrik: şaşırma (perplexity) = exp(kayıp).
# Sezgi: model her adımda, ortalama kaç kelime arasında 'kararsız' kalıyor?
egitilmis_kayip = kayip.item()
egitilmis_sasirma = math.exp(egitilmis_kayip)

model_egitilmemis = MiniGPT(V, D, PENCERE)  # Rastgele ağırlıklarla, hiç eğitilmemiş
with torch.no_grad():
    baglam_hepsi = torch.stack([ids[b:b + PENCERE] for b in range(len(ids) - PENCERE - 1)])
    hedef_hepsi = torch.stack([ids[b + 1:b + PENCERE + 1] for b in range(len(ids) - PENCERE - 1)])
    kayip_egitilmemis = F.cross_entropy(model_egitilmemis(baglam_hepsi).reshape(-1, V), hedef_hepsi.reshape(-1))
sasirma_egitilmemis = math.exp(kayip_egitilmemis.item())

print(f"\nEğitilmemiş (rastgele) model: kayıp={kayip_egitilmemis.item():.3f}, şaşırma={sasirma_egitilmemis:.2f}")
print(f"Eğitilmiş model:              kayıp={egitilmis_kayip:.6f}, şaşırma={egitilmis_sasirma:.4f}")
print(f"\nKarşılaştırma noktası: her token'a eşit olasılık veren bir model için şaşırma tam olarak V={V} olurdu.")
print(f"Rastgele ağırlıklı model ({sasirma_egitilmemis:.2f}) bunun bile üstünde -- rastgele logitler bazı yanlış")
print("token'lara fazladan güven veriyor; model hiçbir şey öğrenmemiş, 'eşit kararsız' bile değil.")
print(f"Eğitilmiş modelin şaşırması {egitilmis_sasirma:.2f}'e (neredeyse '1 kelime arasında hiç kararsız değil')")
print("çok yakın -- model, örüntüyü neredeyse kusursuz öğrendi.")
Eğitilmemiş (rastgele) model: kayıp=1.371, şaşırma=3.94
Eğitilmiş model: kayıp=0.000117, şaşırma=1.0001
Karşılaştırma noktası: her token'a eşit olasılık veren bir model için şaşırma tam olarak V=3 olurdu.
Rastgele ağırlıklı model (3.94) bunun bile üstünde -- rastgele logitler bazı yanlış
token'lara fazladan güven veriyor; model hiçbir şey öğrenmemiş, 'eşit kararsız' bile değil.
Eğitilmiş modelin şaşırması 1.00'e (neredeyse '1 kelime arasında hiç kararsız değil')
çok yakın -- model, örüntüyü neredeyse kusursuz öğrendi.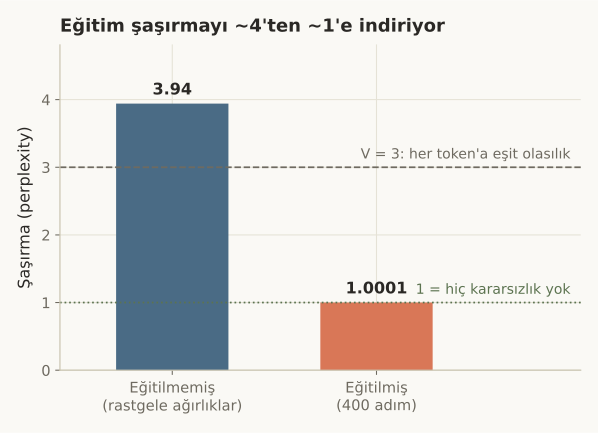 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu basit tanım, dil modellerinin neden bu kadar genel amaçlı olduğunu açıklıyor:
Tek mekanizma, çok görev
# "Dil modeli" ifadesi, sadece düz metin tamamlamayı değil, doğru şekilde
# çerçevelenen (framed) her göreve uygulanabilir -- 6. kategorinin (Prompt
# Mühendisliği) tüm temeli bu gözlemdir.
print("\nAynı model, aynı mekanizmayla (sadece 'sıradaki token'ı tahmin et'), farklı şekilde")
print("çerçevelenen görevleri 'çözebilir':")
print("  Çeviri:     'Kedi -> Cat, Köpek -> Dog, Kuş -> ???' (sıradaki token: 'Bird')")
print("  Özetleme:   '[Uzun makale] TL;dr: ???' (sıradaki token'lar: özet)")
print("  Soru-cevap: 'Fransa'nın başkenti ???' (sıradaki token: 'Paris')")
print("\nBu, GPT-3'ün (2020) en çarpıcı bulgusuydu: ayrı bir 'çeviri modeli' veya 'özetleme")
print("modeli' eğitmeye gerek yok -- tek bir dil modeli, doğru istemle (prompt) hepsini yapabiliyor.")
Aynı model, aynı mekanizmayla (sadece 'sıradaki token'ı tahmin et'), farklı şekilde
çerçevelenen görevleri 'çözebilir':
  Çeviri:     'Kedi -> Cat, Köpek -> Dog, Kuş -> ???' (sıradaki token: 'Bird')
  Özetleme:   '[Uzun makale] TL;dr: ???' (sıradaki token'lar: özet)
  Soru-cevap: 'Fransa'nın başkenti ???' (sıradaki token: 'Paris')

Bu, GPT-3'ün (2020) en çarpıcı bulgusuydu: ayrı bir 'çeviri modeli' veya 'özetleme
modeli' eğitmeye gerek yok -- tek bir dil modeli, doğru istemle (prompt) hepsini yapabiliyor.- Çeviri, özetleme, soru-cevaplama — hepsi “sıradaki token’ı tahmin et” görevine çevrilebilir — bu gözlem, 6. kategorinin (Prompt Mühendisliği) temelidir: doğru istem (prompt), modeli farklı “görevlere” yönlendirir.
- Şaşırma, tek başına modelin “iyi” olduğu anlamına gelmez — bizim örneğimizdeki model sadece 3 harfli bir örüntüyü ezberledi/genellendi; gerçek dil modellerinde şaşırma, gerçek dünya metnindeki çeşitlilik ve belirsizlik nedeniyle asla 1’e yaklaşmaz.
- GPT-3’ün (2020) “few-shot learning” yeteneği, tam olarak bu tek-görev-çerçevesi gözleminden doğdu — ayrı modeller eğitmek yerine, tek modeli farklı istemlerle “yönlendirmek”.
Bu 2 hatayı yaparsın:
- Dil modelinin “anladığını” ya da “düşündüğünü” sanmak — teknik olarak yaptığı tek şey, bir olasılık dağılımı hesaplamak; bu basit mekanizmadan nasıl karmaşık davranışlar ortaya çıktığı hâlâ aktif bir araştırma sorusudur.
- Düşük şaşırmayı (perplexity) her zaman “iyi model” ile eş tutmak — ezberleyen bir model de düşük şaşırma gösterebilir; gerçek değerlendirme, görülmemiş veride ölçülmelidir.
Kendini test et
1. Notebook'ta model, 'C' gibi tek başına bir bağlamdan bile doğru bir sonraki token'ı tahmin edebiliyor. Bu neyi gösteriyor?
- Modelin sadece eğitim dizisini ezberlediğini
- Modelin spesifik dizileri ezberlemek yerine, 'her harften sonra hangi harf gelir' şeklinde genel bir kuralı öğrendiğini -- eğitimde görmediği bağlam uzunluklarında bile bu kuralı doğru uyguluyor (doğru cevap)
- Bir hata olduğunu
- Modelin rastgele tahmin yaptığını
Neden: dil-modeli-tanimi bloğunda 'ABCA', 'BC', 'C' gibi farklı uzunluk ve başlangıç noktalarındaki bağlamların hepsi doğru sonraki token'ı (döngüsel ABC kuralına göre) tahmin ediyor.
2. Şaşırma (perplexity) = V (kelime dağarcığı boyutu) olması ne anlama gelir?
- Model mükemmel çalışıyor demektir
- Model, her token'a eşit olasılık veriyor demektir -- yani tamamen rastgele tahmin yapıyor, hiçbir şey öğrenmemiş (doğru cevap)
- Model çok büyük demektir
- Bu değer asla V'ye eşit olamaz
Neden: MathBox'taki tanıma göre şaşırma = V, her token'a eşit olasılık vermek demektir. sasirma-perplexity bloğundaki eğitilmemiş (rastgele ağırlıklı) model 3.94 ile bunun bile üstünde: rastgele ağırlıklar bazı yanlış token'lara fazladan güven veriyor.
3. 'Tek bir dil modeli, çeviri, özetleme ve soru-cevaplama yapabilir' iddiası nereden geliyor?
- Model içinde ayrı ayrı 'çeviri modülü', 'özetleme modülü' vardır
- Bu görevlerin hepsi, doğru istemle 'sıradaki token'ı tahmin et' problemine çevrilebilir -- model, tek bir mekanizmayla (bu dersin tanımıyla) hepsini aynı şekilde işler (doğru cevap)
- Bu iddia yanlıştır, her görev için ayrı model gerekir
- Sadece çok büyük modeller için geçerlidir
Neden: her-sey-tahmin bloğunda çeviri, özetleme ve soru-cevaplamanın hepsi 'sıradaki token'ı tahmin et' çerçevesine oturtuluyor -- GPT-3'ün few-shot öğrenme yeteneğinin temel gözlemi budur.
Özet
Özet
- Bir dil modeli tek bir şey yapar: P(sıradaki token | bağlam) olasılık dağılımını hesaplar.
- 9-19. dersteki tüm mekanizmalar (attention, FFN, layer norm...), bu tek dağılımı doğru tahmin etmek içindi.
- Şaşırma (perplexity = exp(kayıp)), bir dil modelinin standart değerlendirme metriğidir -- V'ye yakın kötü, 1'e yakın (görülmemiş veride) iyi.
- Model, eğitimde görmediği bağlam uzunluklarında bile doğru tahmin yaparak genel bir kural öğrendiğini kanıtladı, ezber değil.
- Çeviri, özetleme, soru-cevaplama gibi görevler, doğru istemle 'sıradaki token' problemine çevrilebilir -- 6. kategorinin (Prompt Mühendisliği) temeli.