

Self-attention mekaniği (Q, K, V)
Önkoşul:Attention fikri
Kanca
“Kedi masaya çıktı çünkü o yorulmuştu.” Bu cümledeki “o” zamiri kime işaret ediyor — “Kedi”ye mi, “masa”ya mı? İnsan için bariz. Bir modelin bunu, hiçbir dilbilgisi kuralı yazılmadan, sadece kelime benzerliklerinden bulabildiğini göreceğiz.
Sezgi
9. derste tek bir dışsal sorgu vardı. Self-attention’daki fark: her token, diğer tüm token’lar için (kendisi dahil) bir sorgu üretir — dikkat, dizinin içinde, kendi kendine kurulur. Aşağıda “o” token’ına tıkla, hangi kelimeye ne kadar “baktığını” gör:
Satır etiketine (soldaki kelimeye) tıkla.
İpucu: "o" zamirine tıkla -- modelin onu kime bağladığını gör.
Mekanizma
Self-attention’ın kalbi: aynı gömmeden üç farklı rol için üç ayrı matris öğrenilir.
Cümle ve gömmeler
# 9. derste tek bir dışsal sorgu vardı. Self-attention'da fark şu: her token,
# diğer tüm token'lar için (kendisi dahil) bir sorgu üretir -- yani dikkat,
# dizinin içinde, kendi kendine kuruluyor.
TOKENLER = ["Kedi", "masaya", "çıktı", "çünkü", "o", "yorulmuştu"]
D = 4  # gömme boyutu (öğretici amaçlı küçük tutuldu)

# Öğretici amaçlı elle tasarlanmış gömmeler (gerçekte öğrenilir):
X = torch.tensor([
    [1.5, 0.0, 0.0, 0.0],   # Kedi
    [0.0, 1.5, 0.0, 0.0],   # masaya
    [0.3, 0.3, 1.2, 0.0],   # çıktı
    [0.0, 0.0, 0.0, 1.0],   # çünkü
    [1.3, 0.0, 0.0, 0.1],   # o
    [0.2, 0.0, 0.9, 0.1],   # yorulmuştu
])
print(f'Cümle: "Kedi masaya çıktı çünkü o yorulmuştu"')
print(f"Token sayısı: {len(TOKENLER)}, gömme boyutu: {D}")
print("\nBu cümlede 'o' zamiri kime işaret ediyor? İnsan için açık: 'Kedi'ye.")
print("Self-attention'ın, bunu veriden öğrenip öğrenemediğini test edeceğiz.")
Cümle: "Kedi masaya çıktı çünkü o yorulmuştu"
Token sayısı: 6, gömme boyutu: 4
Bu cümlede 'o' zamiri kime işaret ediyor? İnsan için açık: 'Kedi'ye.
Self-attention'ın, bunu veriden öğrenip öğrenemediğini test edeceğiz.Sorgu (Q), Anahtar (K), Değer (V)
# Self-attention'ın kalbi: aynı gömmeden üç farklı rol için üç ayrı projeksiyon
# öğrenilir -- Sorgu (Query: "neyi arıyorum?"), Anahtar (Key: "ben neyim?"),
# Değer (Value: "katkım ne olacak?").
Wq = torch.randn(D, D) * 0.5
Wk = torch.randn(D, D) * 0.5
Wv = torch.randn(D, D) * 0.5

Q = X @ Wq
K = X @ Wk
V = X @ Wv

print(f"\nX (gömme) şekli: {tuple(X.shape)}")
print(f"Q, K, V şekli (üçü de): {tuple(Q.shape)}")
print(f"\n'o' token'ının gömmesi:  {[round(v,3) for v in X[4].tolist()]}")
print(f"'o' token'ının sorgusu (Q): {[round(v,3) for v in Q[4].tolist()]}")
print(f"'o' token'ının anahtarı (K): {[round(v,3) for v in K[4].tolist()]}")
print("Q, K, V aynı gömmeden geliyor ama üç farklı matrisle çarpıldığı için üç farklı vektör.")
X (gömme) şekli: (6, 4)
Q, K, V şekli (üçü de): (6, 4)

'o' token'ının gömmesi:  [1.3, 0.0, 0.0, 0.1]
'o' token'ının sorgusu (Q): [-0.192, -0.742, 0.129, -1.678]
'o' token'ının anahtarı (K): [-0.883, -1.13, 0.865, -2.746]
Q, K, V aynı gömmeden geliyor ama üç farklı matrisle çarpıldığı için üç farklı vektör.
Şimdi her token’ın sorgusu, her token’ın anahtarıyla karşılaştırılıp softmax’tan geçiyor — bu, N×N’lik bir “dikkat matrisi” üretir:
N×N dikkat matrisi
# Her token'ın sorgusu (Q), her token'ın anahtarıyla (K) karşılaştırılır --
# bu, N×N'lik bir "dikkat matrisi" (attention matrix) üretir.
puanlar_ham = Q @ K.T
puanlar = puanlar_ham / (D ** 0.5)  # ölçekleme -- bir sonraki blokta neden gerekli olduğunu göreceğiz
agirliklar = F.softmax(puanlar, dim=-1)

print(f"\nDikkat matrisi şekli: {tuple(agirliklar.shape)} (satır=sorgulayan, sütun=dikkat edilen)")
o_idx = TOKENLER.index("o")
print(f"\n'{TOKENLER[o_idx]}' token'ının dikkat ağırlıkları:")
for tok, a in zip(TOKENLER, agirliklar[o_idx].tolist()):
    print(f"  {tok:<12} ağırlık={a:.3f}")
en_yuksek = TOKENLER[agirliklar[o_idx].argmax().item()]
print(f"\n'o' en yüksek ağırlığı '{en_yuksek}'e veriyor -- model, zamirin kime işaret ettiğini")
print("hiçbir dilbilgisi kuralı yazılmadan, sadece gömmelerin benzerliğinden buluyor.")
Dikkat matrisi şekli: (6, 6) (satır=sorgulayan, sütun=dikkat edilen)

'o' token'ının dikkat ağırlıkları:
  Kedi         ağırlık=0.517
  masaya       ağırlık=0.018
  çıktı        ağırlık=0.042
  çünkü        ağırlık=0.034
  o            ağırlık=0.353
  yorulmuştu   ağırlık=0.035

'o' en yüksek ağırlığı 'Kedi'e veriyor -- model, zamirin kime işaret ettiğini
hiçbir dilbilgisi kuralı yazılmadan, sadece gömmelerin benzerliğinden buluyor.
“o”, en yüksek ağırlığı (0.517) “Kedi”ye veriyor — yukarıdaki AttentionMatrisi bileşeninde aynı sonucu görsel olarak inceleyebilirsin.
Matematik
Ölçekli nokta çarpım dikkati (scaled dot-product attention)
| Sembol | Anlamı |
|---|---|
| Girdi gömmeleri ( token × boyut) | |
| öğrenilen projeksiyon matrisleri | |
| Sorgu, anahtar, değer matrisleri ( × ) | |
| ‘nın boyutu (ölçekleme için kullanılır) | |
| Her sorgu-anahtar çiftinin benzerliği ( × matris) |
Neden ‘ye bölüyoruz? Boyut büyüdükçe rastgele vektörlerin nokta çarpımının varyansı da orantılı büyür — bu da softmax’ı satüre eder:
Ölçekleme, softmax satürasyonunu önler
# Neden [email protected]'yi sqrt(D)'ye bölüyoruz? Boyut (D) büyüdükçe, rastgele vektörlerin
# nokta çarpımının varyansı da D ile orantılı büyür -- bu da softmax'ı satüre eder.
torch.manual_seed(7)
for boyut in [4, 16, 64, 256]:
    q_rnd = torch.randn(2000, boyut)
    k_rnd = torch.randn(2000, boyut)
    dot = (q_rnd * k_rnd).sum(-1)
    print(f"boyut={boyut:<4} var(Q·K)={dot.var().item():<10.2f} var(Q·K/√boyut)={(dot / boyut**0.5).var().item():.3f}")

torch.manual_seed(3)
BUYUK_D = 256
sorgu_b = torch.randn(BUYUK_D)
anahtar_b = torch.randn(6, BUYUK_D)
ham = anahtar_b @ sorgu_b
olcekli = ham / (BUYUK_D ** 0.5)
print(f"\nBoyut={BUYUK_D} olduğunda, ölçeksiz softmax: {[round(v,3) for v in F.softmax(ham, dim=0).tolist()]}")
print(f"Aynı puanlar, ölçekli softmax: {[round(v,3) for v in F.softmax(olcekli, dim=0).tolist()]}")
print(f"Ölçeksiz en yüksek ağırlık: {F.softmax(ham, dim=0).max().item():.3f} (neredeyse tek bir token'a kilitleniyor)")
print(f"Ölçekli en yüksek ağırlık: {F.softmax(olcekli, dim=0).max().item():.3f} (daha dengeli, gradyan akışı daha sağlıklı)")
boyut=4 var(Q·K)=3.82 var(Q·K/√boyut)=0.955
boyut=16 var(Q·K)=15.51 var(Q·K/√boyut)=0.970
boyut=64 var(Q·K)=65.04 var(Q·K/√boyut)=1.016
boyut=256 var(Q·K)=261.33 var(Q·K/√boyut)=1.021
Boyut=256 olduğunda, ölçeksiz softmax: [0.0, 0.001, 0.277, 0.0, 0.002, 0.72]
Aynı puanlar, ölçekli softmax: [0.05, 0.172, 0.247, 0.089, 0.181, 0.262]
Ölçeksiz en yüksek ağırlık: 0.720 (neredeyse tek bir token'a kilitleniyor)
Ölçekli en yüksek ağırlık: 0.262 (daha dengeli, gradyan akışı daha sağlıklı)Boyut 256’da, ölçeksiz softmax neredeyse tek bir token’a kilitleniyor (en yüksek ağırlık 0.72); ölçekli softmax çok daha dengeli (en yüksek ağırlık 0.26) — bu da gradyan akışını sağlıklı tutar (5. DL Vision dersindeki satürasyon fikriyle aynı mantık).
Kod
Son adım: dikkat ağırlıkları, vektörlerinin ağırlıklı ortalamasını almak için kullanılır — bu, her token’ın yeni, bağlamsallaştırılmış temsilidir.
Bağlamsallaştırılmış çıktı
# Son adım: her token'ın dikkat ağırlıkları, V (değer) vektörlerinin ağırlıklı
# ortalamasını almak için kullanılır -- bu, o token'ın yeni, bağlamsallaştırılmış temsili.
baglam = agirliklar @ V
print(f"\n'{TOKENLER[o_idx]}' token'ının yeni (bağlamsallaştırılmış) temsili:")
print(f"  {[round(v,3) for v in baglam[o_idx].tolist()]}")
print(f"'{TOKENLER[0]}' token'ının V vektörü:")
print(f"  {[round(v,3) for v in V[0].tolist()]}")
print("\n'o'nun yeni temsili, 'Kedi'nin değer vektörüne (V) yakın -- çünkü dikkatinin")
print("büyük kısmını (0.52) ona verdi. 'o' artık sadece 'o' değil, bağlamıyla zenginleşmiş bir temsil.")
'o' token'ının yeni (bağlamsallaştırılmış) temsili:
[0.399, -0.072, -0.15, -0.419]
'Kedi' token'ının V vektörü:
[0.488, -0.016, -0.186, -0.628]
'o'nun yeni temsili, 'Kedi'nin değer vektörüne (V) yakın -- çünkü dikkatinin
büyük kısmını (0.52) ona verdi. 'o' artık sadece 'o' değil, bağlamıyla zenginleşmiş bir temsil.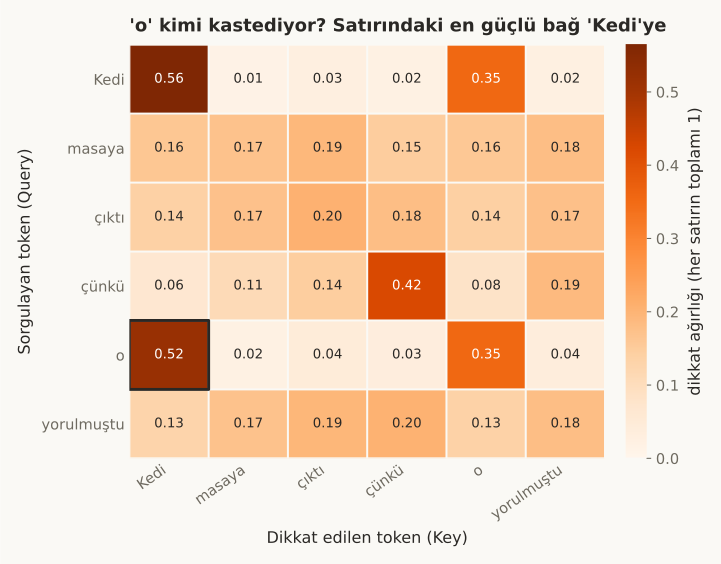 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu mekanizma, bugünün tüm büyük dil modellerinin (GPT, BERT, Claude…) temel yapı taşı:
- Q, K, V burada ayrı matrislerle hesaplandı çünkü üç farklı soru soruyorlar: Q = “ben neyi arıyorum?”, K = “ben neyim, beni nasıl bulabilirsin?”, V = “bulunursam, katkım ne olacak?” — aynı vektör olsalardı, bu üç rol birbirine karışırdı.
- Burada tek bir “dikkat başlığı” (head) var — gerçek Transformer’lar birden fazla başlığı paralel çalıştırır (12. ders), her biri farklı bir ilişki türünü (dilbilgisi, anlam, konum…) öğrenir.
- Bu örnekte rastgele başlatıldı, eğitilmedi — yine de “o → Kedi” ilişkisi ortaya çıktı çünkü gömmeler bunu destekleyecek şekilde tasarlandı; gerçek bir modelde hem gömmeler hem ağırlıklar eğitimle öğrenilir.
Bu 3 hatayı yaparsın:
- Q, K, V’nin farklı vektörler olduğunu unutup, “dikkat = kelimelerin kendisini karşılaştırmak” sanmak — hayır, üç ayrı öğrenilmiş projeksiyon var.
- Ölçeklemeyi () gereksiz bir detay sanmak — büyük boyutlarda atlanırsa, softmax satüre olur ve gradyanlar neredeyse sıfırlanır.
- Dikkat matrisinin simetrik olduğunu düşünmek — “o”nun “Kedi”ye bakma ağırlığı (0.517), “Kedi”nin “o”ya bakma ağırlığıyla (0.354) aynı değil, çünkü Q ve K farklı matrisler.
Kendini test et
1. Self-attention'da Q (sorgu), K (anahtar) ve V (değer) neden ayrı matrislerle hesaplanır, aynı gömme kullanılmaz?
- Hesaplama hızını artırmak için
- Üçü farklı bir soruyu temsil eder (Q: 'neyi arıyorum', K: 'ben neyim', V: 'katkım ne olacak') -- aynı vektör olsalardı bu roller birbirine karışırdı (doğru cevap)
- Bellek tasarrufu için
- Sadece gelenek olduğu için, işlevsel bir fark yok
Neden: uc-projeksiyon bloğunda görüldüğü gibi, aynı X gömmesinden Wq/Wk/Wv ile üç farklı vektör üretiliyor; bu ayrım olmasaydı 'benzer olmak' ile 'aranan şey olmak' aynı anlama gelirdi.
2. Notebook'ta boyut 256'da ölçeksiz softmax'ın en yüksek ağırlığı 0.72'ye çıkarken, ölçekli softmax'ın 0.26'da kalması neyi gösteriyor?
- Ölçekleme, sonucu yanlış hale getiriyor
- Boyut büyüdükçe nokta çarpımların varyansı artıyor, bu da softmax'ı satüre ediyor (neredeyse tek bir token'a kilitleniyor); √d_k'ye bölmek bu varyansı sabit tutup dengeli bir dağılım sağlıyor (doğru cevap)
- Ölçekleme sadece küçük modellerde gereklidir
- İkisi arasında pratik bir fark yoktur
Neden: olceklemenin-nedeni bloğunda var(Q·K) boyutla orantılı büyürken var(Q·K/√boyut) ~1 civarında sabit kalıyor -- bu da satürasyonu önlüyor, tıpkı 5. DL Vision dersindeki sigmoid satürasyonu gibi gradyan akışını bozmadan.
3. 'o' token'ının 'Kedi'ye bakma ağırlığı (0.517) ile 'Kedi'nin 'o'ya bakma ağırlığı (0.354) neden farklı?
- Bu bir hesaplama hatasıdır, aynı olmalıydı
- Dikkat matrisi simetrik değildir -- 'o'nun sorgusu (Q) ile 'Kedi'nin anahtarı (K) arasındaki benzerlik, 'Kedi'nin sorgusu ile 'o'nun anahtarı arasındaki benzerlikten farklı olabilir, çünkü Q ve K ayrı matrislerle üretiliyor (doğru cevap)
- Sadece 'o' zamir olduğu için ağırlığı farklıdır
- Softmax her zaman simetrik sonuç üretir
Neden: dikkat-matrisi bloğundaki agirliklar matrisi kare ama simetrik değil -- satır i, sütun j'deki değer Q[i]·K[j]'den gelir, satır j sütun i'deki değer ise Q[j]·K[i]'den; bu ikisi genelde eşit değildir.
Özet
Özet
- Self-attention'da her token, diğer tüm token'lar (kendisi dahil) için bir sorgu üretir -- dikkat dizinin içinde kurulur.
- Q (sorgu), K (anahtar), V (değer) aynı gömmeden üç ayrı öğrenilmiş matrisle hesaplanır -- her biri farklı bir rol oynar.
- Dikkat matrisi = softmax(QKᵀ/√d_k) -- N×N boyutunda, her token-token çiftinin ağırlığını taşır ve simetrik değildir.
- √d_k ile ölçekleme, boyut büyüdükçe softmax satürasyonunu (ve gradyan kaybını) önler.
- Çıktı = ağırlıklar × V -- her token'ın yeni, bağlamsallaştırılmış temsili.