

Bir sonraki token: örnekleme, temperature, top-k/top-p
Önkoşul:Ön eğitim, ince ayar, hizalama (RLHF/DPO)
Kanca
17-21. derste modelimiz hep en olası token’ı (argmax) seçti — çünkü eğitim verisi %100 öngörülebilirdi. Ama gerçek dil böyle değil: aynı bağlamdan sonra birden fazla makul devam vardır. Bu son ders, model bir olasılık dağılımı ürettikten sonra, o dağılımdan bir kelimeyi nasıl “seçtiğimizi” ele alıyor.
Sezgi
Model her zaman tek bir doğru cevap değil, bir olasılık dağılımı üretir. “Açgözlü” (greedy) çözme her zaman en olasıyı seçer — bu, modelin içsel belirsizliğini yok sayar. Örnekleme (sampling), bu dağılımdan rastgele çeker — ve temperature/top-k/top-p, bu rastgeleliği ne kadar ve nasıl uygulayacağımızı kontrol eder.
Mekanizma
Önce gerçekten belirsiz bir dil üzerinde bir model eğitelim — “AB”den sonra %60 “C”, %40 “D” gelsin:
Gerçekten belirsiz bir dil
import random
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)
random.seed(0)

VOCAB = ["A", "B", "C", "D"]
V = len(VOCAB)
stoi = {c: i for i, c in enumerate(VOCAB)}
D, PENCERE = 16, 8

# Gerçekten belirsiz bir dil: "AB"den sonra %60 ihtimalle "C", %40 ihtimalle "D" geliyor --
# 17-21. dersteki "ABC" örüntüsünün aksine, burada tek bir doğru cevap yok.
parcalar = []
for _ in range(80):
    parcalar.append("AB" + random.choices(["C", "D"], weights=[0.6, 0.4])[0])
DIZI = "".join(parcalar)
ids = torch.tensor([stoi[c] for c in DIZI])
print(f"Eğitim verisinin ilk 30 karakteri: {DIZI[:30]}")
print("Gerçek üretim kuralı: 'AB'den sonra %60 'C', %40 'D' (rastgele).")

class MiniGPT(nn.Module):
    def __init__(self, vocab_size, d_model, pencere):
        super().__init__()
        self.gomme = nn.Embedding(vocab_size, d_model)
        self.pos = nn.Embedding(pencere, d_model)
        self.Wq = nn.Linear(d_model, d_model, bias=False)
        self.Wk = nn.Linear(d_model, d_model, bias=False)
        self.Wv = nn.Linear(d_model, d_model, bias=False)
        self.norm1 = nn.LayerNorm(d_model)
        self.ffn = nn.Sequential(nn.Linear(d_model, 4 * d_model), nn.GELU(), nn.Linear(4 * d_model, d_model))
        self.norm2 = nn.LayerNorm(d_model)
        self.cikis = nn.Linear(d_model, vocab_size)

    def forward(self, x_ids):
        B, T = x_ids.shape
        h = self.gomme(x_ids) + self.pos(torch.arange(T))
        Q, K, Vv = self.Wq(h), self.Wk(h), self.Wv(h)
        maske = torch.tril(torch.ones(T, T))
        puanlar = (Q @ K.transpose(-2, -1)) / (D ** 0.5)
        puanlar = puanlar.masked_fill(maske == 0, float("-inf"))
        agirliklar = F.softmax(puanlar, dim=-1)
        h = self.norm1(h + agirliklar @ Vv)
        h = self.norm2(h + self.ffn(h))
        return self.cikis(h)

model = MiniGPT(V, D, PENCERE)
optimize_edici = torch.optim.Adam(model.parameters(), lr=0.01)
for adim in range(600):
    b = torch.randint(0, len(ids) - PENCERE - 1, (16,))
    girdi = torch.stack([ids[x:x + PENCERE] for x in b])
    hedef = torch.stack([ids[x + 1:x + PENCERE + 1] for x in b])
    logit = model(girdi)
    kayip = F.cross_entropy(logit.reshape(-1, V), hedef.reshape(-1))
    optimize_edici.zero_grad()
    kayip.backward()
    optimize_edici.step()
print(f"\nEğitim tamamlandı, son kayıp: {kayip.item():.4f}")

model.eval()
with torch.no_grad():
    baglam = torch.tensor([[stoi["A"], stoi["B"]]])
    ham_logit = model(baglam)[0, -1]
    P_taban = F.softmax(ham_logit, dim=-1)
print(f"\nP(sıradaki | 'AB'): {dict(zip(VOCAB, [round(v,3) for v in P_taban.tolist()]))}")
print("Model, gerçek %60/%40 oranını neredeyse tam olarak öğrendi -- 'C' kesin değil, sadece daha olası.")
Eğitim verisinin ilk 30 karakteri: ABDABDABCABCABCABCABDABCABCABC
Gerçek üretim kuralı: 'AB'den sonra %60 'C', %40 'D' (rastgele).
Eğitim tamamlandı, son kayıp: 0.2181
P(sıradaki | 'AB'): {'A': 0.0, 'B': 0.0, 'C': 0.616, 'D': 0.384}
Model, gerçek %60/%40 oranını neredeyse tam olarak öğrendi -- 'C' kesin değil, sadece daha olası.Şimdi açgözlü çözme ile örneklemeyi karşılaştıralım:
Açgözlü çözme belirsizliği siler, örnekleme korur
# 17-20. derste hep argmax (en olası token) kullandık -- "açgözlü" (greedy) çözme.
# Bu, belirsizliği yok sayar. Gerçek örnekleme (sampling), dağılımdan rastgele seçer.
acgozlu_secim = VOCAB[P_taban.argmax().item()]
print(f"\nAçgözlü (greedy) seçim: her zaman '{acgozlu_secim}' -- model %38.4 ihtimalle 'D' olacağını")
print("düşünse bile, açgözlü çözme bunu hiçbir zaman üretmez.")

torch.manual_seed(7)
ornekler = [VOCAB[torch.multinomial(P_taban, 1).item()] for _ in range(1000)]
sayimlar = {t: ornekler.count(t) for t in VOCAB}
print(f"\n1000 örneklemede (sampling) gerçek dağılım: {sayimlar}")
print(f"Oran: C=%{100*sayimlar['C']/1000:.1f}, D=%{100*sayimlar['D']/1000:.1f} -- modelin öğrendiği")
print("%60/%40 oranına çok yakın. Örnekleme, modelin içsel belirsizliğini saklıyor; açgözlü çözme siliyor.")
Açgözlü (greedy) seçim: her zaman 'C' -- model %38.4 ihtimalle 'D' olacağını
düşünse bile, açgözlü çözme bunu hiçbir zaman üretmez.

1000 örneklemede (sampling) gerçek dağılım: {'A': 0, 'B': 0, 'C': 615, 'D': 385}
Oran: C=%61.5, D=%38.5 -- modelin öğrendiği
%60/%40 oranına çok yakın. Örnekleme, modelin içsel belirsizliğini saklıyor; açgözlü çözme siliyor.
Matematik
Temperature, top-k, top-p
| Yöntem | Ne yapar | Ne zaman kullanılır |
|---|---|---|
| Temperature () | Logit’leri ‘ye böler — 1’den küçük keskinleştirir, 1’den büyük düzleştirir | Genel “yaratıcılık” ayarı |
| top-k | sadece en olası token’ı tutar, sabit sayı | Çok düşük olasılıklı “kuyruğu” kesmek |
| top-p (nucleus) | Kümülatif olasılığı ‘yi aşan en küçük kümeyi tutar, değişken sayı | Dağılımın şekline uyarlanabilir filtreleme |
Kod
Temperature’ın etkisini sayılarla görelim:
Sıcaklık: keskinleştirme ve düzleştirme
# "Sıcaklık" (temperature), softmax'tan önce logit'leri T'ye bölerek dağılımı
# 'keskinleştirir' (T<1) veya 'düzleştirir' (T>1).
print(f"\n{'Sıcaklık (T)':<14} {'P(C)':<8} {'P(D)':<8} {'Yorum':<30}")
for T in [0.5, 1.0, 2.0]:
    P_T = F.softmax(ham_logit / T, dim=-1)
    yorum = "daha KESKİN (az çeşitlilik)" if T < 1 else "daha DÜZ (çok çeşitlilik)" if T > 1 else "değişmedi (taban)"
    print(f"{T:<14} {P_T[stoi['C']].item():<8.3f} {P_T[stoi['D']].item():<8.3f} {yorum:<30}")
P_05 = F.softmax(ham_logit / 0.5, dim=-1)[stoi["C"]].item()
P_20 = F.softmax(ham_logit / 2.0, dim=-1)[stoi["C"]].item()
print(f"\nT=0.5, modelin zaten olan tercihini abartır (C: {P_taban[stoi['C']].item():.3f} -> {P_05:.3f}). T=2.0 bu tercihi")
print(f"yumuşatır (C: {P_taban[stoi['C']].item():.3f} -> {P_20:.3f}) -- T, modelin öğrendiği olasılıkları değil, ne kadar")
print("'kararlı' davranacağını kontrol eder.")
Sıcaklık (T)   P(C)     P(D)     Yorum
0.5            0.721    0.279    daha KESKİN (az çeşitlilik)
1.0            0.616    0.384    değişmedi (taban)
2.0            0.546    0.431    daha DÜZ (çok çeşitlilik)

T=0.5, modelin zaten olan tercihini abartır (C: 0.616 -> 0.721). T=2.0 bu tercihi
yumuşatır (C: 0.616 -> 0.546) -- T, modelin öğrendiği olasılıkları değil, ne kadar
'kararlı' davranacağını kontrol eder.
Şimdi top-k ve top-p’yi karşılaştıralım:
Sabit sayı (top-k) vs uyarlanabilir kütle (top-p)
# top-k: sadece en olası k token'ı tut, gerisini sıfırla, yeniden normalize et.
# top-p (nucleus): kümülatif olasılığı p'yi aşan en küçük token kümesini tut.
def top_k_filtrele(olasiliklar, k):
    deger, indeks = torch.topk(olasiliklar, k)
    yeni = torch.zeros_like(olasiliklar)
    yeni[indeks] = deger
    return yeni / yeni.sum()

def top_p_filtrele(olasiliklar, p):
    siralanmis_deger, siralanmis_indeks = torch.sort(olasiliklar, descending=True)
    kumulatif = torch.cumsum(siralanmis_deger, dim=0)
    kesme = (kumulatif < p).sum().item() + 1  # eşiği aşan ilk noktaya kadar tut
    tutulan_indeks = siralanmis_indeks[:kesme]
    yeni = torch.zeros_like(olasiliklar)
    yeni[tutulan_indeks] = olasiliklar[tutulan_indeks]
    return yeni / yeni.sum()

P_topk2 = top_k_filtrele(P_taban, k=2)
P_topp05 = top_p_filtrele(P_taban, p=0.5)

print(f"\nTaban dağılım:      {dict(zip(VOCAB, [round(v,3) for v in P_taban.tolist()]))}")
print(f"top-k (k=2) sonrası: {dict(zip(VOCAB, [round(v,3) for v in P_topk2.tolist()]))}")
print(f"top-p (p=0.5) sonrası: {dict(zip(VOCAB, [round(v,3) for v in P_topp05.tolist()]))}")
print("\ntop-k=2, her zaman tam olarak 2 token tutar (burada zaten A,B ~0 olduğundan sonuç")
print("değişmiyor). top-p=0.5 ise, kümülatif kütleye bakar: 'C' tek başına (0.616) 0.5'i aştığı")
print("için sadece 'C' tutuluyor -- top-p, dağılımın şekline göre adaptif, top-k sabit sayıda.")
Taban dağılım: {'A': 0.0, 'B': 0.0, 'C': 0.616, 'D': 0.384}
top-k (k=2) sonrası: {'A': 0.0, 'B': 0.0, 'C': 0.616, 'D': 0.384}
top-p (p=0.5) sonrası: {'A': 0.0, 'B': 0.0, 'C': 1.0, 'D': 0.0}
top-k=2, her zaman tam olarak 2 token tutar (burada zaten A,B ~0 olduğundan sonuç
değişmiyor). top-p=0.5 ise, kümülatif kütleye bakar: 'C' tek başına (0.616) 0.5'i aştığı
için sadece 'C' tutuluyor -- top-p, dağılımın şekline göre adaptif, top-k sabit sayıda.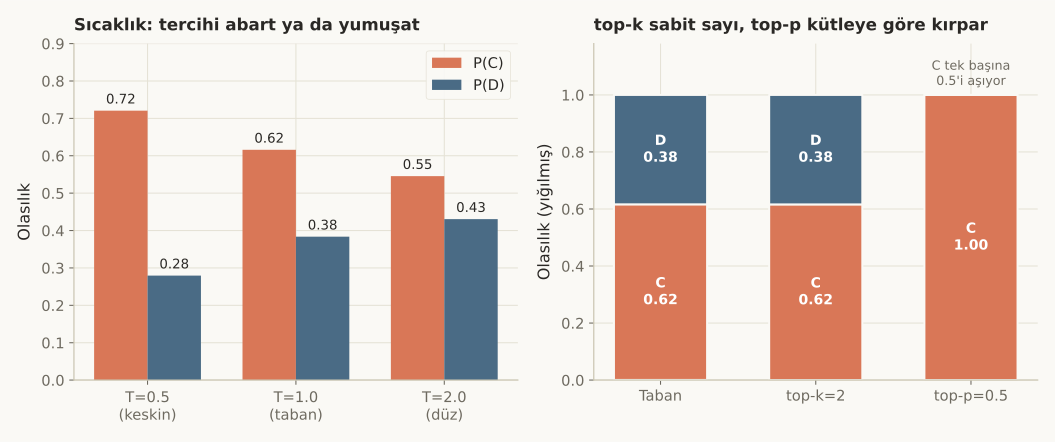 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu ayarlar, gerçek bir dil modeliyle (ChatGPT, Claude…) her etkileşimde aktif olarak çalışır:
- Kod üretimi gibi görevlerde düşük temperature (0-0.3) tercih edilir — tutarlılık ve doğruluk, çeşitlilikten daha önemlidir.
- Yaratıcı yazı gibi görevlerde daha yüksek temperature (0.7-1.0) tercih edilir — çeşitlilik, tek “doğru” cevabın olmadığı durumlarda değerlidir.
- top-p, pratikte top-k’dan daha yaygın kullanılır — çünkü dağılımın “keskinliğine” göre kendiliğinden uyum sağlar; top-k sabit bir sayı olduğu için bazen çok dar (kararlı bir bağlamda), bazen çok geniş (belirsiz bir bağlamda) kalabilir.
Bu 2 hatayı yaparsın:
- Temperature’ın modelin öğrendiği olasılıkları değiştirdiğini sanmak — hayır, model aynı kalır; temperature sadece bu olasılıklardan nasıl örnekleme yapıldığını etkiler.
- Açgözlü çözmenin her zaman “en iyi” seçim olduğunu düşünmek — gerçek dilde çeşitlilik, doğallık için gereklidir; her zaman en olası kelimeyi seçmek tekrarlayan, “robotik” metin üretebilir.
Kendini test et
1. Notebook'ta model 'AB'den sonra P(C)=0.616, P(D)=0.384 öğreniyor. Açgözlü (greedy) çözme ile örnekleme (sampling) arasındaki fark nedir?
- Hiçbir fark yoktur, ikisi de aynı sonucu verir
- Açgözlü çözme her zaman 'C'yi seçer (en olası), modelin %38.4 ihtimalle 'D' olacağını düşünmesini yok sayar; örnekleme ise 1000 denemede gerçek %61.5/%38.5 oranını üretir, modelin belirsizliğini korur (doğru cevap)
- Örnekleme her zaman yanlış sonuç verir
- Açgözlü çözme rastgele bir seçimdir
Neden: acgozlu-vs-ornekleme bloğunda açgözlü çözme her zaman 'C' üretirken, 1000 örneklemenin sonucu {C: 615, D: 385} -- modelin öğrendiği orana çok yakın bir dağılım.
2. Temperature (T) neyi değiştirir, neyi değiştirmez?
- Modelin öğrendiği olasılıkları kalıcı olarak değiştirir
- Modelin ağırlıklarını veya öğrendiği olasılıkları değiştirmez -- sadece softmax'a girmeden önce logit'leri T'ye bölerek, dağılımın ne kadar 'keskin' ya da 'düz' örnekleneceğini kontrol eder (doğru cevap)
- Sadece top-k ile birlikte kullanılabilir
- Modelin kelime dağarcığını değiştirir
Neden: temperature bloğunda aynı ham_logit (modelin ürettiği, değişmeyen çıktı) farklı T değerleriyle bölünüyor -- T=0.5 P(C)'yi 0.721'e çıkarırken T=2.0 0.546'ya indiriyor, ama bu sadece örnekleme dağılımını etkiliyor, modeli değil.
3. top-k=2 ile top-p=0.5 arasındaki temel fark nedir?
- İkisi de aynı sonucu üretir
- top-k her zaman sabit sayıda (k) token tutar, dağılımın şekline bakmaksızın; top-p ise kümülatif olasılık kütlesine bakar -- notebook'ta 'C' tek başına (0.616) p=0.5'i aştığı için top-p sadece 'C'yi tutarken, top-k=2 hem 'C' hem 'D'yi tutuyor (doğru cevap)
- top-p her zaman daha fazla token tutar
- top-k, olasılıkları değiştirmez
Neden: top-k-top-p bloğunda top_k_filtrele(k=2) sonucu {C: 0.616, D: 0.384} (değişmedi) iken top_p_filtrele(p=0.5) sonucu {C: 1.0, D: 0.0} -- top-p'nin kümülatif kütleye göre adaptif filtrelediğinin doğrudan kanıtı.
Özet
Özet
- Bir dil modeli, bir sonraki token için tek bir cevap değil, bir olasılık dağılımı üretir.
- Açgözlü (greedy) çözme her zaman en olası token'ı seçer -- modelin belirsizliğini yok sayar.
- Örnekleme (sampling), bu dağılımdan rastgele çeker -- 1000 denemede gerçek oran modelin öğrendiği olasılıklara yakınsar.
- Temperature, modeli değil, örnekleme dağılımının keskinliğini kontrol eder (1'in altı keskin, üstü düz).
- top-k sabit sayıda token tutar; top-p (nucleus) kümülatif olasılık kütlesine göre uyarlanabilir şekilde tutar -- pratikte top-p daha yaygın tercih edilir.