

Ön eğitim, ince ayar, hizalama (RLHF/DPO)
Önkoşul:Dil modeli nedir, ne yapar
Kanca
17-20. derste bir dil modelini sıfırdan eğittik. Ama ChatGPT’ye “merhaba” yazdığında, model sana bir cümleyi “tamamlamıyor” — yardımcı oluyor. Bu iki davranış arasındaki fark, tek bir eğitim adımından değil, üç ayrı aşamadan geliyor.
Sezgi
Ön eğitim modele “dil nasıl işler”i öğretir; ince ayar bunu belirli bir göreve yönlendirir; hizalama ise çıktıları insan tercihleriyle uyumlu hale getirir. İnce ayarın ne kadar iyi çalıştığı, yeni görevin ön eğitimdeki görevle ne kadar ilişkili olduğuna bağlıdır — bunu sayılarla göstereceğiz.
Mekanizma
Önce bir “temel model” (base model) ön eğitelim:
Aşama 1: Ön eğitim
# Aşama 1: ön eğitim (pretraining). Büyük, etiketsiz bir metin üzerinde "sıradaki
# token'ı tahmin et" hedefiyle eğitim -- 17-19. derste yaptığımız tam olarak budur.
torch.manual_seed(0)
model_on_egitilmis = MiniGPT(V, D, PENCERE)
kayiplar_pre = egit(model_on_egitilmis, "ABC" * 20, 400, seed=1)
print(f"Ön eğitim (400 adım, 'ABC' örüntüsü): son kayıp = {kayiplar_pre[-1]:.6f}")
print("Bu 'temel model' (base model), ABC döngüsünü öğrendi -- ama sadece bunu.")
Ön eğitim (400 adım, 'ABC' örüntüsü): son kayıp = 0.000124
Bu 'temel model' (base model), ABC döngüsünü öğrendi -- ama sadece bunu.Şimdi bu modeli, aynı yönde ama farklı başlangıçlı yeni bir örüntüyle ince ayar yapalım:
Aşama 2a: Pozitif transfer
# Aşama 2: ince ayar (fine-tuning). Ön eğitilmiş modeli, küçük bir yeni görevle
# devam ettirelim: 'BCA' örüntüsü -- aynı döngüsel kural (A->B->C->A), sadece
# başlangıç noktası farklı.
model_ince_ayar_bca = copy.deepcopy(model_on_egitilmis)
kayiplar_ft_bca = egit(model_ince_ayar_bca, "BCA" * 20, 100, seed=2)

torch.manual_seed(0)
model_sifirdan_bca = MiniGPT(V, D, PENCERE)
kayiplar_scratch_bca = egit(model_sifirdan_bca, "BCA" * 20, 100, seed=2)

print(f"\n'BCA' (aynı yönde döngü) -- ince ayar vs sıfırdan eğitim:")
print(f"  İnce ayar   ilk 3 kayıp: {[round(v,3) for v in kayiplar_ft_bca[:3]]} (eşiğin altına düştüğü adım: {ilk_esik_altinda(kayiplar_ft_bca)})")
print(f"  Sıfırdan    ilk 3 kayıp: {[round(v,3) for v in kayiplar_scratch_bca[:3]]} (eşiğin altına düştüğü adım: {ilk_esik_altinda(kayiplar_scratch_bca)})")
print("\nİnce ayar, daha ilk adımda neredeyse sıfır kayıpla başlıyor -- ön eğitimde öğrenilen")
print("'döngüsel kural', yeni başlangıç noktasına anında aktarılıyor (pozitif transfer).")
print("Sıfırdan model ise kuralı en baştan öğrenmek zorunda.")
'BCA' (aynı yönde döngü) -- ince ayar vs sıfırdan eğitim:
  İnce ayar   ilk 3 kayıp: [0.0, 0.0, 0.0] (eşiğin altına düştüğü adım: 0)
  Sıfırdan    ilk 3 kayıp: [1.171, 0.942, 0.763] (eşiğin altına düştüğü adım: 22)

İnce ayar, daha ilk adımda neredeyse sıfır kayıpla başlıyor -- ön eğitimde öğrenilen
'döngüsel kural', yeni başlangıç noktasına anında aktarılıyor (pozitif transfer).
Sıfırdan model ise kuralı en baştan öğrenmek zorunda.
İnce ayar, sıfırdan eğitimin 22 adımda ulaştığı yere daha ilk adımda ulaştı! Peki yönü ters bir görev verirsek?
Aşama 2b: Negatif transfer
# Peki yönü ters bir kural verirsek? 'CBA' -- döngü ters yönde (A->C->B->A).
model_ince_ayar_cba = copy.deepcopy(model_on_egitilmis)
kayiplar_ft_cba = egit(model_ince_ayar_cba, "CBA" * 20, 100, seed=2)

torch.manual_seed(0)
model_sifirdan_cba = MiniGPT(V, D, PENCERE)
kayiplar_scratch_cba = egit(model_sifirdan_cba, "CBA" * 20, 100, seed=2)

print(f"\n'CBA' (ters yönde döngü) -- ince ayar vs sıfırdan eğitim:")
print(f"  İnce ayar   ilk 3 kayıp: {[round(v,3) for v in kayiplar_ft_cba[:3]]} (eşiğin altına düştüğü adım: {ilk_esik_altinda(kayiplar_ft_cba)})")
print(f"  Sıfırdan    ilk 3 kayıp: {[round(v,3) for v in kayiplar_scratch_cba[:3]]} (eşiğin altına düştüğü adım: {ilk_esik_altinda(kayiplar_scratch_cba)})")
print("\nBu sefer ince ayar daha kötü başlıyor (kayıp 9.57!) ve eşiğin altına daha geç (48. adım)")
print("düşüyor -- sıfırdan modelden (26. adım) bile yavaş. Ön eğitimdeki 'saat yönünde' önyargı,")
print("ters yönlü göreve zarar veriyor (negatif transfer) -- ince ayarın önce bu önyargıyı")
print("'unutması' gerekiyor.")
'CBA' (ters yönde döngü) -- ince ayar vs sıfırdan eğitim:
  İnce ayar   ilk 3 kayıp: [9.574, 8.208, 6.509] (eşiğin altına düştüğü adım: 48)
  Sıfırdan    ilk 3 kayıp: [1.209, 0.962, 0.774] (eşiğin altına düştüğü adım: 26)

Bu sefer ince ayar daha kötü başlıyor (kayıp 9.57!) ve eşiğin altına daha geç (48. adım)
düşüyor -- sıfırdan modelden (26. adım) bile yavaş. Ön eğitimdeki 'saat yönünde' önyargı,
ters yönlü göreve zarar veriyor (negatif transfer) -- ince ayarın önce bu önyargıyı
'unutması' gerekiyor.
Matematik
RLHF ve DPO: aynı hedef, farklı yol
RLHF (Reinforcement Learning from Human Feedback), üç adımlı bir süreçtir:
DPO (Direct Preference Optimization), bu iki aşamayı (ödül modeli eğitimi + RL) tek bir kayıp fonksiyonunda birleştirir:
| Sembol | Anlamı |
|---|---|
| Tercih edilen (winner) cevap | |
| Reddedilen (loser) cevap | |
| Eğitilmekte olan model | |
| İnce ayarlı (SFT) referans model |
DPO’nun avantajı: ayrı bir ödül modeli eğitmeye veya PPO gibi kararsız bir RL döngüsüne gerek yok — sadece tercih çiftleriyle, standart gradyan inişiyle aynı hedefe ulaşılır.
Kod
Üçüncü aşamayı (hizalama) kavramsal olarak özetleyelim — bu ölçekte kod ile gösterilemez çünkü insan tercih verisi gerektirir:
RLHF ve DPO: kavramsal özet
# Aşama 3: hizalama (alignment). İnce ayar, modeli bir göreve uydurur -- ama modelin
# çıktılarının insan tercihleriyle (yardımcı, zararsız, dürüst) uyumlu olmasını
# garanti etmez. Bunun için iki yaygın yöntem:
print("\nRLHF (İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme):")
print("  1. İnsanlar, aynı istem için modelin ürettiği birkaç cevabı sıralar (hangisi daha iyi?).")
print("  2. Bu sıralama verisiyle bir 'ödül modeli' (reward model) eğitilir: cevap ne kadar iyi?")
print("  3. Ana model, bu ödül modelini maksimize edecek şekilde pekiştirmeli öğrenmeyle (PPO)")
print("     Güncellenir -- ödülü yüksek cevaplar üretmeye 'teşvik edilir'.")
print("\nDPO (Doğrudan Tercih Optimizasyonu, 2023):")
print("  RLHF'in ayrı bir ödül modeli + pekiştirmeli öğrenme döngüsü gerektirmesi, eğitimi")
print("  karmaşık ve kararsız yapabilir. DPO, aynı tercih verisini (seçilen vs reddedilen cevap)")
print("  Doğrudan bir sınıflandırma benzeri kayıp fonksiyonuna çevirir -- ayrı bir ödül modeli")
print("  veya RL döngüsü olmadan, sadece gradyan inişiyle aynı hizalama hedefine ulaşır.")
print("\nBu üç aşama (ön eğitim -> ince ayar -> hizalama) sırayla uygulanır -- her biri bir")
print("öncekinin üzerine inşa edilir; bu notebook'taki mini modeller sadece ilk iki aşamayı")
print("gösteriyor (RLHF/DPO, insan tercih verisi gerektirdiği için bu ölçekte gösterilemiyor).")
RLHF (İnsan Geri Bildirimiyle Pekiştirmeli Öğrenme):
1. İnsanlar, aynı istem için modelin ürettiği birkaç cevabı sıralar (hangisi daha iyi?).
2. Bu sıralama verisiyle bir 'ödül modeli' (reward model) eğitilir: cevap ne kadar iyi?
3. Ana model, bu ödül modelini maksimize edecek şekilde pekiştirmeli öğrenmeyle (PPO)
Güncellenir -- ödülü yüksek cevaplar üretmeye 'teşvik edilir'.
DPO (Doğrudan Tercih Optimizasyonu, 2023):
RLHF'in ayrı bir ödül modeli + pekiştirmeli öğrenme döngüsü gerektirmesi, eğitimi
karmaşık ve kararsız yapabilir. DPO, aynı tercih verisini (seçilen vs reddedilen cevap)
Doğrudan bir sınıflandırma benzeri kayıp fonksiyonuna çevirir -- ayrı bir ödül modeli
veya RL döngüsü olmadan, sadece gradyan inişiyle aynı hizalama hedefine ulaşır.
Bu üç aşama (ön eğitim -> ince ayar -> hizalama) sırayla uygulanır -- her biri bir
öncekinin üzerine inşa edilir; bu notebook'taki mini modeller sadece ilk iki aşamayı
gösteriyor (RLHF/DPO, insan tercih verisi gerektirdiği için bu ölçekte gösterilemiyor).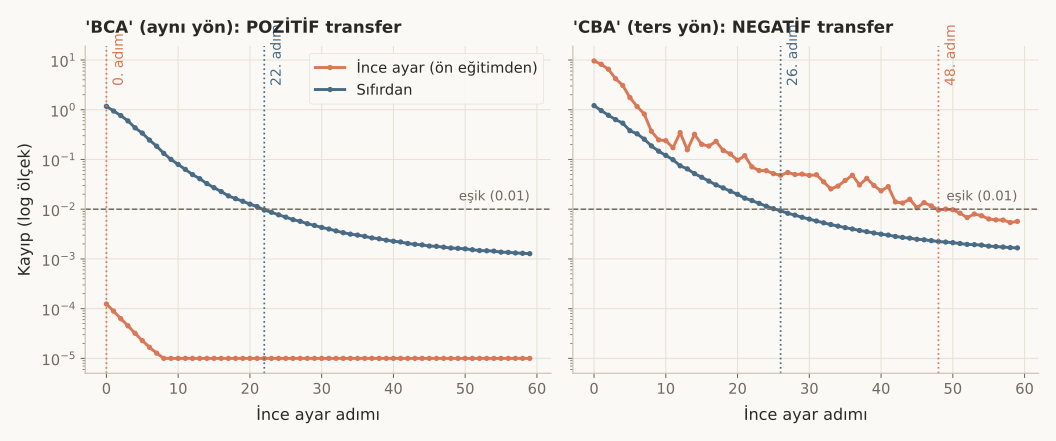 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu üç aşamalı tarif, günümüzün tüm büyük dil modellerinin (GPT-4, Claude, LLaMA…) standart eğitim sürecidir:
- Pozitif/negatif transfer, gerçek ince ayarda da geçerlidir — bir kod-yazma modelini şiir yazmaya ince ayar yapmak, kod yazma modelini başka bir programlama diline ince ayar yapmaktan çok daha zordur (daha az paylaşılan yapı).
- “Katastrofik unutma” (catastrophic forgetting), negatif transferin uç bir biçimidir: ince ayar, modelin önceki (ön eğitimdeki) yeteneklerini kaybetmesine yol açabilir — bu dersteki CBA örneğinde model önce “unutmak”, sonra yeniden öğrenmek zorunda kaldı.
- RLHF/DPO, ince ayardan sonra gelir, öncesinde değil — önce model talimat takip etmeyi öğrenir (SFT), sonra çıktıları insan tercihleriyle inceltilir.
Bu 2 hatayı yaparsın:
- İnce ayarın her zaman sıfırdan eğitimden hızlı olduğunu sanmak — bu dersteki CBA örneği tersini kanıtlıyor: ilgisiz veya çelişen bir görevde ince ayar, sıfırdan eğitimden bile yavaş olabilir.
- RLHF ve DPO’yu “aynı şey, farklı isim” sanmak — ikisi de aynı hedefe (insan tercihleriyle uyum) ulaşır ama RLHF ayrı bir ödül modeli + RL döngüsü kullanırken, DPO bunu tek bir kayıp fonksiyonuna indirger.
Kendini test et
1. Notebook'ta 'BCA' görevinde ince ayar adım 0'da kayıpsız başlarken, 'CBA' görevinde kayıp 9.57 ile yüksek başlıyor. Bu farkın nedeni ne?
- Rastgele bir sonuç
- 'BCA', ön eğitimdeki aynı döngüsel kuralı (A->B->C->A) paylaşıyor -- sadece başlangıç noktası farklı, bu yüzden öğrenilen bilgi doğrudan aktarılıyor (pozitif transfer). 'CBA' ise ters yönde bir kural gerektiriyor, bu da ön eğitimdeki önyargıyla çelişiyor (negatif transfer) (doğru cevap)
- 'CBA' kelimesi daha uzun olduğu için
- Model CBA örüntüsünü hiç öğrenemez
Neden: ince-ayar-pozitif-transfer ve ince-ayar-negatif-transfer bloklarında aynı mimari, aynı ön eğitilmiş model kullanılıyor -- tek fark, yeni görevin ön eğitimle paylaştığı yapı; bu da sonucu doğrudan belirliyor.
2. Notebook'ta 'CBA' görevinde ince ayarlı model (48. adımda eşiğin altına iniyor), sıfırdan eğitilen modelden (26. adım) bile yavaş kalıyor. Bu nasıl mümkün olabilir -- ince ayar 'baştan başlamıyor muydu'?
- Bu bir hesaplama hatası
- İnce ayar sıfırdan başlamıyor -- ön eğitimden gelen (bu görevle çelişen) bir önyargıyla başlıyor; model önce bu yanlış önyargıyı 'unutmak', sonra doğru kuralı öğrenmek zorunda, bu da rastgele başlangıçtan bile daha fazla adım gerektirebilir (doğru cevap)
- Sıfırdan eğitim her zaman daha hızlıdır
- İnce ayar hiçbir zaman işe yaramaz
Neden: ince-ayar-negatif-transfer bloğunun çıktısı bunu açıkça özetliyor: 'ön eğitimdeki saat yönündeki önyargı, ters yönlü göreve zarar veriyor -- ince ayarın önce bu önyargıyı unutması gerekiyor', bu da sıfırdan başlamaktan daha yavaş olabilir.
3. DPO (Direct Preference Optimization), RLHF'e kıyasla ne kazandırır?
- Hiçbir fark yoktur, DPO sadece RLHF'in başka bir ismidir
- Aynı tercih verisini (seçilen vs reddedilen cevap) kullanır ama ayrı bir ödül modeli eğitmeye veya PPO gibi bir pekiştirmeli öğrenme döngüsüne gerek duymadan, tek bir kayıp fonksiyonuyla, standart gradyan inişiyle aynı hizalama hedefine ulaşır (doğru cevap)
- DPO, insan tercih verisine ihtiyaç duymaz
- DPO sadece küçük modellerde çalışır
Neden: MathBox'taki DPO formülü, RLHF'in iki aşamasını (ödül modeli + RL) tek bir log-sigmoid kaybına indirgiyor -- hizalama bloğunda bu, 'eğitimi karmaşık ve kararsız yapabilen' RL döngüsünden kaçınma avantajı olarak açıklanıyor.
Özet
Özet
- Büyük dil modeli eğitimi üç aşamadan oluşur: ön eğitim (dil nasıl işler), ince ayar (belirli görev), hizalama (insan tercihleri).
- İnce ayar, yeni görev ön eğitimle paylaştığı yapıya bağlı olarak pozitif transfer (anında düşük kayıp) veya negatif transfer (sıfırdan eğitimden bile yavaş) gösterebilir.
- Bu dersteki BCA (aynı yön) örneği pozitif transferi, CBA (ters yön) örneği negatif transferi sayılarla kanıtladı.
- RLHF, insan tercihleriyle eğitilen bir ödül modelini pekiştirmeli öğrenmeyle (PPO) maksimize eder.
- DPO, aynı tercih verisini tek bir kayıp fonksiyonuna çevirerek ayrı ödül modeli/RL döngüsü ihtiyacını ortadan kaldırır.