

Pozisyonel kodlama
Önkoşul:Multi-head attention
Kanca
“Kedi köpeği kovaladı” ile “Köpeği kedi kovaladı” — self-attention için bu iki cümle, konum bilgisi olmadan, aynı “kelime kümesi”. Bir mekanizma bu kadar güçlüyken, kelime sırasını nasıl bu kadar kolay “unutabilir”?
Sezgi
Self-attention, her token’ı diğer her token’la karşılaştırır — ama bu karşılaştırma, token’ların dizideki sırasına değil, sadece içeriklerine bakar. RNN’de sıra otomatikti (7-8. ders): bilgi soldan sağa akardı. Self-attention’da böyle bir akış yok — bu yüzden konum bilgisini ayrıca eklemek gerekiyor. Aşağıda sinüzoidal kodlamanın her konum için nasıl benzersiz bir “parmak izi” ürettiğini incele:
Soldaki bir konuma (satıra) tıkla -- diğer tüm konumlarla ne kadar "benzer" olduğunu gör:
Bir konuma tıkla, göreli benzerliği gör.
İpucu: yakın konumların çubukları uzun, uzak konumlarınki kısa olacak.
Mekanizma
Önce sorunu sayılarla kanıtlayalım: token’ları karıştırıp geri sıralarsak, çıktı değişmeli miydi?
Self-attention, sırayı görmüyor
# Self-attention'ın gizli bir sorunu var: konum (position) kavramı yok. Bir kelimenin
# cümledeki 1. mi, yoksa 5. mi olduğunu bilmiyor -- sadece kelimelerin birbiriyle
# benzerliğine bakıyor. Bunu kanıtlayalım: token'ları karıştırıp (permute) aynı
# hesaplamayı tekrarlayalım.
N, D = 5, 8
X = torch.randn(N, D)
Wq, Wk, Wv = torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5

def calistir(X_girdi):
    Q, K, V = X_girdi @ Wq, X_girdi @ Wk, X_girdi @ Wv
    return dikkat(Q, K, V)

cikti_orijinal, _ = calistir(X)

permutasyon = torch.tensor([2, 0, 4, 1, 3])
X_karisik = X[permutasyon]
cikti_karisik, _ = calistir(X_karisik)

# Karışık çıktıyı aynı permütasyonla geri "düzeltirsek", orijinalle aynı mı olmalı?
cikti_karisik_geri = torch.zeros_like(cikti_karisik)
cikti_karisik_geri[permutasyon] = cikti_karisik

fark = (cikti_orijinal - cikti_karisik_geri).abs().max().item()
print(f"Token sırası karıştırıldı (permütasyon: {permutasyon.tolist()}), sonra çıktı geri sıralandı.")
print(f"Orijinal çıktı ile karıştırılıp-geri-sıralanan çıktı arasındaki fark: {fark:.2e}")
print(f"torch.allclose: {torch.allclose(cikti_orijinal, cikti_karisik_geri, atol=1e-6)}")
print("\nSonuç: self-attention, token'ların sırasını 'görmüyor' -- sadece hangi token'ların")
print("var olduğunu görüyor. 'Kedi köpeği kovaladı' ile 'Köpeği kedi kovaladı', konum bilgisi")
print("olmadan, attention için aynı 'küme'dir.")
Token sırası karıştırıldı (permütasyon: [2, 0, 4, 1, 3]), sonra çıktı geri sıralandı.
Orijinal çıktı ile karıştırılıp-geri-sıralanan çıktı arasındaki fark: 2.38e-07
torch.allclose: True
Sonuç: self-attention, token'ların sırasını 'görmüyor' -- sadece hangi token'ların
var olduğunu görüyor. 'Kedi köpeği kovaladı' ile 'Köpeği kedi kovaladı', konum bilgisi
olmadan, attention için aynı 'küme'dir.Fark 2.38e-07 — pratikte sıfır. Token’ları karıştırıp geri sıralamak, hesaplamayı hiç etkilemiyor. Şimdi çözümü kuralım:
Sinüzoidal pozisyonel kodlama
# Çözüm: her konuma (position) özel, sabit bir vektör ekle -- "Attention is All You
# Need" makalesinin sinüzoidal kodlaması:
def pozisyonel_kodlama(uzunluk, boyut):
    pe = torch.zeros(uzunluk, boyut)
    pozisyon = torch.arange(uzunluk).unsqueeze(1).float()
    bolen = torch.exp(torch.arange(0, boyut, 2).float() * (-math.log(10000.0) / boyut))
    pe[:, 0::2] = torch.sin(pozisyon * bolen)
    pe[:, 1::2] = torch.cos(pozisyon * bolen)
    return pe

PE = pozisyonel_kodlama(N, D)
print(f"\nPozisyonel kodlama şekli: {tuple(PE.shape)}")
print(f"Konum 0'ın kodlaması: {[round(v,3) for v in PE[0].tolist()]}")
print(f"Konum 1'in kodlaması: {[round(v,3) for v in PE[1].tolist()]}")
print("Konum 0'ın kodlaması hep [0, 1, 0, 1, ...] ile başlar (sin(0)=0, cos(0)=1) -- sabit bir başlangıç noktası.")
Pozisyonel kodlama şekli: (5, 8)
Konum 0'ın kodlaması: [0.0, 1.0, 0.0, 1.0, 0.0, 1.0, 0.0, 1.0]
Konum 1'in kodlaması: [0.841, 0.54, 0.1, 0.995, 0.01, 1.0, 0.001, 1.0]
Konum 0'ın kodlaması hep [0, 1, 0, 1, ...] ile başlar (sin(0)=0, cos(0)=1) -- sabit bir başlangıç noktası.
PE eklenince, sıra artık önemli
# Şimdi X'e PE'yi ekleyip aynı karıştırma testini tekrarlayalım.
X_pozisyonlu = X + PE

def calistir_pozisyonlu(X_girdi, PE_girdi):
    X_toplam = X_girdi + PE_girdi
    Q, K, V = X_toplam @ Wq, X_toplam @ Wk, X_toplam @ Wv
    return dikkat(Q, K, V)

cikti_poz_orijinal, _ = calistir_pozisyonlu(X, PE)
# Dikkat: X karıştırılıyor ama PE karıştırılmıyor -- pozisyonlar sabit kalıyor,
# çünkü PE 'bu token 3. sırada' der, token'ın kendisiyle değil.
cikti_poz_karisik, _ = calistir_pozisyonlu(X_karisik, PE)
cikti_poz_karisik_geri = torch.zeros_like(cikti_poz_karisik)
cikti_poz_karisik_geri[permutasyon] = cikti_poz_karisik

fark_poz = (cikti_poz_orijinal - cikti_poz_karisik_geri).abs().max().item()
print(f"\nPE eklendikten sonra, aynı karıştır-geri-sırala testi -- fark: {fark_poz:.4f}")
print(f"torch.allclose: {torch.allclose(cikti_poz_orijinal, cikti_poz_karisik_geri, atol=1e-6)}")
print("Artık eşleşmiyor! PE eklenince, hangi token'ın hangi konumda olduğu sonucu değiştiriyor --")
print("self-attention artık 'sırasız bir küme' değil, 'sıralı bir dizi' işliyor.")
PE eklendikten sonra, aynı karıştır-geri-sırala testi -- fark: 1.4039
torch.allclose: False
Artık eşleşmiyor! PE eklenince, hangi token'ın hangi konumda olduğu sonucu değiştiriyor --
self-attention artık 'sırasız bir küme' değil, 'sıralı bir dizi' işliyor.
Fark 1.40’a çıktı — artık token’ları karıştırıp geri sıralamak sonucu değiştiriyor, çünkü her token’a “ben kaçıncı sıradayım” bilgisi eklendi.
Matematik
Sinüzoidal pozisyonel kodlama
| Sembol | Anlamı |
|---|---|
| Token’ın dizideki konumu (0, 1, 2, …) | |
| Boyut çiftinin indeksi (her için bir sin, bir cos boyutu) | |
| Gömme boyutu |
Bu formül iki nedenle seçildi: (1) her konum için benzersiz bir vektör üretir, (2) yakın konumların vektörleri birbirine benzer, uzak konumlarınki farklı — yani model göreli mesafeyi “hissedebilir”. Öğrenilen bir kodlama yerine sabit bir formül kullanılması, modelin eğitimde görmediği uzunluktaki dizilere de (sınırlı ölçüde) genelleyebilmesini sağlar.
Kod
Bu “yakın = benzer, uzak = farklı” özelliğini doğrudan ölçelim:
Kosinüs benzerliği, mesafeyle azalıyor
# PE vektörlerinin bir başka özelliği: yakın konumların kodlamaları birbirine benzer,
# uzak konumların kodlamaları farklı -- göreli konum bilgisini taşıyor.
# Gerçekçi bir boyutla (gerçek Transformer'lar d_model=512-768 kullanır, biz 64 ile
# gösteriyoruz) bu ilişki çok daha pürüzsüz görünür:
D_BUYUK = 64
PE_uzun = pozisyonel_kodlama(30, D_BUYUK)
referans = PE_uzun[5]
print(f"\nKonum 5'in kodlamasıyla diğer konumların kosinüs benzerliği (boyut={D_BUYUK}):")
for hedef in [4, 6, 10, 15, 20]:
    benzerlik = F.cosine_similarity(referans, PE_uzun[hedef], dim=0).item()
    uzaklik = abs(hedef - 5)
    print(f"  konum {hedef:<3} (uzaklık={uzaklik:<2}) benzerlik={benzerlik:.3f}")
print("\nUzaklık arttıkça benzerlik düzenli biçimde azalıyor -- model, 'bu iki kelime yakın' ile")
print("'bu iki kelime uzak' arasındaki farkı, kodlamaların geometrisinden çıkarabilir.")
print("(Not: sinüzoidal kodlama periyodik olduğu için çok büyük uzaklıklarda bu azalış")
print("tekrar dalgalanabilir -- ama modelin göreceği tipik dizi uzunluklarında sorun değildir.)")
Konum 5'in kodlamasıyla diğer konumların kosinüs benzerliği (boyut=64):
konum 4 (uzaklık=1 ) benzerlik=0.966
konum 6 (uzaklık=1 ) benzerlik=0.966
konum 10 (uzaklık=5 ) benzerlik=0.734
konum 15 (uzaklık=10) benzerlik=0.658
konum 20 (uzaklık=15) benzerlik=0.608
Uzaklık arttıkça benzerlik düzenli biçimde azalıyor -- model, 'bu iki kelime yakın' ile
'bu iki kelime uzak' arasındaki farkı, kodlamaların geometrisinden çıkarabilir.
(Not: sinüzoidal kodlama periyodik olduğu için çok büyük uzaklıklarda bu azalış
tekrar dalgalanabilir -- ama modelin göreceği tipik dizi uzunluklarında sorun değildir.)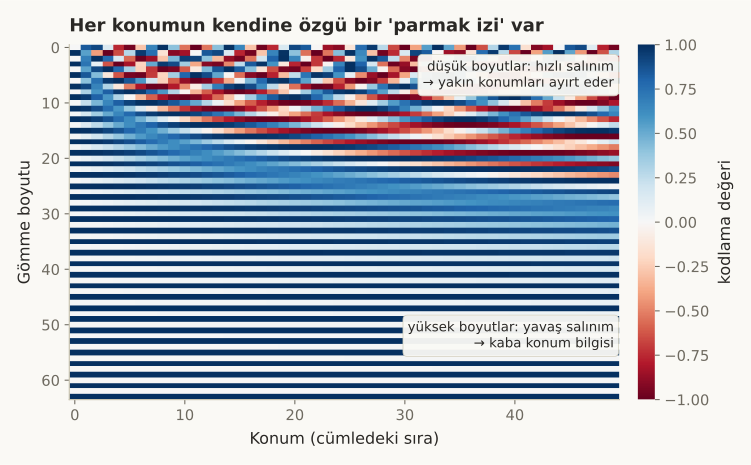 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Pozisyonel kodlama, “Attention is All You Need” makalesinin (18. ders) ele aldığı son parça:
- Bu kodlama, gömmeye toplanır (concat değil, +) — yani ; model, ikisinin karışımından hem “ne” hem “nerede” bilgisini çıkarmayı öğrenir.
- GPT gibi modern modeller genelde öğrenilen pozisyonel kodlama kullanır (sabit formül yerine, her konum için bir embedding vektörü eğitilir) — daha esnek ama eğitimde görülmeyen uzunluklara genellemez.
- RoPE (Rotary Positional Embedding) gibi daha yeni yöntemler (LLaMA, çoğu modern LLM), konumu Q ve K’ya toplama yerine döndürme (rotation) ile ekler — bu dersin kapsamı dışında ama aynı temel sorunu (sıra bilgisi) çözer.
Bu 2 hatayı yaparsın:
- Pozisyonel kodlamayı “isteğe bağlı bir iyileştirme” sanmak — hayır, onsuz self-attention kelime sırasını hiç göremez; bu opsiyonel değil, zorunludur.
- Sinüzoidal kodlamanın mutlak konumu (kelime tam olarak kaçıncı sırada) kodladığını, göreli konumu (iki kelime birbirine ne kadar yakın) kodlamadığını düşünmek — aslında her ikisini de, farklı derecelerde taşır (bu dersteki benzerlik-mesafe deneyi göreli tarafı gösteriyor).
Kendini test et
1. Notebook'ta token'ları karıştırıp geri sıralamak, PE eklenmeden önce çıktıyı değiştirmezken (fark 2.38e-07), PE eklendikten sonra değiştiriyor (fark 1.40). Bu neyi kanıtlıyor?
- PE eklenmesi bir hata kaynağıdır
- Self-attention'ın kendisi token sırasına duyarsızdır (permütasyon değişmez); PE, her token'a 'ben kaçıncı sıradayım' bilgisini ekleyerek modelin sırayı ayırt etmesini sağlar (doğru cevap)
- İki test de aynı sonucu vermeliydi
- Bu sadece küçük modellerde görülen bir durumdur
Neden: sirasizlik-kanit bloğunda fark pratikte sıfırken (2.38e-07), kodlama-eklenince bloğunda fark 1.40'a çıkıyor -- bu, PE'nin tam olarak çözmesi gereken sorunu (konum körlüğü) çözdüğünü kanıtlıyor.
2. Sinüzoidal pozisyonel kodlama formülünde neden sin ve cos'un ikisi birden kullanılır, tek bir fonksiyon değil?
- Rastgele bir tercih, önemi yok
- Her boyut çiftinde (sin, cos) farklı frekanslarla, her konum için benzersiz bir vektör üretmek ve yakın konumların vektörlerinin birbirine benzer kalmasını sağlamak için (doğru cevap)
- Hesaplama hızını artırmak için
- Sadece negatif değerlerden kaçınmak için
Neden: MathBox'ta görüldüğü gibi her i için bir sin bir cos boyutu üretiliyor; bu, uzaklik-ile-benzerlik bloğunda gösterilen 'yakın konumlar benzer, uzak konumlar farklı' özelliğini sağlayan matematiksel yapı.
3. 'Kedi köpeği kovaladı' ile 'Köpeği kedi kovaladı' örneği, pozisyonel kodlama olmadan self-attention için neden aynı 'küme'?
- Bu iki cümle Türkçede aynı anlama gelir
- Self-attention token'ların hangi sırada olduğunu değil, sadece hangi token'ların var olduğunu ve birbirleriyle ne kadar benzer olduğunu görür -- konum bilgisi olmadan iki farklı sıralama aynı hesaplamayı üretir (doğru cevap)
- Attention mekanizması Türkçe dilbilgisini anlamaz
- Bu örnekte kelimeler yanlış seçilmiştir
Neden: sirasizlik-kanit bloğu tam olarak bunu gösteriyor: aynı token kümesinin farklı sıralamaları, permütasyonu geri aldığınızda identik çıktı üretiyor -- self-attention'ın sıraya duyarsız (permütasyon değişmez) olduğunun kanıtı.
Özet
Özet
- Self-attention, token'ların sırasına değil, sadece içeriklerine bakar -- permütasyon değişmezdir (kanıt: karıştır-geri-sırala testi, fark ~0).
- Sinüzoidal pozisyonel kodlama, her konuma sabit, benzersiz bir vektör atar ve gömmeye toplanır.
- PE eklendikten sonra, token sırası sonucu değiştirir (kanıt: aynı test, fark 1.40).
- PE vektörleri arasındaki kosinüs benzerliği, konumlar arasındaki uzaklıkla (genelde) azalır -- göreli konum bilgisi taşır.
- Gerçek modern modeller (GPT, LLaMA) genelde öğrenilen veya döndürme-tabanlı (RoPE) kodlama kullanır -- aynı temel sorunu farklı şekilde çözerler.