

RNN
Önkoşul:Word embedding (Word2Vec, GloVe)
Kanca
- derste kelimeleri anlamlı vektörlere çevirmeyi öğrendik. Ama bir cümle, kelimelerin sadece bir kümesi değil, bir dizisidir — sıra önemlidir. RNN (Recurrent Neural Network), bir diziyi kelime kelime işleyip bir “hafıza” taşıyan ilk mimari.
Sezgi
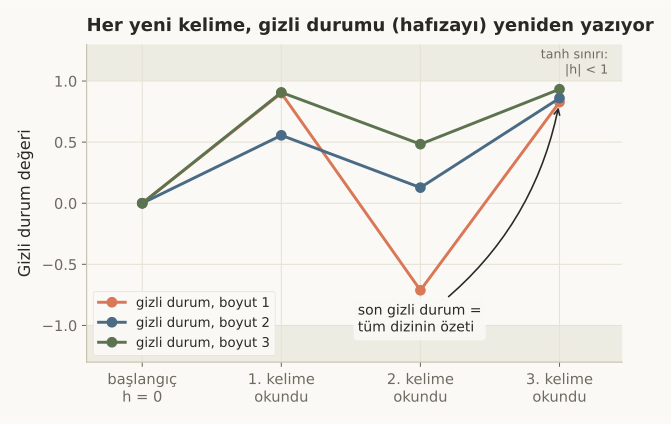
RNN, bir diziyi tek tek işler ve her adımda bir “gizli durum” (hidden state) günceller — bu gizli durum, o ana kadar görülen her şeyin bir özeti gibi davranır. Her yeni kelime, hem kendisini hem de önceki gizli durumu kullanarak yeni bir gizli durum üretir.
Mekanizma
Küçük bir RNN’i 3 adımlık bir dizide çalıştıralım:
RNN'in temel akışı
# RNN (Recurrent Neural Network), bir diziyi tek tek, bir "gizli durum" (hafıza)
# taşıyarak işler. Her adımda: yeni gizli durum = f(şu anki girdi, önceki gizli durum).
rnn = nn.RNN(input_size=4, hidden_size=3, batch_first=True)

dizi = torch.randn(1, 3, 4)  # (batch=1, 3 adımlık dizi, her adım 4 boyutlu)
cikis, son_gizli = rnn(dizi)
print("Girdi şekli:", tuple(dizi.shape), "(batch, sekans_uzunluğu, embedding_boyutu)")
print("Her adımdaki gizli durum şekli:", tuple(cikis.shape))
print("\nHer adımdaki gizli durum (h_t):")
for t in range(3):
    print(f"  h_{t}: {[round(v,3) for v in cikis[0,t].tolist()]}")
Girdi şekli: (1, 3, 4) (batch, sekans_uzunluğu, embedding_boyutu)
Her adımdaki gizli durum şekli: (1, 3, 3)
Her adımdaki gizli durum (h_t):
h_0: [0.901, 0.556, 0.907]
h_1: [-0.712, 0.128, 0.483]
h_2: [0.827, 0.86, 0.933]Formülü elle uygulayıp PyTorch’un sonucuyla doğrulayalım:
Elle hesaplama vs PyTorch
# RNN'nin formülünü elle uygulayıp PyTorch'un sonucuyla karşılaştıralım.
W_ih, W_hh = rnn.weight_ih_l0, rnn.weight_hh_l0
b_ih, b_hh = rnn.bias_ih_l0, rnn.bias_hh_l0

h = torch.zeros(3)  # başlangıç gizli durumu -- sıfır
elle_gizli = []
for t in range(3):
    h = torch.tanh(W_ih @ dizi[0, t] + b_ih + W_hh @ h + b_hh)
    elle_gizli.append([round(v, 3) for v in h.tolist()])

print("\nElle hesaplanan (h_t = tanh(W_ih·x_t + b_ih + W_hh·h_{t-1} + b_hh)):")
for t, hv in enumerate(elle_gizli):
    print(f"  h_{t}: {hv}")
print(f"\nPyTorch ile birebir aynı mı? {all(abs(a-b) < 1e-4 for t in range(3) for a,b in zip(elle_gizli[t], [round(v,3) for v in cikis[0,t].tolist()]))}")
Elle hesaplanan (h_t = tanh(W_ih·x_t + b_ih + W_hh·h_{t-1} + b_hh)):
  h_0: [0.901, 0.556, 0.907]
  h_1: [-0.712, 0.128, 0.483]
  h_2: [0.827, 0.86, 0.933]

PyTorch ile birebir aynı mı? True
Şimdi asıl önemli soru: sıra gerçekten önemli mi?
Aynı kelimeler, ters sıra
# RNN'nin kritik özelliği: her adımdaki gizli durum, önceki tüm dizinin sırasına bağlıdır.
dizi_ters = dizi[:, [2, 1, 0], :]  # Aynı 3 "kelime", ters sırada
_, son_gizli_ters = rnn(dizi_ters)

print(f"\nOrijinal sıra, son gizli durum: {[round(v,3) for v in son_gizli[0,0].tolist()]}")
print(f"Ters sıra, son gizli durum:     {[round(v,3) for v in son_gizli_ters[0,0].tolist()]}")
print(f"Aynı mı? {torch.allclose(son_gizli, son_gizli_ters)}")
print("Aynı 3 vektör, sadece sırası değişince, tamamen farklı bir son gizli durum üretiyor.")
Orijinal sıra, son gizli durum: [0.827, 0.86, 0.933]
Ters sıra, son gizli durum:     [0.934, 0.672, 0.951]
Aynı mı? False
Aynı 3 vektör, sadece sırası değişince, tamamen farklı bir son gizli durum üretiyor.
Aynı 3 vektör, sadece sırası değişince, tamamen farklı bir son gizli durum üretiyor. Çoğu kişi “sinir ağları girdiyi bir küme gibi işler” sanır (4. kategorideki CNN’ler gibi konum-hassas olsa da, bag-of-words böyle değildi). RNN’de yanlış, çünkü her adım, önceki adımların gizli durumuna bağlı — sıra, matematiğin içine gömülü.
Matematik
RNN'in tekrarlayan (recurrent) formülü
| Sembol | Anlamı |
|---|---|
| . adımdaki girdi (örn. . kelimenin embedding’i) | |
| Bir önceki adımın gizli durumu — “hafıza” | |
| Bu adımın yeni gizli durumu — hem ‘yi hem ‘i “özetler” | |
| Öğrenilebilir ağırlık matrisleri — tüm adımlarda paylaşılır |
ve ‘nin her adımda aynı kalması (paylaşılması), 27. DL Vision dersindeki “aynı çekirdeği her konuma uygula” fikrinin dizilerdeki karşılığıdır.
Kod
Şimdi 1. dersin o çarpıcı örneğine dönelim — ama bu kez RNN ile:
1. dersin sorununu RNN çözüyor mu?
# 1. dersteki o çarpıcı örneğe dönelim: bag-of-words'ün ayırt edemediği iki cümle.
kelimeler_p = ["bu", "film", "çok", "iyi", "hiç", "kötü", "değil"]  # Olumlu
kelimeler_n = ["bu", "film", "hiç", "iyi", "değil", "çok", "kötü"]  # Olumsuz

dagarcik = sorted(set(kelimeler_p) | set(kelimeler_n))
EMBED_BOYUT = 8
embedding_tablosu = {k: torch.randn(EMBED_BOYUT) for k in dagarcik}  # rastgele (henüz eğitilmemiş) embedding'ler

def diziye_cevir(kelimeler):
    return torch.stack([embedding_tablosu[k] for k in kelimeler]).unsqueeze(0)

rnn2 = nn.RNN(input_size=EMBED_BOYUT, hidden_size=4, batch_first=True)
_, h_p = rnn2(diziye_cevir(kelimeler_p))
_, h_n = rnn2(diziye_cevir(kelimeler_n))

def bow(kelimeler, dagarcik):
    sayim = Counter(kelimeler)
    return [sayim.get(k, 0) for k in dagarcik]

print(f"\n1. dersteki bag-of-words vektörleri aynı mı? {bow(kelimeler_p, dagarcik) == bow(kelimeler_n, dagarcik)}")
print(f"RNN'nin son gizli durumları aynı mı? {torch.allclose(h_p, h_n)}")
print(f"\nPozitif cümle son gizli durum: {[round(v,3) for v in h_p[0,0].tolist()]}")
print(f"Negatif cümle son gizli durum: {[round(v,3) for v in h_n[0,0].tolist()]}")
print("\nRNN henüz eğitilmemiş olsa bile (rastgele ağırlıklarla), sıraya duyarlı olduğu için")
print("bu iki cümleyi farklı temsillere çeviriyor -- 1. dersteki sorunun doğrudan çözümü.")
1. dersteki bag-of-words vektörleri aynı mı? True
RNN'nin son gizli durumları aynı mı? False

Pozitif cümle son gizli durum: [-0.47, -0.932, -0.88, -0.601]
Negatif cümle son gizli durum: [-0.085, -0.911, -0.76, -0.304]

RNN henüz eğitilmemiş olsa bile (rastgele ağırlıklarla), sıraya duyarlı olduğu için
bu iki cümleyi farklı temsillere çeviriyor -- 1. dersteki sorunun doğrudan çözümü.- dersteki bag-of-words vektörleri aynı; RNN’in son gizli durumları farklı. Ve bu RNN henüz hiç eğitilmedi — sadece rastgele ağırlıklarla bile, mimarinin kendisi sıraya duyarlı.
 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
RNN, sıralı veri (metin, ses, zaman serisi) işlemenin ilk derin öğrenme çözümüydü:
nn.RNN, PyTorch’ta hazır bir katman olarak gelir — ama 8. derste göreceğimiz gibi, pratikte saf RNN nadiren kullanılır.- Gizli durum boyutu, ne kadar “hafıza” taşınabileceğini sınırlar — küçük boyut, az bilgi; büyük boyut, daha fazla hesaplama.
- RNN’ler, diziyi soldan sağa (veya çift yönlü) işler — bu, 9-10. derste göreceğimiz attention’ın doğrudan taşıma yaklaşımından temel farkıdır.
Bu 3 hatayı yaparsın:
- RNN’i “hafızasız” bir katman sanmak — asıl gücü tam olarak bu hafıza (gizli durum) mekanizması.
- Ağırlıkların her adımda farklı olduğunu sanmak — ve tüm adımlarda paylaşılır.
- RNN’in mükemmel bir çözüm olduğunu düşünmek — 8. derste, uzun dizilerde bu mimarinin ciddi sınırlarını göreceğiz.
Kendini test et
1. Notebook'ta aynı 3 vektör, ters sırada verildiğinde RNN'in son gizli durumu neden değişti?
- Kod hatalıydı
- Her adımdaki gizli durum, önceki tüm adımların sırasına bağlıdır -- h_t hesaplanırken h_{t-1} kullanılır, bu da sırayı formülün içine gömer (doğru cevap)
- RNN girdiyi rastgele karıştırır
- Ağırlıklar her çalıştırmada değişir
Neden: RNN'in formülü h_t = tanh(...+ W_hh·h_{t-1} + ...) şeklindedir -- her adım, bir önceki adımın sonucunu girdi olarak kullanır, bu yüzden aynı öğeler farklı sırada verildiğinde farklı bir hesaplama zinciri oluşur.
2. Notebook'ta 1. dersteki bag-of-words vektörleri aynı iken RNN'in son gizli durumları neden farklı çıktı?
- RNN yanlış çalışıyordu
- Bag-of-words sadece kelime sayımını tutar (sıradan bağımsız); RNN ise her kelimeyi sırayla işleyip önceki durumu hatırladığı için sıraya duyarlıdır (doğru cevap)
- İki yöntem de aynı sonucu vermeliydi
- RNN kelimeleri anlamıyor
Neden: Bag-of-words, "kaç tane" sorusuna cevap verir ve sırayı tamamen atar; RNN ise dizinin içinden geçerken her adımda bir önceki duruma bağlı yeni bir durum ürettiği için, aynı kelimelerin farklı sırası farklı bir son duruma yol açar.
3. RNN'in W_ih ve W_hh ağırlıklarının her zaman adımında paylaşılması ne anlama gelir?
- Her adımda farklı ağırlıklar kullanılır
- Dizinin 1. kelimesi ile 10. kelimesi, aynı ağırlık matrisleriyle işlenir -- bu da RNN'in değişken uzunluktaki dizilere uygulanabilmesini sağlar (doğru cevap)
- Ağırlıklar eğitim sırasında hiç değişmez
- Bu, RNN'in bir zayıflığıdır
Neden: Ağırlık paylaşımı, 27. DL Vision dersindeki "aynı konvolüsyon çekirdeğini her konuma uygulama" fikrinin dizilerdeki karşılığıdır -- bu sayede RNN, eğitimde görmediği uzunluktaki dizilere bile uygulanabilir.
Özet
Özet
- RNN, bir diziyi tek tek işleyip her adımda bir gizli durumu (hafıza) günceller.
- h_t = tanh(W_ih·x_t + b_ih + W_hh·h_{t-1} + b_hh) formülü, her adımda aynı ağırlıklarla uygulanır.
- Bu tekrarlayan yapı, RNN'i doğal olarak sıraya duyarlı yapar -- bag-of-words'ün çözemediği bir sorunu çözer.
- Ağırlıkların adımlar arası paylaşılması, RNN'i değişken uzunluktaki dizilere uygulanabilir kılar.
- RNN, sıralı veri işlemenin ilk derin öğrenme çözümüydü -- ama 8. derste ciddi sınırlarını göreceğiz.