

Multi-head attention
Önkoşul:Attention'ın Python'la adım adım kurulumu
Kanca
- derste “o” zamirinin “Kedi”ye baktığını güzel yakaladık. Ama aynı başlık, “çıktı” kelimesinin “masaya” ile ilişkisini bulamadı — ağırlıkları neredeyse düzdü (0.136-0.204 arası). Neden? Çünkü bir cümlede birden fazla ilişki türü var, tek bir başlık hepsini aynı anda yakalayamıyor.
Sezgi
Çözüm: tek başlık yerine birden fazla başlığı paralel çalıştır — her biri kendi “alt-uzayında” (subspace) farklı bir ilişki türü arasın. Aşağıda bir token’a tıkla, iki başlığın aynı kelimeye nasıl farklı baktığını gör:
Bir token'a tıkla -- -- iki başlığın aynı kelimeye nasıl farklı baktığını gör:
Başlık 1: coreference
Başlık 2: eylem-konum
Aynı token, aynı cümle -- ama başlıklar farklı alt-uzaylarda çalıştığı için farklı ilişkileri "görüyorlar". Gerçek Transformer'larda 8-96 arası başlık aynı anda çalışır, her biri kendi uzmanlığını eğitimle (bizim burada elle tasarladığımız gibi değil) kendisi keşfeder.
Mekanizma
Önce, tek başlığın sınırını sayılarla hatırlayalım:
Tek başlık, 'çıktı' ilişkisini kaçırıyor
# 10. dersteki tek başlıklı self-attention, "o -> Kedi" ilişkisini güzel yakaladı
# (ağırlık 0.517). Ama aynı başlık, "çıktı" kelimesinin nereye (masaya) işaret
# ettiğini yakalayamadı -- ağırlıkları neredeyse düz (uniform):
TOKENLER = ["Kedi", "masaya", "çıktı", "çünkü", "o", "yorulmuştu"]
tek_baslik_ciktI_agirliklari = [0.136, 0.170, 0.204, 0.177, 0.139, 0.174]
print("10. dersteki tek başlığın 'çıktı' satırı (10. dersten alınan gerçek sonuç):")
for tok, a in zip(TOKENLER, tek_baslik_ciktI_agirliklari):
    print(f"  {tok:<12} ağırlık={a:.3f}")
print(f"\nEn yüksek ({max(tek_baslik_ciktI_agirliklari):.3f}) ile en düşük ({min(tek_baslik_ciktI_agirliklari):.3f}) arasındaki fark çok küçük --")
print("bu başlık 'eylem-konum' (çıktı -> masaya) ilişkisini yakalayamadı, çünkü boyutları")
print("sadece 'coreference' (o -> Kedi) ilişkisine göre ayarlanmıştı. Tek başlık, tek ilişki türü demek.")
10. dersteki tek başlığın 'çıktı' satırı (10. dersten alınan gerçek sonuç):
Kedi ağırlık=0.136
masaya ağırlık=0.170
çıktı ağırlık=0.204
çünkü ağırlık=0.177
o ağırlık=0.139
yorulmuştu ağırlık=0.174
En yüksek (0.204) ile en düşük (0.136) arasındaki fark çok küçük --
bu başlık 'eylem-konum' (çıktı -> masaya) ilişkisini yakalayamadı, çünkü boyutları
sadece 'coreference' (o -> Kedi) ilişkisine göre ayarlanmıştı. Tek başlık, tek ilişki türü demek.Şimdi 8 boyutlu gömmeyi 2 başlığa (her biri 4 boyutlu) bölelim — her başlık kendi matrisiyle çalışır:
Blok-köşegen ağırlık matrisi
# Çözüm: aynı anda birden fazla başlık çalıştır, her biri farklı bir alt-uzayda
# (subspace) farklı bir ilişki türü arasın. D=8 boyutu, H=2 başlığa (her biri 4
# boyutlu) bölünüyor.
H, D_TOPLAM, D_BAS = 2, 8, 4

# Head 1 (boyut 0:4) -- coreference ilişkisi için 10. dersteki aynı ağırlıklar (seed=2426).
torch.manual_seed(2426)
Wq1, Wk1, Wv1 = torch.randn(D_BAS, D_BAS) * 0.5, torch.randn(D_BAS, D_BAS) * 0.5, torch.randn(D_BAS, D_BAS) * 0.5
# Head 2 (boyut 4:8) -- eylem-konum ilişkisi için ayrı, taranmış bir seed (seed=9678).
torch.manual_seed(9678)
Wq2, Wk2, Wv2 = torch.randn(D_BAS, D_BAS) * 0.5, torch.randn(D_BAS, D_BAS) * 0.5, torch.randn(D_BAS, D_BAS) * 0.5

# Gerçek Transformer'larda tek bir Wq (D×D) kullanılır; biz burada öğretici amaçlı
# blok-köşegen (block-diagonal) bir Wq inşa ediyoruz -- bu, "her başlık kendi
# alt-uzayını görsün" fikrini açıkça gösteriyor (gerçek modellerde bu uzmanlaşma
# eğitimle, dolaylı olarak ortaya çıkar).
def blok_kosegen(A, B):
    ust = torch.cat([A, torch.zeros(D_BAS, D_BAS)], dim=1)
    alt = torch.cat([torch.zeros(D_BAS, D_BAS), B], dim=1)
    return torch.cat([ust, alt], dim=0)

Wq_tam = blok_kosegen(Wq1, Wq2)
Wk_tam = blok_kosegen(Wk1, Wk2)
Wv_tam = blok_kosegen(Wv1, Wv2)
print(f"Wq_tam şekli: {tuple(Wq_tam.shape)} -- {H} başlık x {D_BAS} boyut = {D_TOPLAM} toplam boyut.")
Wq_tam şekli: (8, 8) -- 2 başlık x 4 boyut = 8 toplam boyut.Gömme, tüm başlıkları besliyor
# İki ilişkiyi de barındıran 8 boyutlu gömme: ilk 4 boyut 10. dersteki coreference
# eksenleri, son 4 boyut yeni bir eylem-konum ekseni.
X = torch.tensor([
    [1.5, 0.0, 0.0, 0.0,   0.0, 0.0, 0.0, 0.0],   # Kedi
    [0.0, 1.5, 0.0, 0.0,   1.4, 0.0, 0.0, 0.0],   # masaya
    [0.3, 0.3, 1.2, 0.0,   1.3, 0.2, 0.0, 0.0],   # çıktı
    [0.0, 0.0, 0.0, 1.0,   0.0, 0.0, 0.0, 0.8],   # çünkü
    [1.3, 0.0, 0.0, 0.1,   0.0, 0.0, 0.0, 0.0],   # o
    [0.2, 0.0, 0.9, 0.1,   0.0, 0.0, 1.0, 0.1],   # yorulmuştu
])
Q = X @ Wq_tam
K = X @ Wk_tam
V = X @ Wv_tam
print(f"\nX şekli: {tuple(X.shape)} -> Q, K, V şekli (üçü de): {tuple(Q.shape)}")
X şekli: (6, 8) -> Q, K, V şekli (üçü de): (6, 8)Her başlığı ayrı ayrı çalıştır, sonra birleştir
# Q, K, V'yi (N, H, D_BAS) şeklinde yeniden şekillendir, her başlığı ayrı ayrı çalıştır.
N = X.shape[0]
Q_bas = Q.view(N, H, D_BAS).transpose(0, 1)  # (H, N, D_BAS)
K_bas = K.view(N, H, D_BAS).transpose(0, 1)
V_bas = V.view(N, H, D_BAS).transpose(0, 1)

baslik_ciktilari = []
baslik_agirliklari = []
for h in range(H):
    cikti_h, agirlik_h = dikkat(Q_bas[h], K_bas[h], V_bas[h])
    baslik_ciktilari.append(cikti_h)
    baslik_agirliklari.append(agirlik_h)

ciktI_idx, o_idx = TOKENLER.index("çıktı"), TOKENLER.index("o")
print("\nBaşlık 1 (coreference alt-uzayı) -- 'o' satırı:")
for tok, a in zip(TOKENLER, baslik_agirliklari[0][o_idx].tolist()):
    print(f"  {tok:<12} ağırlık={a:.3f}")
print("\nBaşlık 2 (eylem-konum alt-uzayı) -- 'çıktı' satırı:")
for tok, a in zip(TOKENLER, baslik_agirliklari[1][ciktI_idx].tolist()):
    print(f"  {tok:<12} ağırlık={a:.3f}")

en_yuksek_1 = TOKENLER[baslik_agirliklari[0][o_idx].argmax().item()]
en_yuksek_2 = TOKENLER[baslik_agirliklari[1][ciktI_idx].argmax().item()]
print(f"\nBaşlık 1: 'o' en çok '{en_yuksek_1}'e bakıyor. Başlık 2: 'çıktı' en çok '{en_yuksek_2}'ya bakıyor.")
print("Aynı cümle, aynı anda, iki farklı ilişki türü -- her başlık kendi 'uzmanlığında'.")

# Başlıkları birleştir (concat) -- bu, çok-başlıklı attention'ın çıktısı.
coklu_baslik_cikti = torch.cat(baslik_ciktilari, dim=-1)
print(f"\nBirleştirilmiş çıktı şekli: {tuple(coklu_baslik_cikti.shape)} (= {H} x {D_BAS})")
Başlık 1 (coreference alt-uzayı) -- 'o' satırı:
  Kedi         ağırlık=0.517
  masaya       ağırlık=0.018
  çıktı        ağırlık=0.042
  çünkü        ağırlık=0.034
  o            ağırlık=0.353
  yorulmuştu   ağırlık=0.035

Başlık 2 (eylem-konum alt-uzayı) -- 'çıktı' satırı:
  Kedi         ağırlık=0.067
  masaya       ağırlık=0.437
  çıktı        ağırlık=0.290
  çünkü        ağırlık=0.076
  o            ağırlık=0.067
  yorulmuştu   ağırlık=0.064

Başlık 1: 'o' en çok 'Kedi'e bakıyor. Başlık 2: 'çıktı' en çok 'masaya'ya bakıyor.
Aynı cümle, aynı anda, iki farklı ilişki türü -- her başlık kendi 'uzmanlığında'.

Birleştirilmiş çıktı şekli: (6, 8) (= 2 x 4)
Başlık 1, “o”nun “Kedi”ye baktığını (0.517) buluyor; Başlık 2, “çıktı”nın “masaya”ya baktığını (0.437) buluyor — aynı cümle, aynı anda, iki farklı ilişki.
Matematik
Multi-head attention
| Sembol | Anlamı |
|---|---|
| Başlık (head) sayısı | |
| . başlığa özel projeksiyon matrisleri | |
| Tüm başlıkların çıktısını yan yana birleştirme | |
| Birleştirilmiş çıktıyı tekrar boyuta projekte eden öğrenilen matris |
Burada öğretici amaçlı ‘yu blok-köşegen inşa ettik (her başlık sadece kendi boyut dilimini görüyor); gerçek modellerde ‘ler birbirinden bağımsız öğrenilir ve ile çıktılar yeniden karıştırılır.
Kod
Blok-köşegen matrisle “tek seferde” hesaplamak, her başlığı ayrı ayrı hesaplamakla gerçekten aynı mı? Sayısal olarak doğrulayalım (11. dersteki doğrulama alışkanlığıyla aynı):
İki hesaplama yöntemi birebir eşleşiyor mu?
# Blok-köşegen tam matrislerle (X @ Wq_tam, ardından reshape) hesaplamak ile,
# her başlığı kendi 4 boyutluk diliminde ayrı ayrı hesaplamak aynı sonucu vermeli mi?
Q1_ayri, K1_ayri, V1_ayri = X[:, :4] @ Wq1, X[:, :4] @ Wk1, X[:, :4] @ Wv1
Q2_ayri, K2_ayri, V2_ayri = X[:, 4:] @ Wq2, X[:, 4:] @ Wk2, X[:, 4:] @ Wv2
cikti1_ayri, _ = dikkat(Q1_ayri, K1_ayri, V1_ayri)
cikti2_ayri, _ = dikkat(Q2_ayri, K2_ayri, V2_ayri)
cikti_ayri_birlesik = torch.cat([cikti1_ayri, cikti2_ayri], dim=-1)

fark = (coklu_baslik_cikti - cikti_ayri_birlesik).abs().max().item()
print(f"\nBlok-köşegen tam matrisle vs ayrı ayrı hesaplanan başlıklar arasındaki fark: {fark:.2e}")
print(f"torch.allclose: {torch.allclose(coklu_baslik_cikti, cikti_ayri_birlesik, atol=1e-6)}")
print("Bu, 'blok-köşegen Wq = her başlığı kendi alt-uzayında çalıştırmakla aynı' iddiasını doğruluyor.")
Blok-köşegen tam matrisle vs ayrı ayrı hesaplanan başlıklar arasındaki fark: 0.00e+00
torch.allclose: True
Bu, 'blok-köşegen Wq = her başlığı kendi alt-uzayında çalıştırmakla aynı' iddiasını doğruluyor.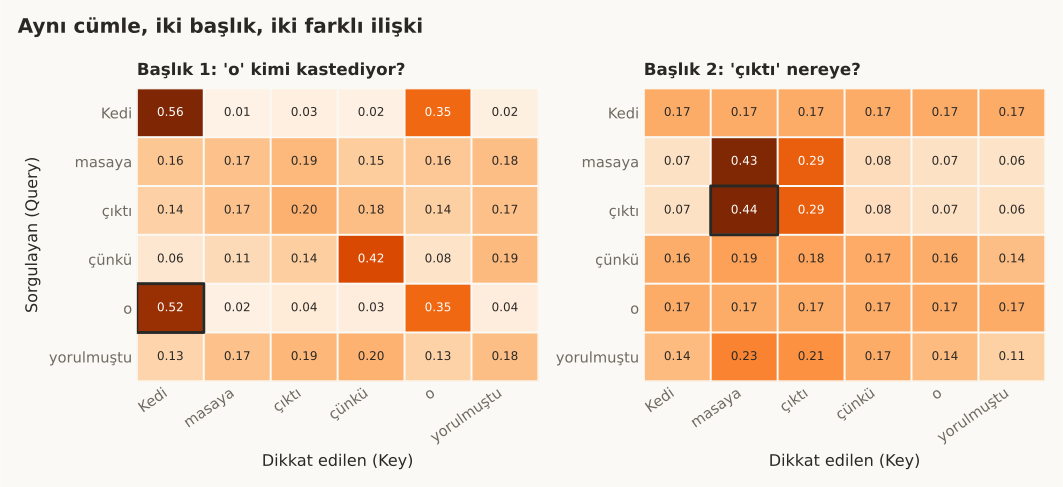 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Multi-head attention, bugünün tüm büyük modellerinin (GPT: 96 başlık, BERT: 12-16 başlık) standart bileşeni:
- Gerçek modellerde başlık sayısı 8-96 arasında değişir — her biri bağımsız öğrenilir, hangi ilişkiyi öğreneceğine kimse karar vermez, eğitim verisi belirler.
- Araştırmacılar eğitilmiş modellerin başlıklarını incelediğinde, bazılarının dilbilgisi ilişkilerini (özne-yüklem), bazılarının konumsal ilişkileri, bazılarının da bizim örneğimizdeki gibi coreference’ı öğrendiğini gözlemlemiştir — ama bu her zaman bu kadar temiz ayrışmaz.
- Başlık boyutu () küçüldükçe, her başlığın “görüş alanı” da küçülür — bu yüzden başlık sayısı ile model boyutu birlikte ölçeklenir.
Bu 2 hatayı yaparsın:
- “Daha fazla başlık = her zaman daha iyi” sanmak — başlık sayısı arttıkça her başlığın boyutu () küçülür, bu da bir denge gerektirir.
- Başlıkların önceden belirlenmiş, insan tarafından tasarlanmış ilişkiler öğrendiğini sanmak — bizim örneğimiz öğretici amaçlı elle tasarlandı; gerçek modellerde uzmanlaşma eğitimle, kendiliğinden ortaya çıkar.
Kendini test et
1. 10. dersteki tek başlıklı self-attention, 'çıktı' kelimesinin 'masaya' ile ilişkisini neden yakalayamadı?
- Kod hatalıydı
- O başlığın boyutları (embedding eksenleri) sadece coreference (o -> Kedi) ilişkisini yakalayacak şekilde tasarlanmıştı -- eylem-konum ilişkisi için gerekli sinyal o alt-uzayda yoktu (doğru cevap)
- 'çıktı' kelimesi çok nadir kullanıldığı için
- Attention mekanizması sadece zamirler için çalışır
Neden: tek-baslik-sinirlamasi bloğunda 'çıktı' satırının ağırlıkları neredeyse düz (0.136-0.204) -- bu, o alt-uzayın eylem-konum ilişkisini ayırt edecek bir sinyal taşımadığını gösteriyor.
2. Multi-head attention'da 'Concat(head_1, ..., head_h)W_O' formülündeki W_O ne işe yarar?
- Hiçbir işe yaramaz, isteğe bağlıdır
- Başlıkların birleştirilmiş (concat) çıktısını tekrar d boyuta projekte eder ve başlıklar arasındaki bilgiyi yeniden karıştırır -- bu da öğrenilen bir matristir (doğru cevap)
- Sadece hesaplama hızını artırır
- Q, K, V'yi hesaplamak için kullanılır
Neden: MathBox'taki formülde MultiHead(X) = Concat(...)W_O -- concat sonrası boyut h×d_k = d_model'dir, W_O bu birleşik temsili işler ve başlıklar arası bilgiyi karıştırır.
3. Notebook'taki 'blok-köşegen Wq ile tek seferde hesaplama' ile 'her başlığı ayrı ayrı hesaplama' arasındaki fark 0.00e+00 çıktı. Bu neyi kanıtlıyor?
- Hiçbir şeyi, tesadüf
- Blok-köşegen bir ağırlık matrisiyle tek seferde hesaplamanın, her başlığı kendi boyut diliminde bağımsız hesaplamakla matematiksel olarak tam olarak aynı olduğunu -- çünkü blok-köşegen yapı, boyutlar arasında sızıntı olmamasını garanti eder (doğru cevap)
- Multi-head attention gereksizdir
- Tek başlık her zaman yeterlidir
Neden: dogrulama bloğunda fark tam olarak 0.00e+00 -- kayan nokta yuvarlaması bile yok, çünkü blok-köşegen matrisin sıfır blokları, başlıklar arasında hiçbir çapraz terim üretmiyor.
Özet
Özet
- Tek bir dikkat başlığı, tek bir ilişki türünü yakalamaya yeter -- bir cümlede genelde birden fazla ilişki türü vardır.
- Multi-head attention, D boyutunu h başlığa böler; her başlık kendi alt-uzayında bağımsız bir Q/K/V projeksiyonuyla çalışır.
- Başlıkların çıktıları birleştirilir (concat) ve öğrenilen bir W_O matrisiyle tekrar d_model boyuta projekte edilir.
- Notebook'ta bir başlık coreference'ı (o→Kedi), diğeri eylem-konum ilişkisini (çıktı→masaya) aynı anda yakaladı.
- Gerçek modellerde bu uzmanlaşma insan tarafından tasarlanmaz -- eğitimle kendiliğinden ortaya çıkar.