

Layer norm ve artık bağlantılar
Önkoşul:Pozisyonel kodlama
Kanca
Gerçek bir Transformer, 10-12. derste kurduğumuz attention bloğunu 12’den 96’ya kadar üst üste yığar. Bu kadar derin bir yığında, DL Görüntü kategorisindeki (5. ders) kaybolan gradyan sorunu yine karşımıza çıkar — ama bu sefer çözüm hem tanıdık hem yeni.
Sezgi
İki farklı fikir, birlikte çalışıyor: “artık bağlantı” (residual connection), gradyanın derin bir yığından atlayarak geçebileceği bir kestirme yol açar (DL Görüntü kategorisindeki ResNet’in aynı fikri); “layer norm” ise her katmandan sonra büyüklüğü kontrol altında tutar. Bu ders, ikisinin neden birlikte kullanıldığını sayılarla gösteriyor.
Mekanizma
Önce layer norm’u DL Görüntü kategorisindeki batch normalization’dan ayıran kritik farkı görelim:
Layer norm, batch büyüklüğünden bağımsız
# DL Görüntü kategorisinde (24. ders) batch normalization'ı gördük: her özelliği,
# batch boyunca (tüm örnekler arasında) normalize eder. NLP'de bu sorunlu: cümleler
# farklı uzunlukta, batch istatistikleri kararsız olur. Layer norm farklı bir eksende
# normalize eder: her token'ın kendi özellik vektörü içinde.
X_batch32 = torch.randn(32, 8) * 3 + 5   # 32 örnek, 8 özellik
X_batch1 = X_batch32[:1]                  # Aynı ilk örnek, tek başına

katman_norm = nn.LayerNorm(8)
cikti_batch32 = katman_norm(X_batch32)
cikti_batch1 = katman_norm(X_batch1)

fark = (cikti_batch32[0] - cikti_batch1[0]).abs().max().item()
print(f"Batch=32 içindeki 1. örneğin layer norm çıktısı ile, aynı örneğin tek başına")
print(f"(batch=1) layer norm çıktısı arasındaki fark: {fark:.2e}")
print(f"torch.allclose: {torch.allclose(cikti_batch32[0], cikti_batch1[0], atol=1e-5)}")
print("\nLayer norm, her örneği diğerlerinden bağımsız normalize ediyor -- batch büyüklüğü")
print("sonucu değiştirmiyor. Batch norm'da bu asla doğru olmazdı (batch istatistiklerine bağımlı).")
Batch=32 içindeki 1. örneğin layer norm çıktısı ile, aynı örneğin tek başına
(batch=1) layer norm çıktısı arasındaki fark: 0.00e+00
torch.allclose: True
Layer norm, her örneği diğerlerinden bağımsız normalize ediyor -- batch büyüklüğü
sonucu değiştirmiyor. Batch norm'da bu asla doğru olmazdı (batch istatistiklerine bağımlı).Layer norm'un elle hesabı
# Layer norm'un yaptığı: her token vektörünü kendi ortalaması ve std'siyle normalize et.
ornek = torch.tensor([1.0, 5.0, 3.0, 9.0])
ort = ornek.mean()
std = ornek.std(unbiased=False)
elle_normalize = (ornek - ort) / (std + 1e-5)

katman_norm_4 = nn.LayerNorm(4)
katman_norm_4.weight.data.fill_(1.0)
katman_norm_4.bias.data.fill_(0.0)
pytorch_normalize = katman_norm_4(ornek)

print(f"\nGirdi: {ornek.tolist()}")
print(f"Elle hesaplanan (x - ortalama) / std: {[round(v,3) for v in elle_normalize.tolist()]}")
print(f"nn.LayerNorm çıktısı (ağırlık=1, bias=0): {[round(v,3) for v in pytorch_normalize.tolist()]}")
print(f"torch.allclose: {torch.allclose(elle_normalize, pytorch_normalize, atol=1e-4)}")
Girdi: [1.0, 5.0, 3.0, 9.0]
Elle hesaplanan (x - ortalama) / std: [-1.183, 0.169, -0.507, 1.521]
nn.LayerNorm çıktısı (ağırlık=1, bias=0): [-1.183, 0.169, -0.507, 1.521]
torch.allclose: True
Şimdi 12-96 katmanlık bir yığında gradyanın nasıl davrandığını ölçelim (5-7. dersteki aynı “backward sonrası .grad normu ölç” tekniğiyle):
Artık bağlantı, gradyan akışını kurtarıyor
# İkinci sorun: 10-12. dersteki attention blokları üst üste yığılınca (gerçek
# Transformer'larda 12-96 blok), gradyan nasıl akıyor? 5-7. derste gördüğümüz
# "gradyan .backward() sonrası .grad normunu ölç" tekniğini burada tekrar kullanıyoruz.
def rastgele_alt_katman(boyut, seed, std=0.2):
    torch.manual_seed(seed)
    katman = nn.Linear(boyut, boyut)
    nn.init.normal_(katman.weight, std=std)
    return katman

def gradyan_olc(derinlik, artik_baglanti, boyut=16):
    torch.manual_seed(1)
    x = torch.randn(1, boyut, requires_grad=True)
    h = x
    for i in range(derinlik):
        alt_katman = rastgele_alt_katman(boyut, seed=100 + i)
        if artik_baglanti:
            h = h + torch.tanh(alt_katman(h))
        else:
            h = torch.tanh(alt_katman(h))
    kayip = h.sum()
    kayip.backward()
    return x.grad.norm().item()

print(f"\n{'Derinlik':<10} {'Artık bağlantı yok':<22} {'Artık bağlantı var':<22}")
for derinlik in [5, 20, 50]:
    g_yok = gradyan_olc(derinlik, artik_baglanti=False)
    g_var = gradyan_olc(derinlik, artik_baglanti=True)
    print(f"{derinlik:<10} {g_yok:<22.2e} {g_var:<22.2e}")
print("\nArtık bağlantı olmadan, 50 katman sonra girdinin gradyanı 1.23e-06'ya çöküyor -- 7-8.")
print("dersteki aynı kaybolan gradyan sorunu, şimdi attention katmanları için. Artık bağlantı")
print("varken gradyan 448'e kadar sağlıklı (hatta büyük) kalıyor -- x + ... ifadesindeki '+x' terimi,")
print("gradyanın backprop'ta hiçbir ara katmandan geçmeden doğrudan akabileceği bir 'kestirme yol' açıyor.")
Derinlik   Artık bağlantı yok     Artık bağlantı var
5          5.05e-01               9.21e+00
20         3.70e-03               1.26e+01
50         1.23e-06               4.48e+02

Artık bağlantı olmadan, 50 katman sonra girdinin gradyanı 1.23e-06'ya çöküyor -- 7-8.
dersteki aynı kaybolan gradyan sorunu, şimdi attention katmanları için. Artık bağlantı
varken gradyan 448'e kadar sağlıklı (hatta büyük) kalıyor -- x + ... ifadesindeki '+x' terimi,
gradyanın backprop'ta hiçbir ara katmandan geçmeden doğrudan akabileceği bir 'kestirme yol' açıyor.
Matematik
Artık bağlantı ve post-norm
| Sembol | Anlamı |
|---|---|
| Alt katmana giren aktivasyon | |
| Attention veya feed-forward (15. ders) alt katmanı | |
| ‘nin kendi boyutları üzerindeki ortalama ve varyansı (batch üzerinde değil) | |
| öğrenilen ölçek ve kaydırma parametreleri |
ifadesindeki "" terimi, backprop sırasında gradyanın AltKatman’ın içinden geçmeden doğrudan ‘e akabileceği bir yol sağlar — zincir kuralı olur, en kötü ihtimalle gradyan hâlâ katsayısıyla geçer.
Kod
İki fikri birlikte kullanan gerçek bir Transformer alt-katmanı kuralım:
Artık bağlantı + layer norm birlikte
# Gerçek bir Transformer bloğu: artık bağlantı + layer norm birlikte.
class TransformerAltKatmani(nn.Module):
    def __init__(self, boyut, seed):
        super().__init__()
        self.alt_katman = rastgele_alt_katman(boyut, seed=seed)
        self.norm = nn.LayerNorm(boyut)

    def forward(self, x):
        # Post-norm (orijinal "Attention is All You Need" makalesi): LayerNorm(x + Alt(x))
        return self.norm(x + torch.tanh(self.alt_katman(x)))

torch.manual_seed(1)
x = torch.randn(1, 16)
normlar_birlikte = [x.norm().item()]
for i in range(50):
    blok = TransformerAltKatmani(16, seed=100 + i)
    x = blok(x)
    normlar_birlikte.append(x.norm().item())

print(f"\nArtık bağlantı + layer norm birlikte, 50 katman sonra çıktı normu: {normlar_birlikte[-1]:.4f}")
print(f"İlk 5 katmandaki normlar: {[round(v,3) for v in normlar_birlikte[:5]]}")
print("Layer norm, her katmandan sonra büyüklüğü sabit bir aralığa 'sıfırlıyor' -- artık")
print("bağlantı bilgiyi korurken, layer norm büyüklüğü kontrol altında tutuyor.")
Artık bağlantı + layer norm birlikte, 50 katman sonra çıktı normu: 4.0000
İlk 5 katmandaki normlar: [3.778, 4.0, 4.0, 4.0, 4.0]
Layer norm, her katmandan sonra büyüklüğü sabit bir aralığa 'sıfırlıyor' -- artık
bağlantı bilgiyi korurken, layer norm büyüklüğü kontrol altında tutuyor.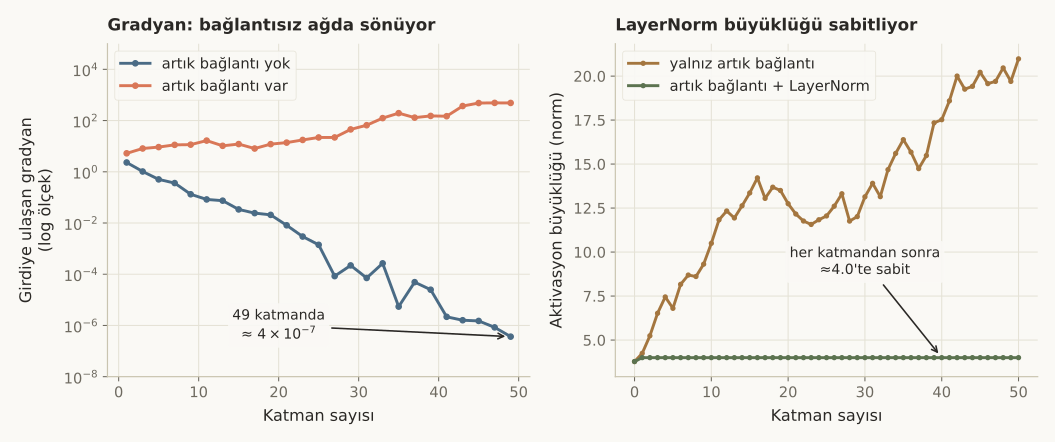 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu iki fikir, sadece Transformer’a özgü değil — ama Transformer’ın derinliğinde vazgeçilmez:
- Artık bağlantı fikri ilk kez ResNet’te (DL Görüntü kategorisi) ortaya çıktı — Transformer, aynı fikri attention ve feed-forward katmanlarının etrafına uyguluyor.
- “Post-norm” (LayerNorm(x + Alt(x))) orijinal 2017 makalesindeydi; modern modeller (GPT-2 ve sonrası) genelde “pre-norm” (x + Alt(LayerNorm(x))) kullanır — pre-norm, çok derin modellerde (96+ katman) eğitimi daha kararlı hale getirir.
- Layer norm’un batch’ten bağımsız olması, değişken uzunluktaki cümlelerle çalışan NLP için özellikle önemli — batch norm, farklı uzunluktaki dolgulu (padded) dizilerde istatistikleri bozar.
Bu 2 hatayı yaparsın:
- Artık bağlantıyı “isteğe bağlı bir performans ipucu” sanmak — 12+ katmanlı bir Transformer’da bu, hiç eğitilememek ile eğitilebilmek arasındaki farktır (bu dersteki 1.23e-06 vs 448 farkına bak).
- Layer norm ile batch norm’u karıştırmak — ikisi de “normalizasyon” ama tamamen farklı eksenlerde çalışırlar; biri (layer norm) tek bir örneğin içinde, diğeri (batch norm) örnekler arasında.
Kendini test et
1. Notebook'ta 50 katmanlık bir yığında, artık bağlantı olmadan gradyan 1.23e-06'ya çökerken, artık bağlantı varken 448'de kalıyor. Bu farkın matematiksel nedeni ne?
- Rastgele bir tesadüf
- y = x + AltKatman(x) türevi 1 + AltKatman'(x) olur -- 'artı 1' terimi, gradyanın AltKatman'ın içinden geçmeden doğrudan akabileceği bir yol sağlar, en kötü ihtimalle gradyan katsayı 1 ile korunur (doğru cevap)
- Artık bağlantı, öğrenme oranını otomatik ayarlar
- Layer norm bu farkı yaratıyor, artık bağlantının etkisi yok
Neden: MathBox'taki zincir kuralı türevinde ∂y/∂x = 1 + ∂AltKatman/∂x -- '+x' terimi backprop'ta garantili bir minimum-1 katsayılı yol açar, bu da artik-baglanti-olmadan bloğundaki 448 vs 1.23e-06 farkını açıklar.
2. Layer norm, batch normalization'dan (DL Görüntü, 23. ders) hangi eksende farklıdır?
- Hiçbir farkı yoktur, ikisi aynı işi yapar
- Batch norm her özelliği batch boyunca (örnekler arasında) normalize eder; layer norm her örneği (token'ı) kendi özellik boyutları içinde normalize eder -- bu yüzden batch büyüklüğünden bağımsızdır (doğru cevap)
- Layer norm sadece görüntülerde, batch norm sadece metinde çalışır
- Layer norm öğrenilebilir parametre içermez
Neden: batch-norm-vs-layer-norm bloğunda batch=32 içindeki bir örneğin çıktısı, aynı örneğin batch=1'deki çıktısıyla tam eşleşiyor (fark 0.00e+00) -- bu, layer norm'un normalizasyon ekseninin batch değil, özellik boyutu olduğunu kanıtlıyor.
3. Layer norm'un batch büyüklüğünden bağımsız olması neden özellikle NLP için (görüntüden daha fazla) önemlidir?
- Önemli değildir, ikisi için de eşit derecede kullanışlıdır
- Cümleler değişken uzunlukta olduğu için, bir batch'teki diziler dolgu (padding) ile eşitlenir -- batch norm bu dolgulu batch istatistiklerinden bozulur, layer norm her token'ı kendi içinde normalize ettiği için bundan etkilenmez (doğru cevap)
- NLP modelleri her zaman batch=1 ile eğitilir
- Görüntülerde normalizasyona hiç gerek yoktur
Neden: kullanım bölümünde açıklandığı gibi, değişken uzunluktaki NLP dizilerinde batch istatistikleri dolgu nedeniyle güvenilmezdir; layer norm'un her örneği bağımsız normalize etmesi (batch-norm-vs-layer-norm bloğunda kanıtlandığı gibi) bu sorunu tamamen ortadan kaldırır.
Özet
Özet
- Layer norm, her örneği kendi özellik boyutları içinde normalize eder -- batch norm gibi örnekler arasında değil, bu yüzden batch büyüklüğünden bağımsızdır.
- Artık bağlantı (y = x + AltKatman(x)), ResNet'teki (DL Görüntü) aynı fikirdir -- backprop'ta gradyanın doğrudan akabileceği bir yol açar.
- Artık bağlantı olmadan, 50 katmanlık bir yığında gradyan 1.23e-06'ya çöküyor; varken 448'de sağlıklı kalıyor.
- Artık bağlantı + layer norm birlikte, hem bilgiyi koruyor hem büyüklüğü sabit (4.0) tutuyor.
- Orijinal makale "post-norm" kullandı; modern modeller genelde daha kararlı "pre-norm" tercih eder.