

Encoder-decoder yapısı
Önkoşul:Position-wise feed-forward ağ
Kanca
Şimdiye kadar tek bir cümle üzerinde çalıştık. Ama çeviri gibi görevlerde iki cümle var: kaynak (“Kedi masaya çıktı”) ve hedef (“The cat climbed…”). Model, hedefi üretirken kaynağa nasıl “bakıyor”?
Sezgi
Orijinal “Attention is All You Need” mimarisi iki parçadan oluşur: encoder (kaynağı okur) ve decoder (hedefi üretir). Decoder’ın yeni bir silahı var: “çapraz dikkat” (cross-attention) — sorgu kendisinden, ama anahtar/değer encoder’dan gelir. Böylece decoder, her kelimeyi üretirken kaynak cümlenin ilgili kısmına “bakabilir”.
Mekanizma
İki dizi: kaynak ve hedef
# 10-15. derste tek bir dizi (cümle) üzerinde çalıştık. Ama çeviri gibi görevlerde
# iki dizi var: kaynak (encoder'a girer) ve hedef (decoder üretir). Örnek: Türkçe'den
# İngilizce'ye çeviri.
KAYNAK = ["Kedi", "masaya", "çıktı"]       # Türkçe (encoder girdisi)
HEDEF_SIMDIYE_KADAR = ["The", "cat"]        # İngilizce, şu ana kadar üretilen (decoder girdisi)
print(f"Kaynak dizi (Türkçe, encoder): {KAYNAK}")
print(f"Hedef dizi (İngilizce, decoder, şimdiye kadar üretilen): {HEDEF_SIMDIYE_KADAR}")
print("\nEncoder, kaynak diziyi tamamen görebilir (bidirectional -- 10. dersteki self-attention gibi).")
print("Decoder ise hedef dizide sadece kendinden öncekileri görebilir (11. dersteki nedensel maske).")
Kaynak dizi (Türkçe, encoder): ['Kedi', 'masaya', 'çıktı']
Hedef dizi (İngilizce, decoder, şimdiye kadar üretilen): ['The', 'cat']
Encoder, kaynak diziyi tamamen görebilir (bidirectional -- 10. dersteki self-attention gibi).
Decoder ise hedef dizide sadece kendinden öncekileri görebilir (11. dersteki nedensel maske).Önce encoder’ı çalıştıralım — 10. dersteki aynı self-attention, ama bu sefer kaynak cümle üzerinde:
Encoder: kaynağı oku
# Encoder: kaynak dizi üzerinde sıradan self-attention (maskesiz, tüm kaynak
# kelimeleri birbirini görebilir).
D = 4
X_kaynak = torch.tensor([
    [1.5, 0.0, 0.0, 0.0],   # Kedi
    [0.0, 1.5, 0.0, 0.0],   # masaya
    [0.3, 0.3, 1.2, 0.0],   # çıktı
])

torch.manual_seed(125)
Wq_enc, Wk_enc, Wv_enc = torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5
Q_enc, K_enc, V_enc = X_kaynak @ Wq_enc, X_kaynak @ Wk_enc, X_kaynak @ Wv_enc
encoder_ciktisi, _ = dikkat(Q_enc, K_enc, V_enc)
print(f"\nEncoder çıktısı şekli: {tuple(encoder_ciktisi.shape)} (= {len(KAYNAK)} kaynak token x {D} boyut)")
print("Bu çıktı, her kaynak kelimenin, diğer tüm kaynak kelimelerle 'zenginleştirilmiş' temsilidir --")
print("decoder, üretim boyunca bunu kullanacak.")
Encoder çıktısı şekli: (3, 4) (= 3 kaynak token x 4 boyut)
Bu çıktı, her kaynak kelimenin, diğer tüm kaynak kelimelerle 'zenginleştirilmiş' temsilidir --
decoder, üretim boyunca bunu kullanacak.
Şimdi yeni mekanizma: çapraz dikkat. Decoder’ın sorgusu, encoder’ın çıktısındaki anahtar/değerlerle eşleşiyor:
Çapraz dikkat: decoder, encoder'a bakar
# Decoder'ın ikinci (ve yeni) dikkat türü: "çapraz dikkat" (cross-attention).
# Sorgu (Q) decoder'dan gelir, ama Anahtar/Değer (K, V) encoder çıktısından gelir --
# yani decoder, kaynak cümleye 'bakar'.
X_hedef = torch.tensor([
    [0.1, 0.1, 0.1, 1.0],   # "The" -- genel bir kelime, belirli bir kaynağa odaklanmaz
    [1.4, 0.0, 0.0, 0.1],   # "cat" -- 'Kedi'ye yakın tasarlandı
])

torch.manual_seed(10146)
Wq_dec, Wk_capraz = torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5

Q_dec = X_hedef @ Wq_dec          # sorgu: decoder'dan
K_capraz = encoder_ciktisi @ Wk_capraz   # anahtar: encoder çıktısından (V_capraz = encoder_ciktisi)
capraz_ciktisi, capraz_agirliklar = dikkat(Q_dec, K_capraz, encoder_ciktisi)

print(f"\nÇapraz dikkat matrisi şekli: {tuple(capraz_agirliklar.shape)} (= {len(HEDEF_SIMDIYE_KADAR)} hedef x {len(KAYNAK)} kaynak)")
print("Dikkat: bu matris kare değil -- 10. dersteki self-attention'ın N×N matrisinden farklı,")
print("çünkü sorgu ve anahtar/değer iki farklı diziden geliyor.")
for hedef_kelime, agirlik_satiri in zip(HEDEF_SIMDIYE_KADAR, capraz_agirliklar.tolist()):
    print(f"\n  '{hedef_kelime}' hangi kaynak kelimelere bakıyor?")
    for kaynak_kelime, a in zip(KAYNAK, agirlik_satiri):
        print(f"    {kaynak_kelime:<10} ağırlık={a:.3f}")

en_yuksek = KAYNAK[capraz_agirliklar[1].argmax().item()]
print(f"\n'cat' üretilirken, en çok '{en_yuksek}' kaynak kelimesine bakılıyor ({capraz_agirliklar[1].max().item():.3f}) --")
print("model, 'cat' kelimesinin karşılığının kaynak cümlede 'Kedi' olduğunu, öğrenilmiş dikkat ile buluyor.")
Çapraz dikkat matrisi şekli: (2, 3) (= 2 hedef x 3 kaynak)
Dikkat: bu matris kare değil -- 10. dersteki self-attention'ın N×N matrisinden farklı,
çünkü sorgu ve anahtar/değer iki farklı diziden geliyor.

  'The' hangi kaynak kelimelere bakıyor?
    Kedi       ağırlık=0.476
    masaya     ağırlık=0.240
    çıktı      ağırlık=0.284

  'cat' hangi kaynak kelimelere bakıyor?
    Kedi       ağırlık=0.658
    masaya     ağırlık=0.138
    çıktı      ağırlık=0.204

'cat' üretilirken, en çok 'Kedi' kaynak kelimesine bakılıyor (0.658) --
model, 'cat' kelimesinin karşılığının kaynak cümlede 'Kedi' olduğunu, öğrenilmiş dikkat ile buluyor.
“cat” üretilirken model, kaynak cümledeki “Kedi”ye 0.658 ağırlıkla bakıyor — çeviri karşılığını, hiçbir sözlük olmadan, öğrenilmiş dikkat ile buluyor.
Matematik
Üç dikkat türü, aynı formül
| Dikkat türü | nereden | nereden |
|---|---|---|
| Encoder self-attention | encoder | encoder |
| Decoder maskeli self-attention | decoder | decoder |
| Decoder çapraz dikkat | decoder | encoder |
Formül hiç değişmiyor — 9-11. derste kurduğumuz aynı dikkat() fonksiyonu. Değişen tek şey, , , ‘nin hangi diziden geldiği. Çapraz dikkatte ve farklı dizilerden geldiği için, dikkat matrisi kare olmak zorunda değildir.
Kod
Üç dikkat türünün karşılaştırması
# Özet karşılaştırma: encoder'daki self-attention, decoder'daki maskeli self-attention,
# ve decoder'daki çapraz dikkat -- üçü de aynı dikkat() fonksiyonunu kullanıyor, ama
# Q/K/V'nin nereden geldiği değişiyor.
print(f"\n{'Dikkat türü':<28} {'Q nereden':<14} {'K, V nereden':<16} {'Matris şekli':<12}")
print(f"{'Encoder self-attention':<28} {'encoder':<14} {'encoder':<16} {'(3, 3)':<12}")
print(f"{'Decoder maskeli self-att.':<28} {'decoder':<14} {'decoder':<16} {'(2, 2)':<12}")
print(f"{'Decoder çapraz dikkat':<28} {'decoder':<14} {'Encoder':<16} {'(2, 3)':<12}")
print("\nAynı matematik (dikkat fonksiyonu), üç farklı 'nereden geliyor' kombinasyonu --")
print("bu üçü birlikte, bir Transformer encoder-decoder bloğunu oluşturuyor.")
Dikkat türü Q nereden K, V nereden Matris şekli
Encoder self-attention encoder encoder (3, 3)
Decoder maskeli self-att. decoder decoder (2, 2)
Decoder çapraz dikkat decoder Encoder (2, 3)
Aynı matematik (dikkat fonksiyonu), üç farklı 'nereden geliyor' kombinasyonu --
bu üçü birlikte, bir Transformer encoder-decoder bloğunu oluşturuyor.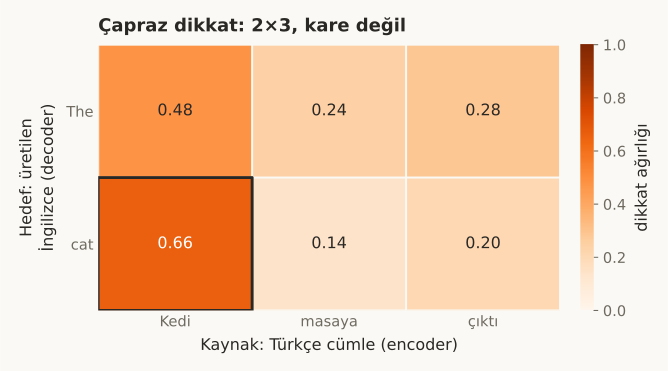 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Encoder-decoder yapısı, orijinal 2017 Transformer’ının tam mimarisi — ama tek kullanım şekli değil:
- Makine çevirisi, özetleme, soru-cevaplama gibi “bir diziyi başka bir diziye dönüştürme” görevleri encoder-decoder kullanır — kaynak ve hedef farklı uzunlukta, farklı dillerde/formatlarda olabilir.
- GPT gibi modeller sadece decoder kullanır (18. ders) — çapraz dikkat yoktur, sadece maskeli self-attention; BERT gibi modeller sadece encoder kullanır (maskesiz self-attention, çeviri üretmez, temsil üretir).
- Decoder’ın her bloğunda üç alt-katman sırayla çalışır: maskeli self-attention → çapraz dikkat → FFN (14-15. ders) — her birinin etrafında artık bağlantı + layer norm var.
Bu 2 hatayı yaparsın:
- Çapraz dikkatin de self-attention gibi kare bir matris ürettiğini sanmak — hayır, hedef ve kaynak uzunlukları farklı olabilir, matris dikdörtgen olabilir.
- Her Transformer modelinin encoder ve decoder içerdiğini düşünmek — GPT sadece decoder, BERT sadece encoder kullanır (18. ders bu farkı detaylandıracak).
Kendini test et
1. Çapraz dikkatin (cross-attention) self-attention'dan temel farkı nedir?
- Farklı bir matematiksel formül kullanır
- Sorgu (Q) bir diziden (decoder), anahtar/değer (K, V) başka bir diziden (encoder çıktısı) gelir -- self-attention'da üçü de aynı diziden gelir (doğru cevap)
- Sadece kısa cümlelerde çalışır
- Softmax kullanmaz
Neden: capraz-dikkat bloğunda Q_dec decoder'ın X_hedef'inden, K_capraz ise encoder_ciktisi'nden hesaplanıyor -- oz-vs-capraz tablosunda bu ayrım açıkça özetleniyor.
2. Notebook'ta çapraz dikkat matrisinin şekli (2, 3) -- yani kare değil. Bunun nedeni ne?
- Bir hesaplama hatası
- Hedef dizi (2 kelime, şimdiye kadar üretilen) ile kaynak dizi (3 kelime) farklı uzunlukta -- dikkat matrisinin şekli (hedef uzunluğu × kaynak uzunluğu) olduğu için kare olmak zorunda değil (doğru cevap)
- Sadece decoder'ın son katmanında bu şekil kare olmaz
- Matris her zaman kare olmalıydı, bu bir tasarım hatasıdır
Neden: capraz-dikkat bloğunun çıktısında matris şekli (2, 3) = (len(HEDEF_SIMDIYE_KADAR), len(kaynak)) -- self-attention'daki N×N kısıtlaması burada yoktur çünkü Q ve K farklı dizilerden geliyor.
3. 'cat' üretilirken çapraz dikkat neden kaynak cümledeki 'Kedi'ye en yüksek ağırlığı (0.658) veriyor?
- Rastgele bir sonuç
- Decoder'ın 'cat' sorgusu ile encoder çıktısındaki 'Kedi' anahtarı arasındaki nokta çarpım benzerliği en yüksek çıktığı için -- bu, gerçek modellerde eğitimle öğrenilen çeviri hizalamasının (alignment) küçük ölçekli bir örneği (doğru cevap)
- 'Kedi' kelimesi alfabetik olarak ilk sırada olduğu için
- Çapraz dikkat her zaman ilk kaynak kelimeye en yüksek ağırlığı verir
Neden: capraz-dikkat bloğunda 'cat' token'ının gömmesi öğretici amaçlı 'Kedi'ye yakın tasarlandı; softmax(QKᵀ/√d) formülü bu benzerliği en yüksek ağırlığa çeviriyor -- gerçek modellerde bu hizalama veri üzerinde eğitilir.
Özet
Özet
- Encoder-decoder yapısı, kaynak diziyi (encoder) ve hedef diziyi (decoder) ayrı ele alır -- çeviri gibi "diziden diziye" görevler için tasarlanmıştır.
- Decoder'ın iki dikkat türü var: maskeli self-attention (kendi ürettiklerine bakar) ve çapraz dikkat (encoder çıktısına bakar).
- Çapraz dikkatte Q decoder'dan, K ve V encoder çıktısından gelir -- dikkat matrisi kare olmak zorunda değildir.
- Notebook'ta 'cat' üretilirken, model 'Kedi'ye 0.658 ağırlıkla bakarak çeviri karşılığını buldu.
- GPT sadece decoder, BERT sadece encoder kullanır -- her Transformer modelinin encoder ve decoder içermesi gerekmez (18. ders).