

GPT ile "Attention is All You Need" farkı
Önkoşul:Transformer'ın eğitimi ve çıkarımı
Kanca
- derste eğittiğimiz mini decoder, aslında zaten bir GPT’nin küçük bir modeli. Peki GPT, 2017’nin “Attention is All You Need” mimarisinden tam olarak ne değiştirdi — ve bu değişiklikler neden bu kadar önemli oldu?
Sezgi
GPT (2018), orijinal encoder-decoder mimarisini yarıya indirdi: encoder’ı ve çapraz dikkati tamamen attı, sadece decoder blokları bıraktı. Bu, sadece bir “basitleştirme” değil — eğitim verisi ihtiyacını kökten değiştiren bir karar.
Mekanizma
Önce mimari farkı sayılarla görelim:
Çapraz dikkatin yokluğu, %25 daha az parametre
# 16. derste tam bir encoder-decoder kurduk: encoder (self-attention) + decoder
# (maskeli self-attention + çapraz dikkat + FFN). GPT (2018), bu mimariyi yarıya
# indirdi: sadece decoder blokları, çapraz dikkat yok.
D_MODEL = 512

def alt_katman_parametreleri(d_model, capraz_dikkat_var):
    self_attn = 4 * d_model * d_model  # Wq+Wk+Wv+Wo (12. ders)
    capraz_attn = 4 * d_model * d_model if capraz_dikkat_var else 0
    ffn = 2 * d_model * (4 * d_model)  # W1+W2 (15. ders)
    return self_attn + capraz_attn + ffn

encoder_decoder_blok = alt_katman_parametreleri(D_MODEL, capraz_dikkat_var=True)
gpt_blok = alt_katman_parametreleri(D_MODEL, capraz_dikkat_var=False)

print(f"Bir encoder-decoder (16. ders) decoder bloğu: {encoder_decoder_blok:,} parametre")
print(f"  (self-attention + çapraz dikkat + FFN)")
print(f"Bir GPT-tarzı (decoder-only) blok:            {gpt_blok:,} parametre")
print(f"  (Sadece self-attention + FFN -- çapraz dikkat yok)")
print(f"\nGPT bloğu, encoder-decoder bloğunun %{100*gpt_blok/encoder_decoder_blok:.0f}'i kadar parametre kullanıyor --")
print("kalan fark tamamen çapraz dikkat katmanının (Wq+Wk+Wv+Wo) yokluğundan geliyor.")
Bir encoder-decoder (16. ders) decoder bloğu: 4,194,304 parametre
(self-attention + çapraz dikkat + FFN)
Bir GPT-tarzı (decoder-only) blok: 3,145,728 parametre
(Sadece self-attention + FFN -- çapraz dikkat yok)
GPT bloğu, encoder-decoder bloğunun %75'i kadar parametre kullanıyor --
kalan fark tamamen çapraz dikkat katmanının (Wq+Wk+Wv+Wo) yokluğundan geliyor.Bu mimari fark, eğitim verisi ihtiyacını da değiştiriyor:
Eşleştirilmiş veri gerekmiyor
# Bu mimari fark, eğitim verisi ihtiyacını da değiştirir.
print("\nEncoder-decoder (16. ders): eşleştirilmiş (kaynak, hedef) çiftleri gerektirir")
print("  örn. (Türkçe cümle, İngilizce çevirisi) -- bu veri pahalı ve sınırlı.")
print("\nGPT (decoder-only): sadece düz metin yeterli -- 'bir sonraki kelimeyi tahmin et'")
print("  görevi, internetteki herhangi bir metinden (etiketleme gerektirmeden) öğrenilebilir.")
print("  Bu fark, GPT'nin neden bu kadar büyük veriyle eğitilebildiğini açıklıyor.")
Encoder-decoder (16. ders): eşleştirilmiş (kaynak, hedef) çiftleri gerektirir
  örn. (Türkçe cümle, İngilizce çevirisi) -- bu veri pahalı ve sınırlı.

GPT (decoder-only): sadece düz metin yeterli -- 'bir sonraki kelimeyi tahmin et'
  görevi, internetteki herhangi bir metinden (etiketleme gerektirmeden) öğrenilebilir.
  Bu fark, GPT'nin neden bu kadar büyük veriyle eğitilebildiğini açıklıyor.
Matematik
Post-norm ve pre-norm
Fark küçük görünüyor — sadece LayerNorm’un yeri değişiyor. Ama pre-norm’da, "" terimi hiçbir normalizasyondan geçmeden doğrudan bir sonraki katmana aktarılır — 14. dersteki “gradyan kestirme yolu” hiçbir engelle karşılaşmaz. Post-norm’da ise bu yol, her katmanda LayerNorm’dan geçmek zorunda kalır.
Kod
Bu küçük fark, derin bir yığında nasıl bir etki yaratıyor?
Pre-norm, derin modelleri kurtarıyor
# 14. derste "post-norm" (LayerNorm(x + Alt(x))) kullandık -- orijinal 2017 makalesi
# bunu kullanıyordu. GPT-2 ve sonrası ise "pre-norm" (x + Alt(LayerNorm(x))) kullanır.
# Bu, sadece bir detay mı, yoksa sonucu değiştiren bir seçim mi?
def alt_katman(boyut, seed, std=0.5):
    torch.manual_seed(seed)
    katman = nn.Linear(boyut, boyut)
    nn.init.normal_(katman.weight, std=std)
    return katman

# Kayıp: çıktının sabit, rastgele bir yöndeki izdüşümü. (Kayıp olarak h.sum() kullanılamaz:
# post-norm'da son işlem LayerNorm olduğu için çıktının toplamı her zaman ~0'dır ve
# gradyan, derinlikten bağımsız olarak sıfır çıkar -- yanıltıcı bir "çöküş" görürdük.)
KAYIP_YONU = torch.randn(1, 16, generator=torch.Generator().manual_seed(7))

def gradyan_olc(derinlik, mod, boyut=16):
    torch.manual_seed(1)
    x = torch.randn(1, boyut, requires_grad=True)
    h = x
    for i in range(derinlik):
        katman = alt_katman(boyut, seed=100 + i)
        norm = nn.LayerNorm(boyut)
        if mod == "post":
            h = norm(h + torch.tanh(katman(h)))          # orijinal makale
        else:
            h = h + torch.tanh(katman(norm(h)))            # GPT-2+
    kayip = (h * KAYIP_YONU).sum()
    kayip.backward()
    return x.grad.norm().item()

print(f"\n{'Derinlik':<10} {'Post-norm (2017 makale)':<26} {'Pre-norm (GPT-2+)':<20}")
sonuclar = {}
for derinlik in [1, 10, 50, 100]:
    sonuclar[derinlik] = (gradyan_olc(derinlik, "post"), gradyan_olc(derinlik, "pre"))
    print(f"{derinlik:<10} {sonuclar[derinlik][0]:<26.2e} {sonuclar[derinlik][1]:<20.2e}")

post_kat = sonuclar[100][0] / sonuclar[1][0]
pre_kat = sonuclar[100][1] / sonuclar[1][1]
post_kat_yazi = f"{post_kat:,.0f}".replace(",", ".")  # Türkçe binlik ayracı
print(f"\nPost-norm'da gradyan, 1 katmandan 100 katmana {post_kat_yazi} kat büyüyor -- her katmandaki")
print("LayerNorm gradyanı bir öncekinin üzerine çarparak ölçekliyor, etki derinlikle üstel birikiyor.")
print("(Alt katmanlar daha zayıf olsaydı aynı çarpım gradyanı söndürecekti: derin post-norm'da gradyanın")
print("büyüklüğü kontrolsüz -- orijinal Transformer bu yüzden dikkatli bir 'öğrenme oranı ısınması' ister.)")
print(f"Pre-norm'da '+x' kestirme yolu hiçbir normalizasyondan geçmiyor: aynı aralıkta değişim yalnızca")
print(f"{pre_kat:.1f} kat -- gradyan 100 katmanda bile makul aralıkta. GPT'nin pre-norm seçmesinin nedeni bu.")
Derinlik Post-norm (2017 makale) Pre-norm (GPT-2+)
1 3.54e+00 4.98e+00
10 4.64e+00 1.45e+01
50 2.16e+03 4.78e+01
100 1.62e+05 2.28e+01
Post-norm'da gradyan, 1 katmandan 100 katmana 45.585 kat büyüyor -- her katmandaki
LayerNorm gradyanı bir öncekinin üzerine çarparak ölçekliyor, etki derinlikle üstel birikiyor.
(Alt katmanlar daha zayıf olsaydı aynı çarpım gradyanı söndürecekti: derin post-norm'da gradyanın
büyüklüğü kontrolsüz -- orijinal Transformer bu yüzden dikkatli bir 'öğrenme oranı ısınması' ister.)
Pre-norm'da '+x' kestirme yolu hiçbir normalizasyondan geçmiyor: aynı aralıkta değişim yalnızca
4.6 kat -- gradyan 100 katmanda bile makul aralıkta. GPT'nin pre-norm seçmesinin nedeni bu.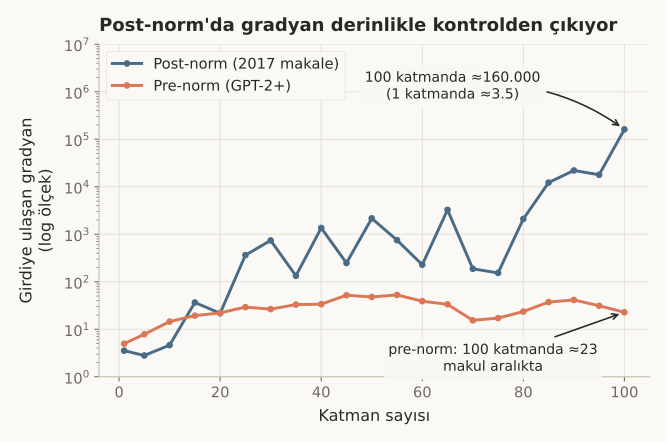 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu iki değişiklik (decoder-only + pre-norm), modern LLM’lerin standart tarifi hâline geldi:
- BERT (2018), GPT’nin tersini yaptı: sadece encoder kullandı (maskesiz self-attention) — metin üretmez, ama metni anlama (sınıflandırma, arama) görevlerinde güçlüdür.
- “Decoder-only + sadece düz metin” tarifi, GPT’nin internet ölçeğinde veriyle eğitilebilmesini sağladı — bugünün büyük dil modellerinin (GPT-4, Claude, LLaMA…) büyük çoğunluğu bu tarifi izler.
- Pre-norm’un da bir bedeli var: eğitim başarıyla tamamlandığında post-norm modellerin sonuç kalitesi çoğu zaman biraz daha iyi çıkar (derin pre-norm yığınlarında son katmanların katkısı azalır) — ama pratikte kararlı eğitim avantajı bu farkı fazlasıyla telafi eder.
Bu 2 hatayı yaparsın:
- GPT’nin “eksik” bir Transformer olduğunu düşünmek — encoder’ın çıkarılması bilinçli bir tasarım kararı, dil modelleme hedefine daha iyi uyduğu için.
- Pre-norm/post-norm farkını “önemsiz bir implementasyon detayı” sanmak — bu dersteki 100 katmanda ≈160.000’e karşı ≈23 farkı, derin bir modelin kararlı eğitilebilir olup olmadığını belirleyebilir.
Kendini test et
1. GPT, orijinal 'Attention is All You Need' mimarisinden hangi büyük bileşeni çıkardı?
- Self-attention mekanizmasını
- Encoder'ı ve decoder'ın çapraz dikkat katmanını -- GPT sadece (maskeli self-attention + FFN içeren) decoder bloklarını kullanır (doğru cevap)
- Position-wise feed-forward ağını
- Layer normalization'ı
Neden: mimari-fark bloğunda gpt_blok hesaplaması capraz_dikkat_var=False ile yapılıyor -- GPT bloğu, encoder-decoder bloğunun sadece %75'i kadar parametre taşıyor, farkı tamamen çapraz dikkatin yokluğu açıklıyor.
2. GPT'nin encoder-decoder yerine sadece decoder kullanması, eğitim verisi açısından neden pratik bir avantaj sağlıyor?
- Hiçbir avantajı yok
- Encoder-decoder eşleştirilmiş (kaynak, hedef) veri çiftleri gerektirir (örn. çeviri çiftleri) -- GPT ise sadece düz metinle, 'bir sonraki kelimeyi tahmin et' göreviyle eğitilebilir, bu da internetteki neredeyse her metni kullanılabilir hale getirir (doğru cevap)
- GPT daha az veriyle eğitilir
- Encoder-decoder'ın veriye hiç ihtiyacı yoktur
Neden: egitim-verisi-farki bloğunda bu ayrım açıkça vurgulanıyor -- eşleştirilmiş veri pahalı ve sınırlıyken, düz metin bol ve ucuzdur; bu, GPT'nin ölçeklenebilirliğinin temel nedenidir.
3. Notebook'ta post-norm'da gradyan 1 katmandan 100 katmana 45.000 kattan fazla büyürken, pre-norm'da yalnızca birkaç kat değişiyor. Bu farkın matematiksel nedeni ne?
- Rastgele bir sonuç, tekrarlanabilir değil
- Pre-norm'da '+x' terimi hiçbir normalizasyondan geçmeden bir sonraki katmana aktarılır (gradyan kestirme yolu engelsiz); post-norm'da bu yol her katmanda LayerNorm'dan geçmek zorunda kalır, bu da derin yığınlarda gradyanı bozabilir (doğru cevap)
- Pre-norm daha fazla parametre kullanır
- İkisi arasında hiçbir matematiksel fark yoktur
Neden: MathBox'taki formüllerde pre-norm y = x + Alt(LayerNorm(x)) -- '+x' terimi doğrudan aktarılıyor; post-norm y = LayerNorm(x + Alt(x)) -- toplam sonrasında normalize ediliyor, bu da kestirme yolu her katmanda 'kesiyor'.
Özet
Özet
- GPT, encoder'ı ve çapraz dikkati tamamen çıkarıp sadece decoder blokları (maskeli self-attention + FFN) kullanır.
- Bu mimari, GPT'nin eşleştirilmiş veri yerine sadece düz metinle eğitilebilmesini sağlar -- ölçeklenebilirliğin temel nedeni.
- GPT-2 ve sonrası, orijinal makalenin post-norm'u yerine pre-norm kullanır: LayerNorm, artık bağlantıdan önce uygulanır.
- Post-norm'da gradyan her katmanda LayerNorm'dan geçtiği için büyüklüğü derinlikle kontrolden çıkar (notebook'ta 100 katmanda 45.000 kat); pre-norm'da makul aralıkta kalır -- GPT'nin 96+ katmanlı olabilmesinin temel nedenlerinden biri.
- BERT, GPT'nin tersini yapar (sadece encoder) -- metin üretmez ama metni anlama görevlerinde güçlüdür.