

Position-wise feed-forward ağ
Önkoşul:Layer norm ve artık bağlantılar
Kanca
Bir Transformer bloğunun yarısını (attention) kurduk — token’lar birbirine baktı. Diğer yarı tamamen farklı bir iş yapıyor: her token’ı, diğerlerine hiç bakmadan, kendi içinde işliyor. Bu ne işe yarar?
Sezgi
“Position-wise feed-forward ağ” (FFN), DL Görüntü kategorisinde zaten gördüğün basit bir 2 katmanlı MLP (Linear → GELU → Linear) — yeni olan tek şey, bunun her token’a, aynı ağırlıklarla, birbirinden bağımsız uygulanması. Attention token’lar arasında bilgi taşırken, FFN her token’ın taşıdığı bilgiyi işler — ikisi tamamlayıcı iki farklı görev.
Mekanizma
Önce “position-wise” kelimesini sayılarla doğrulayalım: tüm diziyi birden işlemek ile her token’ı döngüyle tek tek işlemek aynı sonucu vermeli:
'Position-wise' ne demek?
# 10-14. derste attention, token'ları birbiriyle karşılaştırdı. Şimdi Transformer
# bloğunun ikinci yarısı: position-wise feed-forward ağ (FFN). "Position-wise" kelimesi
# tam olarak ne demek? Test edelim: aynı ağırlıkları her token'a ayrı ayrı mı, yoksa
# tüm diziye birden mi uyguluyor?
D, D_FF, N = 8, 32, 5
ffn = nn.Sequential(nn.Linear(D, D_FF), nn.GELU(), nn.Linear(D_FF, D))

X = torch.randn(N, D)

# Yöntem 1: tüm diziyi tek seferde işle.
cikti_toplu = ffn(X)

# Yöntem 2: her token'ı tek tek, döngüyle işle.
cikti_tek_tek = torch.stack([ffn(X[i]) for i in range(N)])

fark = (cikti_toplu - cikti_tek_tek).abs().max().item()
print(f"Tüm diziyi birden işlemek ile her token'ı tek tek işlemek arasındaki fark: {fark:.2e}")
print(f"torch.allclose: {torch.allclose(cikti_toplu, cikti_tek_tek, atol=1e-6)}")
print("\nFFN, aynı ağırlıkları her token'a bağımsız uyguluyor -- 'position-wise' tam olarak bunu")
print("ifade ediyor: konum fark etmez, her token aynı dönüşümden geçer, tek tek işlenmiş gibi.")
Tüm diziyi birden işlemek ile her token'ı tek tek işlemek arasındaki fark: 5.96e-08
torch.allclose: True
FFN, aynı ağırlıkları her token'a bağımsız uyguluyor -- 'position-wise' tam olarak bunu
ifade ediyor: konum fark etmez, her token aynı dönüşümden geçer, tek tek işlenmiş gibi.Şimdi FFN’i attention’dan ayıran kritik farkı gösterelim: bir token’ı değiştirdiğimizde, diğer token’ların çıktısı ne olur?
Attention token'lar arası bilgi taşır, FFN taşımaz
# Peki bu, attention'dan nasıl farklı? Attention'da bir token'ın çıktısı, diğer
# token'lara bağlıdır. FFN'de ise değil. Bunu kanıtlayalım: bir token'ı değiştirip,
# diğer token'ların çıktısının değişip değişmediğine bakalım.
def basit_attention(X, Wq, Wk, Wv):
    Q, K, V = X @ Wq, X @ Wk, X @ Wv
    puanlar = (Q @ K.transpose(-2, -1)) / (D ** 0.5)
    agirliklar = F.softmax(puanlar, dim=-1)
    return agirliklar @ V

Wq, Wk, Wv = torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5, torch.randn(D, D) * 0.5

X_degisik = X.clone()
X_degisik[0] = torch.randn(D) * 5  # Sadece 0. token'ı büyük ölçüde değiştir

attn_once = basit_attention(X, Wq, Wk, Wv)
attn_sonra = basit_attention(X_degisik, Wq, Wk, Wv)
ffn_once = ffn(X)
ffn_sonra = ffn(X_degisik)

print(f"\n0. token değiştirildi, diğer token'ların (1-4) çıktısı ne kadar değişti?")
print(f"{'Token':<8} {'Attention farkı':<20} {'FFN farkı':<20}")
for i in range(1, N):
    attn_fark = (attn_once[i] - attn_sonra[i]).abs().max().item()
    ffn_fark = (ffn_once[i] - ffn_sonra[i]).abs().max().item()
    print(f"{i:<8} {attn_fark:<20.4f} {ffn_fark:<20.2e}")
print("\nAttention'da diğer token'ların çıktısı da değişti (0. token'a 'bakıyorlardı').")
print("FFN'de diğer token'ların çıktısı hiç değişmedi (fark tam 0) -- FFN, token'lar arası")
print("bilgi taşımıyor; bu iş tamamen attention'a ait. FFN sadece her token'ı kendi içinde işliyor.")
0. token değiştirildi, diğer token'ların (1-4) çıktısı ne kadar değişti?
Token    Attention farkı      FFN farkı
1        3.0138               0.00e+00
2        12.3983              0.00e+00
3        12.4502              0.00e+00
4        4.4883               0.00e+00

Attention'da diğer token'ların çıktısı da değişti (0. token'a 'bakıyorlardı').
FFN'de diğer token'ların çıktısı hiç değişmedi (fark tam 0) -- FFN, token'lar arası
bilgi taşımıyor; bu iş tamamen attention'a ait. FFN sadece her token'ı kendi içinde işliyor.
Matematik
Position-wise feed-forward ağ
| Sembol | Anlamı |
|---|---|
| tek bir token’ın boyutlu temsili | |
| boyutunda genişleten matris | |
| boyutunda tekrar daraltan matris | |
| Genelde (örn. ) |
Bu formül, ‘e her seferinde, hangi token olduğuna bakmaksızın, aynı ile uygulanır — Transformer’ın “her token için ayrı bir ağ” değil, “Tüm token’lar için paylaşılan tek bir ağ” kullandığı anlamına gelir.
Kod
Gerçek ölçekte bu iki alt-katmanın (attention vs FFN) parametre payını karşılaştıralım:
FFN, parametrelerin büyük kısmını taşır
# Gerçek "Attention is All You Need" makalesindeki boyutlarla parametre sayısı:
D_MODEL, D_FF_GERCEK = 512, 2048
ffn_gercek = nn.Sequential(nn.Linear(D_MODEL, D_FF_GERCEK), nn.GELU(), nn.Linear(D_FF_GERCEK, D_MODEL))
parametre_sayisi = sum(p.numel() for p in ffn_gercek.parameters())
attention_parametre = 4 * D_MODEL * D_MODEL  # Wq + Wk + Wv + Wo (12. ders), hepsi d_model x d_model
print(f"\nGerçek ölçek: d_model={D_MODEL}, d_ff={D_FF_GERCEK} (= 4 x d_model)")
print(f"Tek bir FFN alt-katmanının parametre sayısı: {parametre_sayisi:,}")
print(f"Karşılaştırma: aynı boyuttaki tüm multi-head attention alt-katmanının (Wq+Wk+Wv+Wo) parametre sayısı: {attention_parametre:,}")
print(f"FFN/Attention oranı: {parametre_sayisi / attention_parametre:.2f}x")
print("FFN, Transformer'ın parametrelerinin büyük bir kısmını oluşturur --")
print("'bilginin nerede saklandığı' sorusunun cevabının büyük kısmı burada.")
Gerçek ölçek: d_model=512, d_ff=2048 (= 4 x d_model)
Tek bir FFN alt-katmanının parametre sayısı: 2,099,712
Karşılaştırma: aynı boyuttaki tüm multi-head attention alt-katmanının (Wq+Wk+Wv+Wo) parametre sayısı: 1,048,576
FFN/Attention oranı: 2.00x
FFN, Transformer'ın parametrelerinin büyük bir kısmını oluşturur --
'bilginin nerede saklandığı' sorusunun cevabının büyük kısmı burada.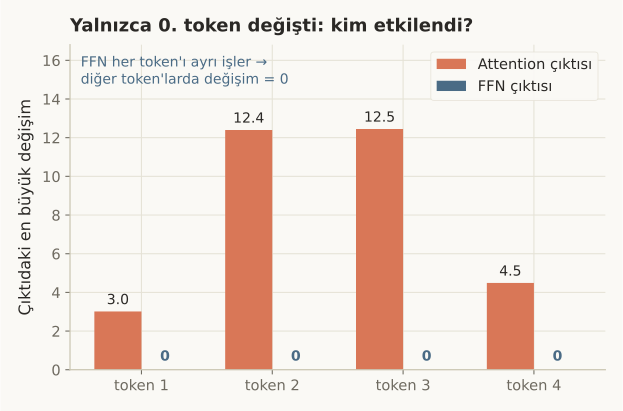 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu ayrım, Transformer’ın tasarım felsefesinin özeti sayılabilir:
- Attention = “Nereye bakayım?” (token’lar arası iletişim); FFN = “gördüğümle ne yapayım?” (her token’ın kendi işlenmesi) — bir Transformer bloğu, bu ikisini sırayla tekrarlayarak derinleşir.
- FFN’nin genişleme boyutu (), modelin “düşünme kapasitesinin” büyük kısmını taşır — araştırmalar, FFN katmanlarının olgu/bilgi depolamada (örn. “Fransa’nın başkenti Paris’tir”) özellikle önemli rol oynadığını gösteriyor.
- GELU (ya da ReLU), DL Görüntü kategorisinde (8. ders) zaten gördüğün aynı aktivasyon fonksiyonları — burada yeni bir matematik yok, sadece yeni bir bağlamda (Transformer bloğu içinde) kullanılıyorlar.
Bu 2 hatayı yaparsın:
- FFN’nin token’lar arasında bilgi taşıdığını sanmak — hayır, bu iş tamamen attention’a ait; FFN kesinlikle “position-wise” (konum-bağımsız çalışan, ama konumlar arası karıştırmayan) bir işlemdir.
- FFN’yi “attention’ın yanında küçük bir ek” sanmak — gerçekte FFN, parametrelerin yarısından fazlasını oluşturur (bu dersteki 2x oranına bak).
Kendini test et
1. 'Position-wise feed-forward ağ' ifadesindeki 'position-wise' ne anlama gelir?
- Her konum için farklı bir ağırlık matrisi kullanılır
- Aynı W1, W2 ağırlıkları her token'a, diğer token'lardan bağımsız olarak uygulanır -- tüm diziyi birden işlemekle her token'ı tek tek işlemek aynı sonucu verir (doğru cevap)
- Sadece cümlenin ilk konumuna uygulanır
- Konum bilgisini (13. ders) hesaplar
Neden: konum-bagimsiz-mi bloğunda, tüm diziyi birden işlemek ile döngüyle tek tek işlemek arasındaki fark 5.96e-08 (pratikte sıfır) -- bu, aynı ağırlıkların her token'a bağımsız uygulandığını kanıtlıyor.
2. 0. token'ı büyük ölçüde değiştirdiğimizde, attention'da diğer token'ların çıktısı değişirken, FFN'de hiç değişmiyor (fark tam 0). Bu farkın nedeni ne?
- FFN bozuktur
- Attention, her token'ın çıktısını diğer token'ların ağırlıklı bir karışımından hesaplar (10. ders); FFN ise her token'ı sadece kendi değerine bakarak işler, diğer token'lardan hiçbir girdi almaz (doğru cevap)
- Attention daha yavaştır
- Bu, sadece küçük modellerde görülen bir durumdur
Neden: attention-ile-fark bloğunda attention farkları 3.0-12.4 arasında (token'lar birbirini görüyor) iken, FFN farkları tam olarak 0.00e+00 -- FFN'nin matematiksel tanımı gereği (her token bağımsız işlenir) diğer token'ları hiç etkilemez.
3. Notebook'ta gerçek ölçekte (d_model=512, d_ff=2048) FFN'nin parametre sayısı, tüm multi-head attention alt-katmanının (Wq+Wk+Wv+Wo) 2 katı çıkıyor. Bu neyi gösteriyor?
- Bir hesaplama hatası olduğunu
- FFN'nin genişleme boyutu (d_ff = 4 x d_model) nedeniyle, Transformer'ın parametrelerinin büyük bir kısmının FFN katmanlarında bulunduğunu -- bu da modelin 'bilgi kapasitesinin' önemli bir kısmının FFN'de saklandığı anlamına gelir (doğru cevap)
- Attention'ın gereksiz olduğunu
- FFN'nin daha az önemli olduğunu
Neden: gercek-olcek bloğunda FFN parametre sayısı 2,099,712 iken attention 1,048,576 -- oran tam 2.00x, d_ff=4×d_model seçiminin doğrudan bir sonucu.
Özet
Özet
- FFN, DL Görüntü kategorisinden bildiğin 2 katmanlı bir MLP (Linear → GELU → Linear) -- yeni olan, her token'a aynı ağırlıklarla, bağımsız uygulanması.
- "Position-wise": tüm diziyi birden işlemek, her token'ı döngüyle tek tek işlemekle matematiksel olarak özdeştir.
- Attention token'lar arasında bilgi taşır; FFN taşımaz -- bir token değişince FFN'de diğerlerinin çıktısı hiç etkilenmez (fark tam 0).
- FFN'nin genişleme boyutu (d_ff, genelde 4×d_model) onu Transformer'ın parametre-ağır bileşeni yapar -- gerçek ölçekte attention'ın 2 katı parametre.
- Attention "nereye bakayım" sorusunu, FFN "gördüğümle ne yapayım" sorusunu cevaplar -- bir Transformer bloğu ikisini sırayla tekrarlar.