

Transformer'ın eğitimi ve çıkarımı
Önkoşul:Encoder-decoder yapısı
Kanca
10-16. derste bir Transformer’ın tüm parçalarını (attention, FFN, layer norm, encoder-decoder) elle kurduk. Bu ders, bu parçaları gerçekten bir araya getirip, gerçekten eğitiyor — ilk kez, elle tasarlanmış vektörler değil, gradyan inişiyle öğrenilen ağırlıklar.
Sezgi
Eğitimde model “öğretmen zorlaması” (teacher forcing) ile öğrenir: her adımda gerçek (doğru) önceki kelimeler verilir. Çıkarımda (inference) ise model kendi ürettiği kelimeleri bir sonraki adımın girdisi olarak kullanmak zorundadır. Bu iki mod arasındaki fark, hem hız hem güvenilirlik açısından önemli sonuçlar doğurur.
Mekanizma
Önce, öğretmen zorlamasıyla küçük bir decoder’ı gerçekten eğitelim — “ABCABCABC…” örüntüsünü öğrensin:
Öğretmen zorlamasıyla eğitim
# Eğitimde "öğretmen zorlaması" (teacher forcing) kullanılır: decoder'a her zaman
# gerçek (doğru) önceki token'lar verilir -- kendi (belki yanlış) tahminleri değil.
model = MiniDecoder(V, D, PENCERE)
optimize_edici = torch.optim.Adam(model.parameters(), lr=0.01)
kayip_gecmisi = []

for adim in range(400):
    baslangic = torch.randint(0, len(ids) - PENCERE - 1, (8,))
    girdi = torch.stack([ids[b:b + PENCERE] for b in baslangic])       # Gerçek önceki token'lar
    hedef = torch.stack([ids[b + 1:b + PENCERE + 1] for b in baslangic])  # bir sonraki gerçek token
    logits = model(girdi)
    kayip = F.cross_entropy(logits.reshape(-1, V), hedef.reshape(-1))
    optimize_edici.zero_grad()
    kayip.backward()
    optimize_edici.step()
    kayip_gecmisi.append(kayip.item())
    if adim % 100 == 0:
        print(f"adım {adim:<5} kayıp={kayip.item():.4f}")
print(f"adım {399:<5} kayıp={kayip_gecmisi[-1]:.6f}")
print("\nModel, 'ABCABCABC...' örüntüsünü gerçek (doğru) bağlamla eğitildi -- kayıp neredeyse sıfıra indi.")
adım 0 kayıp=1.1733
adım 100 kayıp=0.0007
adım 200 kayıp=0.0003
adım 300 kayıp=0.0002
adım 399 kayıp=0.000117
Model, 'ABCABCABC...' örüntüsünü gerçek (doğru) bağlamla eğitildi -- kayıp neredeyse sıfıra indi.Kayıp 400 adımda 1.17’den 0.0001’e indi — model örüntüyü öğrendi. Şimdi eğitim ile çıkarımın hızını karşılaştıralım:
Eğitim paralel, çıkarım sıralı
# Eğitimde bir büyük avantaj var: 11. dersteki nedensel maske sayesinde, pencere'deki
# tüm 8 pozisyonun kaybı tek bir matris işleminde (paralel) hesaplanır. Çıkarımda
# (inference) ise, her yeni token'ı üretmek için tüm geçmişi yeniden beklemek gerekir --
# 8. dersteki "sıralı hesaplamanın maliyeti" konusunun aynısı, şimdi üretim aşamasında.
def egitim_ileri_gecisi_sure(tekrar=200):
    girdi = torch.stack([ids[b:b + PENCERE] for b in torch.randint(0, len(ids) - PENCERE - 1, (8,))])
    with torch.no_grad():
        baslangic = time.perf_counter()
        for _ in range(tekrar):
            model(girdi)  # Tek çağrı, 8 pozisyonun hepsini birden işler
        return (time.perf_counter() - baslangic) / tekrar

def cikarim_uretim_sure(uzunluk=8, tekrar=200):
    with torch.no_grad():
        baslangic = time.perf_counter()
        for _ in range(tekrar):
            uretilen = [stoi["A"]]
            for _ in range(uzunluk):
                pencere_ids = torch.tensor(uretilen[-PENCERE:]).unsqueeze(0)
                model(pencere_ids)  # Her token için ayrı bir çağrı
                uretilen.append(0)
        return (time.perf_counter() - baslangic) / tekrar

egitim_suresi = egitim_ileri_gecisi_sure()
cikarim_suresi = cikarim_uretim_sure()
print(f"\n8 pozisyonluk bir pencereyi eğitimde işlemek (tek paralel çağrı): {egitim_suresi*1000:.3f} ms")
print(f"8 token'lık bir diziyi çıkarımda üretmek (8 ayrı sıralı çağrı):  {cikarim_suresi*1000:.3f} ms")
print(f"Çıkarım, eğitimin {cikarim_suresi/egitim_suresi:.1f} katı yavaş -- aynı iş, ama sıralı yapılmak zorunda.")
8 pozisyonluk bir pencereyi eğitimde işlemek (tek paralel çağrı): 0.611 ms
8 token'lık bir diziyi çıkarımda üretmek (8 ayrı sıralı çağrı):  4.470 ms
Çıkarım, eğitimin 7.3 katı yavaş -- aynı iş, ama sıralı yapılmak zorunda.
Matematik
Öğretmen zorlaması ve çapraz entropi
Dikkat: formüldeki — kayıp hesaplanırken, model . adımda ne tahmin ettiğine bakılmaksızın, her zaman gerçek (etiketlenmiş) ile beslenir. Bu, 8. DL Görüntü dersindeki (sınıflandırma kaybı) çapraz entropinin aynısı — tek fark, her token pozisyonunda ayrı bir sınıflandırma problemi olması ( = kelime dağarcığı boyutu kadar sınıf).
Kod
Şimdi gerçek çıkarımı (autoregressive generation) çalıştıralım — model artık öğretmensiz, kendi başına:
Otoregresif üretim: model kendi çıktısını yer
# Şimdi gerçek çıkarımı (autoregressive generation) çalıştıralım: model, kendi
# ürettiği token'ları bir sonraki adımın girdisi olarak kullanır.
model.eval()
uretilen = [stoi["A"]]
with torch.no_grad():
    for _ in range(20):
        pencere_ids = torch.tensor(uretilen[-PENCERE:]).unsqueeze(0)
        logits = model(pencere_ids)
        sonraki = logits[0, -1].argmax().item()
        uretilen.append(sonraki)
uretilen_metin = "".join(VOCAB[i] for i in uretilen)
print(f"\n'A' tohumundan başlayarak, model kendi tahminleriyle 20 token üretti:")
print(f"  {uretilen_metin}")
print("Model, öğretmen zorlaması olmadan, sadece kendi çıktısını kullanarak örüntüyü doğru sürdürdü.")
'A' tohumundan başlayarak, model kendi tahminleriyle 20 token üretti:
ABCABCABCABCABCABCABC
Model, öğretmen zorlaması olmadan, sadece kendi çıktısını kullanarak örüntüyü doğru sürdürdü.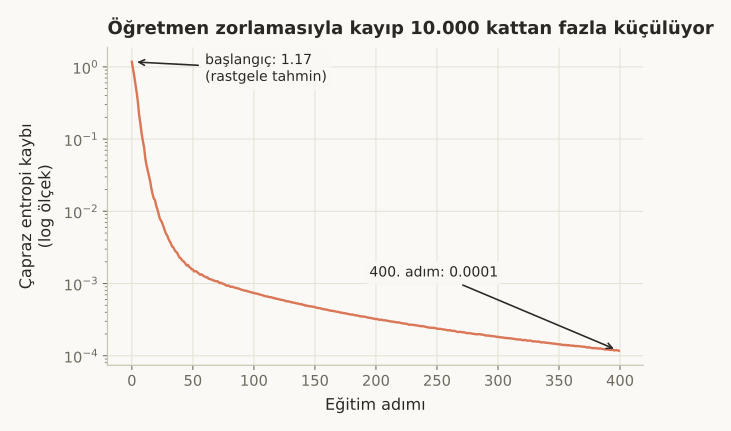 (grafiği tam boyutta, yeni sekmede aç)
Peki ya model erken bir hata yaparsa? “Maruz kalma önyargısı” (exposure bias) tam olarak bunu sorar:
Elle bir hata enjekte et: model toparlanır mı?
# Eğitim ve çıkarım arasındaki gizli bir uyumsuzluk: eğitimde model hiçbir zaman
# kendi hatalı bir tahminini görmedi (her zaman gerçek bağlamla beslendi). Çıkarımda
# ise erken bir hata, tüm sonraki bağlamı bozabilir. Buna "maruz kalma önyargısı"
# (exposure bias) denir. Elle bir hata enjekte edip test edelim:
uretilen_bozuk = [stoi["A"], stoi["B"], stoi["C"], stoi["A"]]
uretilen_bozuk.append(stoi["A"])  # Yanlış token -- doğrusu 'B' olmalıydı
with torch.no_grad():
    for _ in range(10):
        pencere_ids = torch.tensor(uretilen_bozuk[-PENCERE:]).unsqueeze(0)
        logits = model(pencere_ids)
        sonraki = logits[0, -1].argmax().item()
        uretilen_bozuk.append(sonraki)
bozuk_metin = "".join(VOCAB[i] for i in uretilen_bozuk)
print(f"\nElle bozulan dizi (5. karakter yanlış 'A' yapıldı): {bozuk_metin}")
print("Bu özel örnekte model hızla toparlandı -- çünkü 'ABC' örüntüsü son iki karaktere bakarak")
print("her yerden yeniden başlatılabilir (aşırı redundant/öngörülebilir bir dil). Gerçek doğal dilde")
print("bağlam çok daha az öngörülebilir olduğu için, erken bir hata genelde daha kalıcı bozulmaya yol açar --")
print("bu yüzden 'maruz kalma önyargısı' büyük dil modellerinde ciddi bir araştırma konusudur.")
Elle bozulan dizi (5. karakter yanlış 'A' yapıldı): ABCAABCABCABCAB
Bu özel örnekte model hızla toparlandı -- çünkü 'ABC' örüntüsü son iki karaktere bakarak
her yerden yeniden başlatılabilir (aşırı redundant/öngörülebilir bir dil). Gerçek doğal dilde
bağlam çok daha az öngörülebilir olduğu için, erken bir hata genelde daha kalıcı bozulmaya yol açar --
bu yüzden 'maruz kalma önyargısı' büyük dil modellerinde ciddi bir araştırma konusudur.
Nerede işe yarar
Bu ders, teoriyi (10-16. ders) gerçek bir eğitim döngüsüyle birleştirdi:
- Gerçek dil modelleri, bizim 60 karakterlik örüntümüzden milyarlarca kat daha büyük ve daha az öngörülebilir metinlerle eğitilir — bu yüzden maruz kalma önyargısı, gerçek modellerde bizim örneğimizdeki kadar kolay “toparlanmaz”.
- Çıkarımın sıralı olması (bu dersteki 7.3x yavaşlık), büyük dil modellerinin en pahalı kısmıdır — bu yüzden hız optimizasyonları (KV-cache, speculative decoding gibi teknikler) ML mühendisliğinin aktif bir araştırma alanıdır.
- “Sampling” (22. ders) her zaman en olası token’ı seçmez — burada
argmax(en olası token) kullandık, ama gerçek modeller genelde çeşitlilik için rastgelelik (temperature, top-k/top-p) ekler.
Bu 2 hatayı yaparsın:
- Öğretmen zorlamasının çıkarımda da kullanıldığını sanmak — hayır, çıkarımda gerçek gelecek token’lar yoktur (henüz üretilmediler); model sadece kendi geçmiş çıktısına güvenebilir.
- Bu dersteki “model hatadan hızla toparlandı” sonucunu her modele genellemek — bu, örüntünün aşırı tekrarlayan (redundant) olmasından kaynaklanıyor; doğal dilde toparlanma çok daha zordur.
Kendini test et
1. Eğitimde 'öğretmen zorlaması' (teacher forcing) ne anlama gelir?
- Model, kendi ürettiği token'ları bir sonraki adımın girdisi olarak kullanır
- Kayıp hesaplanırken, model bir önceki adımda ne tahmin etmiş olursa olsun, her zaman gerçek (etiketli) önceki token'larla beslenir -- bu, öğrenmeyi hızlandırır ve kararlı hale getirir (doğru cevap)
- Öğretmen, modelin her adımını elle kontrol eder
- Sadece ilk token için gerçek veri kullanılır
Neden: ogretmen-zorlamasi-egitimi bloğunda girdi = ids[b:b+pencere] (gerçek token'lar) olarak sabitleniyor, modelin kendi tahminleri değil -- MathBox'taki formülde y_{t-1}^gerçek notasyonu bunu vurguluyor.
2. Notebook'ta çıkarım (inference), eğitimin 7.3 katı yavaş çıkıyor. Bu farkın nedeni ne?
- Çıkarım kodu kötü yazılmış
- Eğitimde 11. dersteki nedensel maske sayesinde tüm pencere pozisyonları tek bir paralel matris işleminde hesaplanır; çıkarımda ise her yeni token, bir öncekine bağımlı olduğu için ayrı ayrı, sırayla üretilmek zorundadır (doğru cevap)
- Çıkarım daha fazla bellek kullanır
- Model çıkarımda daha büyük hale gelir
Neden: paralel-egitim-sirali-cikarim bloğunda eğitim tek bir model(girdi) çağrısıyla 8 pozisyonu birden işlerken, çıkarım 8 ayrı model() çağrısı gerektiriyor -- 8. dersteki 'sıralı hesaplamanın maliyeti' konusunun üretim aşamasındaki karşılığı.
3. Notebook'ta elle enjekte edilen bir hatadan sonra model hızla toparlandı. Metinde bu sonucun neden her modele genellenemeyeceği açıklanıyor?
- Genellenebilir, her model aynı şekilde toparlanır
- 'ABCABC...' örüntüsü aşırı tekrarlayan (redundant) olduğu için, son birkaç karaktere bakarak her yerden yeniden başlanabilir; gerçek doğal dilde bağlam çok daha az öngörülebilir olduğu için erken bir hata genelde daha kalıcı bozulmaya yol açar (doğru cevap)
- Model çok küçük olduğu için toparlandı
- Bu sonuç sadece bu notebook için geçerlidir, genel bir ilkesi yoktur
Neden: maruz-kalma-onyargisi bloğunun çıktısı 'ABCAABCABCABCAB' -- model toparlandı, ama bu, kullanım bölümünde açıklandığı gibi periyodik örüntünün aşırı redundant olmasından kaynaklanıyor; gerçek dilde maruz kalma önyargısı ciddi bir araştırma konusudur.
Özet
Özet
- Bu ders, 10-15. dersteki tüm parçaları (attention, FFN, layer norm, artık bağlantı) bir araya getirip gerçekten eğitti -- kayıp 1.17'den 0.0001'e indi.
- Eğitimde 'öğretmen zorlaması' kullanılır: model her zaman gerçek önceki token'larla beslenir, kendi tahminleriyle değil.
- Çıkarımda (inference) model kendi ürettiği token'ları kullanmak zorundadır -- bu, eğitime göre 7.3 kat daha yavaştır çünkü sıralı olmak zorundadır.
- 'Maruz kalma önyargısı' (exposure bias), eğitimde hiç görülmeyen 'kendi hatasıyla besleme' durumunun çıkarımda yarattığı riski ifade eder.
- Bu basit örnekte model hatadan hızla toparlandı -- ama bu, örüntünün aşırı redundant olmasından kaynaklanır; gerçek dilde durum daha zordur.