

Sekans modellerinin sınırı
Önkoşul:LSTM ve GRU
Kanca
- derste LSTM’in RNN’in kaybolan gradyan sorununu büyük ölçüde azalttığını gördük. Bu ders, “büyük ölçüde”nin yeterli olmadığı iki sorunu ortaya koyuyor — ve bu iki sorun, 9-10. derste attention’ın neden icat edildiğini açıklıyor.
Sezgi
RNN/LSTM’in iki temel sınırı var: (1) tüm diziyi sabit boyutlu tek bir vektöre sıkıştırmak zorunda kalmaları, (2) adımları sırayla işlemek zorunda kalmaları. Bir cümlede bilginin nasıl aktığını, RNN’in zincirinde ve attention’ın doğrudan bağlantısında karşılaştıralım:
RNN -- bilgi zincir boyunca akar
"Dün"den en uzak kelimeye ulaşmak için 6 adım (hop) gerekiyor.
Attention -- bilgi doğrudan akar
"Dün"den tüm diğer kelimelere ulaşmak için her zaman 1 adım yeterli.
RNN'de bilgi, aradaki her kelimeden sırayla geçmek zorunda -- bu yüzden uzak kelimeler arasındaki ilişki, 7. derste gördüğümüz gibi zayıflayabilir. Attention'da ise her kelime, diğer her kelimeye doğrudan (tek adımda) bakabilir -- mesafe, artık bir dezavantaj değil.
Mekanizma
İlk sorun: sabit boyutlu bir “darboğaz”.
Sabit boyut, değişken uzunluk
# 6-7. derste RNN/LSTM'in bir diziyi tek bir gizli durum vektörüne "özetlediğini"
# gördük. Sorun: bu vektörün boyutu sabit -- ama dizinin uzunluğu değişken.
BOYUT = 32
lstm = nn.LSTM(input_size=BOYUT, hidden_size=BOYUT, batch_first=True)

print(f"Gizli durum boyutu: {BOYUT} sayı -- sabit.")
for uzunluk in [5, 20, 100]:
    print(f"  {uzunluk} kelimelik bir cümle de, {BOYUT} kelimelik bir paragraf da,")
    print(f"  aynı {BOYUT} sayılık vektöre sıkıştırılmak zorunda.")
print("\nSezgisel olarak: cümle uzadıkça, her kelimeye düşen 'yer' küçülür -- bu bir darboğazdır.")
Gizli durum boyutu: 32 sayı -- sabit.
5 kelimelik bir cümle de, 32 kelimelik bir paragraf da,
aynı 32 sayılık vektöre sıkıştırılmak zorunda.
20 kelimelik bir cümle de, 32 kelimelik bir paragraf da,
aynı 32 sayılık vektöre sıkıştırılmak zorunda.
100 kelimelik bir cümle de, 32 kelimelik bir paragraf da,
aynı 32 sayılık vektöre sıkıştırılmak zorunda.
Sezgisel olarak: cümle uzadıkça, her kelimeye düşen 'yer' küçülür -- bu bir darboğazdır.Şimdi 7. dersteki deneyi daha uzun bir dizide tekrarlayalım:
100 kelimede LSTM'nin hafızası
# 7. dersteki gradyan deneyini daha uzun bir dizide tekrarlayıp, hafızanın ne kadar
# 'seyreldiğini' somutlaştıralım.
def gradyan_olc(uzunluk):
    torch.manual_seed(42)
    katman = nn.LSTM(input_size=BOYUT, hidden_size=BOYUT, batch_first=True)
    dizi = torch.randn(1, uzunluk, BOYUT, requires_grad=True)
    cikis, _ = katman(dizi)
    kayip = cikis[0, -1].sum()
    kayip.backward()
    return dizi.grad[0, 0].norm().item()

print(f"\n{'Dizi uzunluğu':<16} {'İlk kelimenin son çıktıya etkisi (gradyan normu)':<50}")
for uzunluk in [10, 50, 100]:
    g = gradyan_olc(uzunluk)
    print(f"{uzunluk:<16} {g:<50.3e}")
print("\n100 kelimelik bir dizide, LSTM (7. dersteki 'en dayanıklı' mimarimiz) bile ilk kelimenin")
print("etkisini neredeyse sıfırlıyor. Uzun belgelerde, dizinin başındaki bilgi fiilen kayboluyor.")
Dizi uzunluğu    İlk kelimenin son çıktıya etkisi (gradyan normu)
10               4.540e-03
50               1.467e-11
100              5.689e-22

100 kelimelik bir dizide, LSTM (7. dersteki 'en dayanıklı' mimarimiz) bile ilk kelimenin
etkisini neredeyse sıfırlıyor. Uzun belgelerde, dizinin başındaki bilgi fiilen kayboluyor.
100 kelimelik bir dizide, LSTM (7. dersteki en dayanıklı mimarimiz) bile ilk kelimenin etkisini 5.7e-22’ye indiriyor — pratikte sıfır. Çoğu kişi “LSTM’i kullanınca uzun mesafe sorunu çözüldü” sanır. Yanlış, çünkü LSTM sorunu sadece erteledi — yeterince uzun bir dizide aynı çöküş yine oluyor.
Matematik
Sıralı işlem sayısı ve maksimum yol uzunluğu
| Mimari | Sıralı işlem sayısı | Maksimum bilgi yolu uzunluğu |
|---|---|---|
| RNN / LSTM | — dizi uzunluğuyla orantılı | |
| Self-Attention | — sabit |
( = dizi uzunluğu.) Bu tablo, “Attention is All You Need” makalesinden (18. ders) — RNN’de hem hesaplama hem “bilginin kat etmesi gereken mesafe” dizi uzadıkça büyür; attention’da ikisi de sabit kalır.
Kod
İkinci sorun: sıralı hesaplamanın maliyeti.
Sıralı işlem, hızı sınırlıyor
# İkinci, farklı bir sorun: RNN/LSTM, adım t'yi işlemeden önce adım t-1'i bitirmek
# zorunda -- bu, 3. DL Vision dersindeki 'vektörleştirme' hızlanmasını engeller.
def sure_olc(uzunluk, tekrar=50):
    dizi = torch.randn(16, uzunluk, BOYUT)
    with torch.no_grad():
        for _ in range(5):
            lstm(dizi)  # ısınma
        baslangic = time.perf_counter()
        for _ in range(tekrar):
            lstm(dizi)
    return (time.perf_counter() - baslangic) / tekrar

print(f"\n{'Dizi uzunluğu':<16} {'İşlem süresi (ms)':<20}")
sureler = {}
for uzunluk in [20, 40, 80, 160, 320]:
    s = sure_olc(uzunluk)
    sureler[uzunluk] = s
    print(f"{uzunluk:<16} {s*1000:<20.3f}")

oran = sureler[320] / sureler[20]
print(f"\nDizi 16 kat uzayınca (20->320), işlem süresi {oran:.1f} kat arttı -- yaklaşık doğrusal.")
print("Bunun nedeni: LSTM, adım 320'yi işlemek için adım 1'den 319'a kadar her adımı sırayla")
print("bitirmiş olmak zorunda -- 3. dersteki gibi bir 'hepsini birden çarp' hilesi yok.")
Dizi uzunluğu    İşlem süresi (ms)
20               0.613
40               0.793
80               1.445
160              2.537
320              4.911

Dizi 16 kat uzayınca (20->320), işlem süresi 8.0 kat arttı -- yaklaşık doğrusal.
Bunun nedeni: LSTM, adım 320'yi işlemek için adım 1'den 319'a kadar her adımı sırayla
bitirmiş olmak zorunda -- 3. dersteki gibi bir 'hepsini birden çarp' hilesi yok.
Dizi 16 kat uzayınca (20→320), işlem süresi 8 kat arttı — yaklaşık doğrusal. Bunun nedeni: LSTM, adım 320’yi işlemek için adım 1’den 319’a kadar her adımı sırayla bitirmiş olmak zorunda — 3. DL Vision dersindeki “hepsini birden çarp” (vektörleştirme) hilesi burada yok.
RNN vs Self-Attention: teorik karşılaştırma
# 'Attention is All You Need' makalesinin (18. dersimiz) ünlü karşılaştırma tablosu:
print(f"\n{'Mimari':<16} {'Sıralı işlem sayısı':<22} {'Max. bilgi yolu uzunluğu':<26}")
print(f"{'RNN/LSTM':<16} {'O(n) -- dizi uzunluğuyla orantılı':<22} {'O(n)':<26}")
print(f"{'Self-Attention':<16} {'O(1) -- sabit':<22} {'O(1)':<26}")
print("\n(n = dizi uzunluğu.) RNN'de hem hesaplama hem 'bilginin kat etmesi gereken mesafe'")
print("dizi uzadıkça büyür. Attention'da ikisi de sabit kalır -- 9-10. dersin konusu bu.")
Mimari Sıralı işlem sayısı Max. bilgi yolu uzunluğu
RNN/LSTM O(n) -- dizi uzunluğuyla orantılı O(n)
Self-Attention O(1) -- sabit O(1)
(n = dizi uzunluğu.) RNN'de hem hesaplama hem 'bilginin kat etmesi gereken mesafe'
dizi uzadıkça büyür. Attention'da ikisi de sabit kalır -- 9-10. dersin konusu bu.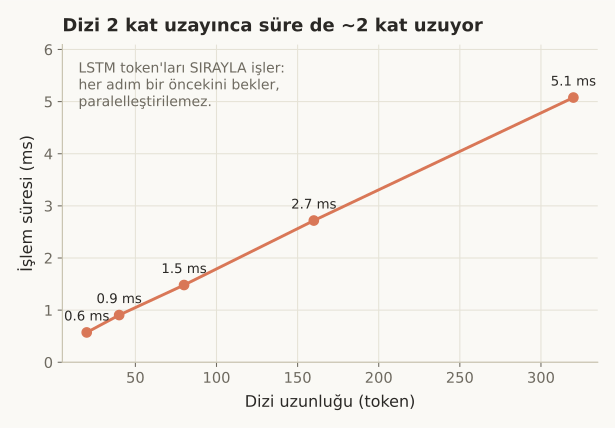 (grafiği tam boyutta, yeni sekmede aç)
Nerede işe yarar
Bu iki sınır, 2014-2017 arası NLP araştırmasının en aktif konusuydu:
- Darboğaz sorunu, özellikle uzun cümle çevirisinde (encoder-decoder, 16. ders) belirginleşiyordu — çevirmen, tüm cümleyi tek bir vektörde “hatırlamak” zorundaydı.
- Sıralı hesaplama sorunu, GPU’ların paralel gücünden tam olarak yararlanamamak anlamına geliyordu — büyük modelleri eğitmek yavaşlıyordu.
- Bu iki sorun, 2017’de “Attention is All You Need” makalesiyle (18. ders) aynı anda çözüldü — bu makalenin başlığı tam olarak bunu söylüyor: “attention yeterli, RNN’e gerek yok”.
Bu 3 hatayı yaparsın:
- “LSTM kullandım, uzun mesafe sorunu bitti” sanmak — sorun ertelenir, ortadan kalkmaz.
- Darboğaz sorunuyla kaybolan gradyan sorununu karıştırmak — ikisi farklı (biri kapasite, biri gradyan akışı) ama ilişkili sorunlar.
- RNN’in “eski, kullanılmaz” bir teknik olduğunu düşünmek — hâlâ küçük, kısa-dizili problemlerde makul bir seçimdir.
Kendini test et
1. Notebook'ta 100 kelimelik bir dizide LSTM'nin ilk kelimenin gradyanını 5.7e-22'ye indirmesi neyi gösteriyor?
- LSTM bozuktur
- LSTM, kaybolan gradyan sorununu sadece erteler -- yeterince uzun bir dizide, 7. dersteki RNN'in yaşadığı aynı çöküş, LSTM'de de (daha yavaş ama) yine oluyor (doğru cevap)
- LSTM sadece kısa dizilerde çalışacak şekilde tasarlanmıştır
- Bu beklenmeyen bir sonuçtur
Neden: 7. derste LSTM'in RNN'den çok daha iyi olduğunu gördük, ama "daha iyi" "sonsuz" demek değildir -- hücre durumu da her adımda biraz bilgi kaybeder, bu da yeterince uzun dizilerde birikerek aynı çöküşe yol açar.
2. RNN/LSTM'in 'sıralı işlem sayısı O(n)' olmasının pratik sonucu nedir?
- Hiçbir pratik etkisi yoktur
- Dizi uzunluğu arttıkça işlem süresi de orantılı olarak artar -- 3. DL Vision dersindeki vektörleştirme hızlanmasından yararlanılamaz, çünkü her adım bir öncekini beklemek zorundadır (doğru cevap)
- RNN'ler her zaman GPU'da çalışamaz
- Bu sadece teorik bir kavramdır, pratikte ölçülemez
Neden: Notebook'ta dizi 16 kat uzayınca işlem süresi 8 kat arttı -- bu, adım t'nin adım t-1'i beklemek zorunda olmasının doğrudan sonucudur; paralelleştirilemeyen bu sıralılık, büyük modelleri eğitmeyi yavaşlatır.
3. Self-Attention'ın 'maksimum bilgi yolu uzunluğu O(1)' olması ne anlama gelir?
- Attention hiçbir zaman doğru çalışmaz
- Dizideki herhangi iki kelime arasındaki bilgi, dizi ne kadar uzun olursa olsun, her zaman tek bir adımda (doğrudan) aktarılabilir -- RNN'deki gibi aradaki kelimelerden sırayla geçmeye gerek yoktur (doğru cevap)
- Attention sadece 1 kelimelik dizilerde çalışır
- Bu, RNN ile aynı anlama gelir
Neden: RNNvsAttentionAkisi bileşeninde gösterildiği gibi, RNN'de bilgi zincirdeki her kelimeden sırayla geçmek zorundayken (yol uzunluğu = mesafe), attention'da her kelime diğer her kelimeye doğrudan bağlanır (yol uzunluğu her zaman 1) -- bu da dizi ne kadar uzarsa uzasın sabit kalır.
Özet
Özet
- RNN/LSTM, tüm diziyi sabit boyutlu tek bir vektöre sıkıştırmak zorunda -- bu bir darboğazdır.
- LSTM, kaybolan gradyanı erteler ama ortadan kaldırmaz -- yeterince uzun dizilerde aynı sorun geri döner.
- RNN/LSTM'in sıralı doğası (O(n) sıralı işlem), GPU paralelleşmesinden yararlanmayı engeller.
- Self-attention, hem sabit-uzunluklu bilgi yolu (O(1)) hem sabit sıralı işlem sayısı (O(1)) sunarak bu iki sorunu birlikte çözer.
- Bu iki sınır, "Attention is All You Need" makalesinin (18. ders) çıkış noktasıdır.