

Güven aralığı
Önkoşul:Örnekleme ve örneklem hatası
Kanca
Bir araştırma “%95 güvenle, ortalama puan 67.4 ile 72.9 arasında” diyor. Bu, “gerçek ortalamanın bu aralıkta olma ihtimali %95” demek mi? Hayır — ve bu yanlış anlama o kadar yaygın ki, doğru anlamı görmek için 100 aralığı yan yana çizmemiz gerekecek.
Sezgi
Önceki derste gördük: her örneklem, popülasyon ortalamasını biraz farklı tahmin eder. Güven aralığı, bu tahminin etrafına “muhtemelen gerçek değer buradadır” diyebileceğimiz bir bant çizer. Ama “%95 güven” ifadesi, bu belirli aralık hakkında değil, yöntem hakkında bir iddiadır.
%95 güven aralığı şu anlama gelir: aynı yöntemle 100 farklı örneklem çeksen ve her birinden bir aralık kursan, bu aralıkların yaklaşık 95 tanesi gerçek ortalamayı içerirdi. Elindeki TEK aralık ya içerir ya içermez — %95 olasılık orada değil, yöntemin uzun vadeli başarı oranında.
- Gerçek ortalamayı içeriyor
- Kaçırıyor
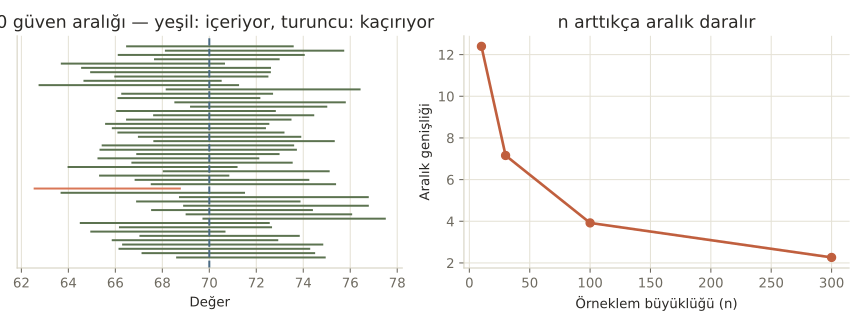
100 örneklemden 94 tanesinin %95 güven aralığı gerçek ortalamayı (70) içeriyor — beklenen: yaklaşık 95.
Güven seviyesini ve n’i değiştir: her yatay çizgi bir örneklemden kurulan aralık. Yeşil olanlar gerçek ortalamayı (70) içeriyor, turuncu olanlar kaçırıyor. %95 seçtiğinde, yaklaşık 95 tanesinin yeşil olduğunu göreceksin.
Mekanizma
Somut sayılarla ilerleyelim. Sınav puanlarının gerçek ortalaması 70, std sapması 10 olsun (normalde bilmeyiz, burayı göstermek için biliyoruz). 30 kişilik bir örneklem çekip bir aralık kuralım:
Tek bir güven aralığı
# Sınav puanlarının gerçek popülasyon ortalaması 70, std sapması 10 olsun (bilmediğimizi
# varsayalım). 30 kişilik bir örneklem çekip ortalamayı tahmin edip bir güven aralığı kuralım.
gercek_ortalama, gercek_std = 70, 10
n = 30
ornek = rng.normal(gercek_ortalama, gercek_std, size=n)

x_bar = ornek.mean()
s = ornek.std(ddof=1)  # örneklemden tahmin edilen std (gerçekte bilmiyoruz)
standart_hata = s / np.sqrt(n)

z_95 = 1.96  # %95 güven için kritik z değeri
alt = x_bar - z_95 * standart_hata
ust = x_bar + z_95 * standart_hata

print(f"Örneklem ortalaması: {x_bar:.2f}")
print(f"Standart hata:       {standart_hata:.2f}")
print(f"%95 güven aralığı:   [{alt:.2f}, {ust:.2f}]")
print(f"Gerçek ortalama (70) bu aralıkta mı? {'Evet' if alt <= gercek_ortalama <= ust else 'Hayır'}")
Örneklem ortalaması: 70.17
Standart hata: 1.42
%95 güven aralığı: [67.39, 72.95]
Gerçek ortalama (70) bu aralıkta mı? EvetAralık [67.39, 72.95] çıktı ve gerçek ortalama (70) bu aralıkta. Ama bu tek denemeden emin olamayız — “%95 güven” iddiasını test etmek için 1000 kez tekrarlayalım:
1000 aralığın kaçı gerçeği içeriyor?
# "%95 güven" ne demek? 1000 farklı örneklem çekip her birinden bir %95 aralık kuralım,
# kaçının gerçek ortalamayı içerdiğini sayalım.
tekrar = 1000
iceren = 0
for _ in range(tekrar):
    ornek_t = rng.normal(gercek_ortalama, gercek_std, size=n)
    x_bar_t = ornek_t.mean()
    se_t = ornek_t.std(ddof=1) / np.sqrt(n)
    alt_t, ust_t = x_bar_t - z_95 * se_t, x_bar_t + z_95 * se_t
    if alt_t <= gercek_ortalama <= ust_t:
        iceren += 1

print(f"\n{tekrar} aralıktan {iceren} tanesi gerçek ortalamayı içeriyor (%{iceren / tekrar * 100:.1f})")
print("Beklenen: yaklaşık %95 — 'güven' burada YÖNTEMİN güvenilirliğine atıfta bulunuyor.")
1000 aralıktan 928 tanesi gerçek ortalamayı içeriyor (%92.8)
Beklenen: yaklaşık %95 — 'güven' burada YÖNTEMİN güvenilirliğine atıfta bulunuyor.
1000 aralıktan 928 tanesi (%92.8) gerçek ortalamayı içeriyor — %95’e yakın ama tam değil. Bu fark tesadüf değil: örneklem std sapmasını (s) gerçek std sapma (σ) yerine kullandık, ve n=30 gibi orta büyüklükte bir örneklemde bu küçük bir eksik kapsamaya yol açar. Bu tam olarak bir sonraki derste göreceğimiz t-dağılımının çözdüğü problem — z yerine t kullanmak bu küçük sapmayı düzeltir.
Çoğu kişi “%95 güven aralığı, gerçek ortalamanın %95 ihtimalle içeride olduğu aralıktır” sanır. Değil, çünkü gerçek ortalama sabit bir sayıdır (70), rastgele değildir — rastgele olan, bizim kurduğumuz aralıktır. “İçeride olma ihtimali” aralık için anlamlı, gerçek ortalama için anlamsızdır.
Matematik
Güven aralığının formülü
| Sembol | Anlamı |
|---|---|
| Örneklem ortalaması | |
| Güven seviyesine karşılık gelen kritik değer (%90 → 1.645, %95 → 1.96, %99 → 2.576) | |
| Standart hata — örneklemden tahmin edilen | |
| Hata payı (margin of error) — aralığın yarı genişliği |
Güven seviyesini yükseltmek (‘ı büyütmek) aralığı genişletir — daha “güvenli” olmak istersen, daha geniş bir bant çizmen gerekir. Bu bir ödünleşim: dar aralık daha kesin ama daha riskli, geniş aralık daha güvenli ama daha az bilgilendirici.
Kod
n arttıkça aralığın nasıl daraldığını görelim — daha fazla veri, daha kesin bir tahmin:
n arttıkça aralık daralır
# n arttıkça aralık nasıl daralıyor (daha kesin bir tahmin)?
for n_deneme in [10, 30, 100, 300]:
    ornek_n = rng.normal(gercek_ortalama, gercek_std, size=n_deneme)
    se_n = ornek_n.std(ddof=1) / np.sqrt(n_deneme)
    genislik_araligi = 2 * z_95 * se_n
    print(f"n={n_deneme:>3}  aralık genişliği={genislik_araligi:.2f}")
n= 10 aralık genişliği=18.98
n= 30 aralık genişliği=6.89
n=100 aralık genişliği=3.84
n=300 aralık genişliği=2.28n=10’dan n=300’e çıkınca aralık genişliği 18.98’den 2.28’e düşüyor — 8 kata yakın bir daralma, ama n sadece 30 kat arttı (√30 ≈ 5.5 ilişkisiyle tutarlı).
Nerede işe yarar
Güven aralıkları, “tek bir sayı değil, bir belirsizlik bandı” vermek istediğin her yerde kullanılır:
- A/B testleri. “Dönüşüm oranı %3.2 ± %0.4” gibi bir sonuç, tek bir noktadan çok daha dürüst bir bilgi verir.
- Anket sonuçları. “Hata payı ±%3” ifadesi, aslında bir güven aralığının yarı genişliğidir.
- Bilimsel raporlama. Tek bir nokta tahmini yerine aralık vermek, sonucun ne kadar kesin olduğunu şeffaf şekilde gösterir.
Bu 3 hatayı yaparsın:
- “%95 güven aralığı” ifadesini “gerçek değerin %95 ihtimalle burada olduğu” diye yorumlamak.
- Küçük örneklemde (
n < 30gibi) z kritik değerini kullanmak — bir sonraki derste göreceğimiz gibi, t-dağılımı burada daha doğrudur. - Farklı güven aralıklarını (örn. iki grubun %95 aralıkları) örtüşüyor diye “aralarında fark yok” sonucuna direkt atlamak — bu, doğru hipotez testi yapmanın yerini tutmaz (13-15. dersler).
Kendini test et
1. "%95 güven aralığı [67, 73]" ifadesinin doğru yorumu nedir?
- Gerçek ortalamanın bu aralıkta olma ihtimali %95'tir
- Aynı yöntemle tekrar tekrar örneklem çekilse, kurulan aralıkların yaklaşık %95'i gerçek ortalamayı içerirdi (doğru cevap)
- Veri noktalarının %95'i bu aralıktadır
- Bu aralık her zaman doğrudur
Neden: Güven seviyesi, YÖNTEMİN uzun vadeli başarı oranını ifade eder — tek bir aralık için "olasılık" kavramı anlamlı değildir, çünkü gerçek ortalama sabittir, rastgele olan aralığın kendisidir.
2. Notebook'ta 1000 aralıktan sadece 928'i (%92.8) gerçek ortalamayı içerdi, %95 değil. Bu neden oldu?
- Kod hatalıydı
- Örneklem std sapması (s) gerçek σ yerine kullanıldığında, orta büyüklükteki örneklemlerde z kritik değeri hafif eksik kapsama verir (doğru cevap)
- Rastgele sayı üreteci bozuktu
- Popülasyon ortalaması yanlış hesaplanmıştı
Neden: Bu gerçek ve beklenen bir istatistiksel incelik: s, σ'nın kusursuz bir tahmini değildir; bu belirsizliği tam olarak hesaba katan araç t-dağılımıdır (sonraki ders).
3. Güven seviyesini %95'ten %99'a çıkarırsan aralığa ne olur?
- Daralır
- Genişler (doğru cevap)
- Değişmez
- Ortalama değişir
Neden: Daha yüksek güven seviyesi daha büyük bir z* kritik değeri gerektirir, bu da hata payını ve dolayısıyla aralığın genişliğini artırır — daha 'güvenli' olmak için daha geniş bir bant çizmen gerekir.
Özet
Özet
- Güven aralığı, bir örneklem ortalamasının etrafına kurulan ve gerçek ortalamayı yakalama şansı yüksek bir bant çizer.
- "%95 güven" YÖNTEMİN uzun vadeli başarı oranını ifade eder — tek bir aralık için olasılık yorumu yanlıştır.
- Formül: x̄ ± z* × (s/√n) — z*, seçilen güven seviyesine göre belirlenir.
- Güven seviyesi arttıkça aralık genişler; örneklem büyüklüğü arttıkça aralık daralır.
- Küçük-orta örneklemlerde z yerine t-dağılımı kullanmak, kapsama oranını nominal seviyeye daha yakın tutar.