

Ki-kare testi
Önkoşul:Tip 1 / Tip 2 hata ve istatistiksel güç
Kanca
Üç farklı e-posta konu başlığı gönderdin: A %24.0, B %29.0, C %19.0 açılma oranı aldı. z-testi veya t-testi burada işe yaramaz — çünkü ortalama değil, kategoriler arasındaki ilişkiyi test ediyoruz. Başlık ile açma davranışı gerçekten ilişkili mi, yoksa bu farklar şans mı?
Sezgi
Önceki testler (z, t) sayısal ortalamaları karşılaştırıyordu. Ama “başlık A/B/C” ve “açtı/açmadı” gibi kategorik değişkenlerde ortalama diye bir şey yok — bunun yerine her kategori kombinasyonunda kaç kişi olduğunu (frekans) sayarız.
Ki-kare testi, gözlenen frekansların, “hiçbir ilişki yok” (H0) varsayımı altında beklenen frekanslardan ne kadar uzaklaştığını ölçer. H0 doğruysa (başlık açma oranını etkilemiyorsa), her başlığın açılma oranı aynı olurdu — genel ortalamaya eşit. Gözlenen sayılar bu “beklenen” sayılardan ne kadar uzaksa, ki-kare o kadar büyür.
Mekanizma
Verilerle başlayalım:
Üç başlığın açılma oranları
# Üç farklı e-posta konu başlığı gönderildi. Her biri kaç kişiye gitti, kaçı açtı?
# Satırlar: konu başlığı (A, B, C). Sütunlar: [açtı, açmadı].
gozlenen = np.array([
    [120, 380],   # Başlık A: 500 kişiye gitti, 120'si açtı
    [145, 355],   # Başlık B: 500 kişiye gitti, 145'i açtı
    [95, 405],    # Başlık C: 500 kişiye gitti, 95'i açtı
])

etiketler = ["Başlık A", "Başlık B", "Başlık C"]
for etiket, satir in zip(etiketler, gozlenen):
    toplam = satir.sum()
    print(f"{etiket}: {satir[0]}/{toplam} açtı (%{satir[0] / toplam * 100:.1f})")
Başlık A: 120/500 açtı (%24.0)
Başlık B: 145/500 açtı (%29.0)
Başlık C: 95/500 açtı (%19.0)H0: başlık ile açma davranışı arasında ilişki yok. H1: ilişki var.
Ki-kare testi
# H0: konu başlığı ile açma davranışı arasında ilişki yok (bağımsızlar).
# H1: aralarında ilişki var — başlık, açma oranını etkiliyor.
ki_kare, p_degeri, serbestlik_derecesi, beklenen = stats.chi2_contingency(gozlenen)

print(f"\nKi-kare istatistiği: {ki_kare:.2f}")
print(f"Serbestlik derecesi: {serbestlik_derecesi}")
print(f"p-değeri: {p_degeri:.4f}")
print(f"α=0.05'e göre karar: {'H0 reddedilir — başlık açma oranını etkiliyor' if p_degeri < 0.05 else 'H0 reddedilemez'}")
Ki-kare istatistiği: 13.71
Serbestlik derecesi: 2
p-değeri: 0.0011
α=0.05'e göre karar: H0 reddedilir — başlık açma oranını etkiliyor
p=0.0011, α=0.05’ten çok küçük — H0 reddedilir. Başlık gerçekten açma oranını etkiliyor. Peki bu sayı nereden geliyor? “Beklenen” sayılara bakalım:
Gözlenen vs beklenen
# "Beklenen" sayılar: H0 doğruysa (hiçbir ilişki yoksa) her hücrede olması gereken sayı.
print("\nGözlenen vs beklenen (H0 altında):")
for etiket, g_satir, b_satir in zip(etiketler, gozlenen, beklenen):
    print(f"{etiket}: gözlenen açan={g_satir[0]:>3}   beklenen açan={b_satir[0]:.1f}")

print("\nKi-kare istatistiği, gözlenen ve beklenen arasındaki farkların karesini toplar —")
print("fark ne kadar büyükse, ki-kare o kadar büyür, H0'dan o kadar uzaklaşırız.")
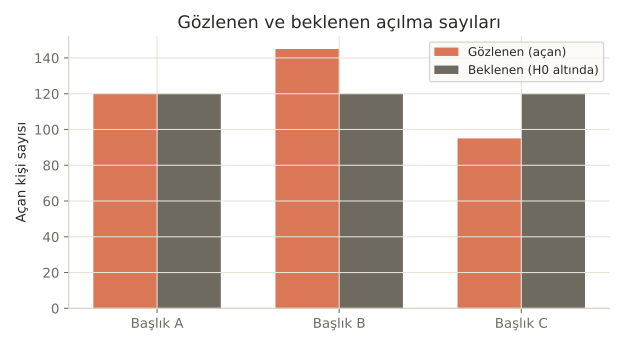
Gözlenen vs beklenen (H0 altında):
Başlık A: gözlenen açan=120   beklenen açan=120.0
Başlık B: gözlenen açan=145   beklenen açan=120.0
Başlık C: gözlenen açan= 95   beklenen açan=120.0

Ki-kare istatistiği, gözlenen ve beklenen arasındaki farkların karesini toplar —
fark ne kadar büyükse, ki-kare o kadar büyür, H0'dan o kadar uzaklaşırız.
H0 doğru olsaydı (başlığın hiçbir etkisi olmasaydı), her başlığın açılma sayısı genel ortalama olan 120 civarında olurdu — üç başlık da toplamda 1500 kişiye gitti, 360 kişi açtı, ortalama oran %24, yani her başlıkta beklenen 120. Ama B’de 145 (25 fazla), C’de 95 (25 az) gözlendi — bu sapmalar toplanıp ki-kare istatistiğini oluşturuyor.
Çoğu kişi ki-kare testinin “hangi başlığın en iyi olduğunu” söylediğini sanır. Değil, çünkü ki-kare sadece “aralarında bir ilişki var mı yok mu” sorusuna cevap verir — hangi başlığın diğerinden anlamlı şekilde farklı olduğunu bulmak için ayrıca ikili karşılaştırmalar (örn. B’ye karşı C için ayrı bir iki-oranlı z-testi) gerekir.
Matematik
Ki-kare istatistiğinin formülü
| Sembol | Anlamı |
|---|---|
| Gözlenen (observed) frekans — her hücrede gerçekte sayılan kişi sayısı | |
| Beklenen (expected) frekans — H0 doğruysa (bağımsızlık varsa) o hücrede olması gereken sayı | |
| Tüm hücrelerdeki (gözlenen−beklenen)² / beklenen değerlerinin toplamı |
Her hücre için fark karesi alınıp beklenen değere bölünür — bu, büyük beklenen sayılarda aynı mutlak farkın orantılı olarak daha az “şaşırtıcı” sayılmasını sağlar. Serbestlik derecesi ile hesaplanır; bizim örneğimizde .
Kod
Nerede işe yarar
Ki-kare testi, kategorik veride ilişki aramanın standart aracıdır:
- Pazarlama ve ürün testleri. Birden fazla varyantın (A/B/C testi, sadece iki değil) kategorik bir sonucu (tıkladı/tıklamadı) etkileyip etkilemediği.
- Anket analizi. “Cinsiyet ile ürün tercihi arasında ilişki var mı?” gibi iki kategorik değişken arasındaki bağımsızlık testleri.
- Kalite kontrol. Farklı üretim hatlarında hata oranlarının birbirinden farklı olup olmadığı.
Bu 3 hatayı yaparsın:
- Beklenen hücre sayısı çok küçükken (genelde
< 5kuralı) ki-kare testini uygulamak — sonuç güvenilmez olur, bu durumda Fisher’ın kesin testi tercih edilir. - Ki-kareyi “hangi kategori daha iyi” sorusuna doğrudan cevap veriyor sanmak — sadece “genel bir ilişki var mı” sorusuna cevap verir.
- Aynı veriyle sürekli yeni kategori kombinasyonları deneyip “anlamlı” bir sonuç arayana kadar test tekrarlamak (çoklu karşılaştırma sorunu).
Kendini test et
1. Ki-kare testi hangi tür veriler için kullanılır?
- Sadece sürekli sayısal veri
- Kategorik veri (frekanslar, sayımlar) (doğru cevap)
- Sadece iki grup karşılaştırması
- Sadece Normal dağılan veri
Neden: Ki-kare testi, kategorilere ayrılmış verinin frekanslarını karşılaştırır — z ve t testlerinin aksine ortalama değil, sayım (count) verisiyle çalışır.
2. "Beklenen frekans" ne anlama gelir?
- Gerçekte gözlenen sayı
- H0 (ilişki yok) doğruysa, o hücrede olması matematiksel olarak beklenen sayı (doğru cevap)
- Araştırmacının tahmini
- Her zaman gözlenenle aynı sayıdır
Neden: Beklenen frekans, satır ve sütun toplamlarından H0 (bağımsızlık) varsayımı altında hesaplanan teorik bir sayıdır — gözlenen ile karşılaştırılarak ki-kare istatistiği oluşturulur.
3. Ki-kare testi p=0.0011 ile "H0 reddedilir" sonucunu verdi. Bu ne anlama gelir?
- B başlığı kesinlikle en iyisidir
- Başlık ile açma davranışı arasında istatistiksel olarak anlamlı bir ilişki var, ama hangi başlığın nasıl farklı olduğunu tek başına söylemez (doğru cevap)
- Test geçersizdir
- Tüm başlıklar aynı performansı gösteriyor
Neden: Ki-kare sadece genel bir ilişkinin varlığını test eder; hangi kategorinin diğerlerinden nasıl farklı olduğunu bulmak için ek analiz (ikili karşılaştırmalar) gerekir.
Özet
Özet
- Ki-kare testi, kategorik değişkenler arasında bir ilişki olup olmadığını test eder.
- Gözlenen ve beklenen (H0 altında hesaplanan) frekanslar arasındaki fark, ki-kare istatistiğini oluşturur.
- Fark ne kadar büyükse (ve beklenen sayıya göre orantılı olarak ne kadar önemliyse), ki-kare o kadar büyür.
- Ki-kare sadece "ilişki var mı" sorusuna cevap verir — hangi kategorinin nasıl farklı olduğunu göstermez.
- Küçük beklenen frekanslarda (genelde <5) ki-kare güvenilmez olur, alternatif testler gerekir.