

Normal dağılım
Önkoşul:Olasılık dağılım fonksiyonları
Kanca
200 kişilik bir sınıfın sınav sonuçlarına bakıyorsun: çoğu kişi ortalamanın etrafında toplanmış, birkaç kişi çok düşük, birkaç kişi çok yüksek almış. İnsan boyları, ölçüm hataları, bir fabrikadaki vida uzunlukları — hepsi aynı şekle benziyor. Bu şekle normal dağılım deniyor. Neden bu kadar yaygın, ve bir öğrencinin 80 üzeri alma ihtimalini bu eğriden nasıl okuyoruz?
Sezgi
70 ortalamalı bir sınavı düşün. 70’e çok yakın puan almak kolay — küçük şanssızlıklar ve küçük şansların toplamı seni ortalamadan pek uzaklaştırmaz. Ama 95 almak için pek çok küçük şeyin aynı anda senin lehine dönmesi gerekir; bu nadir. Normal dağılım tam olarak bunu çiziyor: ortalamaya yakın değerler sık, uzak değerler gittikçe seyrekleşiyor, ve bu seyrekleşme simetrik.
Aşağıdaki oyun alanında ortalamayı ve standart sapmayı değiştir. Standart sapma küçüldükçe eğri sivrileşiyor — sınıf daha “tahmin edilebilir” hâle geliyor. Büyüdükçe eğri yayılıyor — sonuçlar daha dağınık.
- PDF — olasılık yoğunluğu
- CDF — birikimli olasılık
Eşiğin (80) üzerinde kalma olasılığı: %15.9
Grafikte iki çizgi var: PDF (düz çizgi) belli bir puanın etrafının ne kadar “yoğun” olduğunu gösterir — tek başına bir olasılık değildir, bir yoğunluktur. CDF (kesikli çizgi) ise “bu puan ve altını alanların oranı nedir” sorusunun cevabıdır — 0’dan başlar, 1’e çıkar. Eşik çizgisini sürükle, sağdaki sayının nasıl değiştiğini izle.
Mekanizma
Somut sayılarla ilerleyelim. Sınavın ortalaması μ (mu) = 70, standart sapması σ (sigma) = 10 olsun.
- Merkeze bak. 70 puan, ortalamanın tam üzerinde — yoğunluk burada en yüksek.
- Bir standart sapma uzaklaş. 80 puan (70 + 10), yoğunluk düşmeye başlamış ama hâlâ makul bir bölgedeyiz — sınıfın büyük kısmı 60–80 arasında.
- İki standart sapma uzaklaş. 90 puan (70 + 2×10), artık eğrinin kenarındayız — buraya ulaşan öğrenci sayısı azalıyor.
- CDF’e geç. “80 ve üzeri kaç kişi” sorusunu PDF eğrisinin altındaki alanı 80’den sonsuza kadar toplayarak cevaplarız. Bunu elle entegre almak yerine CDF fonksiyonunu kullanıyoruz: alan(80, ∞) = 1 − CDF(80).
Aşağıdaki koda göz at: önce PDF’i sıfırdan NumPy ile hesaplıyoruz, sonra aynı sonucu scipy.stats ile doğruluyoruz.
Sıfırdan NumPy
# 200 öğrencilik bir sınav: ortalama 70, standart sapma 10 varsayalım.
ortalama, std = 70, 10


def normal_pdf(x, mu, sigma):
    # Normal dağılımın olasılık yoğunluk fonksiyonu, sıfırdan.
    katsayi = 1 / (sigma * np.sqrt(2 * np.pi))
    us = -((x - mu) ** 2) / (2 * sigma**2)
    return katsayi * np.exp(us)


for puan in [50, 60, 70, 80, 90]:
    yogunluk = normal_pdf(puan, ortalama, std)
    print(f"puan={puan:>3}  yoğunluk={yogunluk:.4f}")
puan= 50 yoğunluk=0.0054
puan= 60 yoğunluk=0.0242
puan= 70 yoğunluk=0.0399
puan= 80 yoğunluk=0.0242
puan= 90 yoğunluk=0.0054scipy.stats ile
# Aynı hesabı scipy.stats ile doğrula, sonra soruyu tersten sor:
# "80 ve üzeri alan öğrencilerin oranı nedir?"
dagilim = stats.norm(loc=ortalama, scale=std)

for puan in [50, 60, 70, 80, 90]:
    print(f"puan={puan:>3}  yoğunluk={dagilim.pdf(puan):.4f}")

oran_80_uzeri = 1 - dagilim.cdf(80)
print(f"\n80 ve üzeri alanların oranı: %{oran_80_uzeri * 100:.1f}")
puan= 50 yoğunluk=0.0054
puan= 60 yoğunluk=0.0242
puan= 70 yoğunluk=0.0399
puan= 80 yoğunluk=0.0242
puan= 90 yoğunluk=0.0054
80 ve üzeri alanların oranı: %15.9Çoğu kişi PDF değerini doğrudan bir olasılık sanır — “yoğunluk 0.0399, yani %3.99 mu?” Değil, çünkü PDF sürekli bir değişken için nokta olasılığı vermez, sadece o civarın ne kadar “kalabalık” olduğunu gösterir. Gerçek olasılığı almak için her zaman bir aralığın altındaki alanı (yani CDF farkını) hesaplarız.
Matematik
Normal dağılımın formülü
| Sembol | Anlamı |
|---|---|
| İncelediğimiz değer (örn. bir sınav puanı) | |
| Ortalama — eğrinin tepe noktası | |
| Standart sapma — eğrinin ne kadar yayıldığı | |
| Doğal logaritma tabanı (≈ 2.718) |
Formülün mantığı: üstel kısım , ortalamadan uzaklaştıkça hızla büyüyen negatif bir sayı üretir — ‘nin üzeri bu kadar negatifleşince değer hızla sıfıra yaklaşır. büyüdükçe aynı uzaklık için ceza daha hafif olur, eğri yayılır. Baştaki katsayısı ise eğrinin altındaki toplam alanın her zaman tam 1 olmasını garanti eder.
CDF’in kapalı bir formülü yok — ‘in integrali erf (hata fonksiyonu) cinsinden yazılır ve sayısal olarak hesaplanır. Pratikte bunu elle yazmak yerine scipy.stats.norm.cdf kullanırız.
Kod
Şimdi bir soruyu uçtan uca cevaplayalım: 80 ve üzeri alan öğrencilerin oranı nedir?
Eşik üstü oran
# Aynı hesabı scipy.stats ile doğrula, sonra soruyu tersten sor:
# "80 ve üzeri alan öğrencilerin oranı nedir?"
dagilim = stats.norm(loc=ortalama, scale=std)

for puan in [50, 60, 70, 80, 90]:
    print(f"puan={puan:>3}  yoğunluk={dagilim.pdf(puan):.4f}")

oran_80_uzeri = 1 - dagilim.cdf(80)
print(f"\n80 ve üzeri alanların oranı: %{oran_80_uzeri * 100:.1f}")
puan= 50 yoğunluk=0.0054
puan= 60 yoğunluk=0.0242
puan= 70 yoğunluk=0.0399
puan= 80 yoğunluk=0.0242
puan= 90 yoğunluk=0.0054
80 ve üzeri alanların oranı: %15.9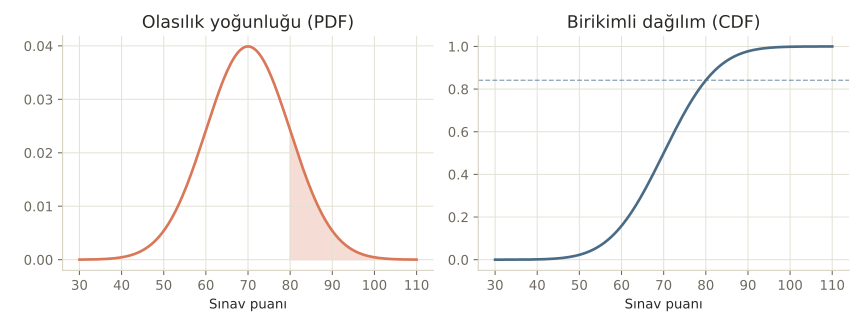
Nerede işe yarar
Normal dağılım üç yerde sürekli karşına çıkacak:
- Kalite kontrol. Bir üretim hattında parça uzunlukları normal dağılırsa, “toleransın dışına çıkma oranı” doğrudan CDF’ten okunur.
- A/B testleri ve hipotez testleri. İleride göreceğin z-testi ve t-testi, örneklem ortalamalarının normale yaklaştığı varsayımına (merkezi limit teoremi) dayanır.
- Standartlaştırma (z-skoru). Farklı ölçeklerdeki iki değeri karşılaştırmak için ikisini de “kaç standart sapma uzaktayım” birimine çeviririz.
Bu 3 hatayı yaparsın:
- Her veriyi normal sanmak. Gelir dağılımı gibi çarpık (sağa yayılan) veriler normale zorlanırsa yanlış sonuç çıkar — önce histograma bak.
- PDF yüksekliğini olasılıkla karıştırmak (yukarıda değindik).
- σ = 0 olan bir durumda formülü doğrudan çalıştırmaya çalışmak — bölme hatası verir; gerçek veride bu, “hiç varyans yok” demektir ve ayrı ele alınmalı.
Kendini test et
1. Bir sınıfın ortalaması 70, standart sapması 10. Hangi puan aralığı "tipik" sayılır?
- 60–80 arası (doğru cevap)
- Sadece tam 70
- 90 ve üzeri
- Sınıfın alt yarısı
Neden: 60–80, ortalamadan bir standart sapma içindeki bölge — eğrinin en yoğun kısmı burası.
2. PDF eğrisinin bir noktadaki yüksekliği ne anlama gelir?
- O noktadaki kesin olasılık
- O civarın yoğunluğu — tek başına olasılık değil (doğru cevap)
- O noktaya kadar birikmiş toplam olasılık
- Standart sapmanın değeri
Neden: Sürekli dağılımlarda nokta olasılığı sıfırdır; PDF sadece yoğunluğu gösterir, olasılık aralığın altındaki alandan (CDF farkından) gelir.
3. Standart sapma iki katına çıkarsa eğriye ne olur?
- Tepe noktası yükselir
- Eğri yayılır ve basıklaşır (doğru cevap)
- Eğri sağa kayar
- Hiçbir şey değişmez
Neden: σ büyüdükçe değerler ortalamadan daha fazla uzaklaşabilir; eğri altındaki alan sabit (1) kaldığı için yayılan eğri otomatik olarak basıklaşır.
Özet
Özet
- Normal dağılım, ortalama etrafında yoğunlaşan ve simetrik seyrekleşen değerleri tanımlar — μ (merkez) ve σ (yayılım) ile belirlenir.
- PDF bir yoğunluktur, olasılık değildir; gerçek olasılık için bir aralığın altındaki alanı (CDF farkını) hesaplarız.
- CDF, "bu değer ve altı" sorusunun doğrudan cevabıdır — 0 ile 1 arasında, hep artan.
- "80 ve üzeri oranı" gibi sorular 1 − CDF(80) ile çözülür.
- PDF yüksekliğini olasılıkla karıştırmak en yaygın hata — sürekli dağılımda tek nokta olasılığı sıfırdır.