

z-testi ve p-değeri
Önkoşul:Hipotez testi mantığı
Kanca
Bir A/B testinde 1000 kişilik kontrol grubunun %8.0’i, 1000 kişilik deney grubunun %10.5’i dönüşüm yaptı — 2.5 puanlık bir fark. Bu, yeni tasarımın gerçekten daha iyi olduğunu mu gösteriyor, yoksa 2000 kişilik bu örneklemde şans eseri mi çıktı?
Sezgi
Önceki derste tek bir ortalamayı bilinen bir değerle karşılaştırdık. Burada iki grubun oranlarını karşılaştırıyoruz — A/B testlerinin klasik senaryosu. Mantık aynı: “iki grubun gerçek dönüşüm oranı aynıymış gibi davran (H0), sonra gözlemlenen farkın bununla ne kadar uyumsuz olduğuna bak.”
İki oranın farkını test etmek için z-testi kullanırız, çünkü örneklemler büyükse (1000+1000 gibi) merkezi limit teoremi sayesinde oranların farkının dağılımı Normal’e çok yakın olur. z-testi, bu farkı “kaç standart hata uzakta” sorusuna çevirir — tıpkı önceki derste tek bir ortalama için yaptığımız gibi.
Mekanizma
Verilerle başlayalım:
A/B testi verisi
# Bir A/B testi: eski buton (kontrol) ve yeni buton (deney) — hangisi daha çok tıklanıyor?
n_kontrol, donusum_kontrol = 1000, 80    # %8.0 dönüşüm
n_deney, donusum_deney = 1000, 105       # %10.5 dönüşüm

p_kontrol = donusum_kontrol / n_kontrol
p_deney = donusum_deney / n_deney

print(f"Kontrol dönüşüm oranı: %{p_kontrol * 100:.1f}  ({donusum_kontrol}/{n_kontrol})")
print(f"Deney dönüşüm oranı:   %{p_deney * 100:.1f}  ({donusum_deney}/{n_deney})")
print(f"Gözlemlenen fark:      %{(p_deney - p_kontrol) * 100:.1f} puan")
Kontrol dönüşüm oranı: %8.0 (80/1000)
Deney dönüşüm oranı: %10.5 (105/1000)
Gözlemlenen fark: %2.5 puanŞimdi H0 (iki grubun gerçek oranı aynı) varsayımı altında bir z istatistiği kuralım. Bunun için iki grubu “havuzlayıp” (pooled) ortak bir oran tahmin ederiz — çünkü H0 doğruysa, iki grup zaten aynı popülasyondan geliyor demektir:
İki oranlı z-testi
# H0: iki grubun gerçek dönüşüm oranı aynı. H1: farklı (iki yönlü test).
# Havuzlanmış (pooled) oran, H0 doğruyken ortak varyansı tahmin etmek için kullanılır.
p_havuz = (donusum_kontrol + donusum_deney) / (n_kontrol + n_deney)
standart_hata = np.sqrt(p_havuz * (1 - p_havuz) * (1 / n_kontrol + 1 / n_deney))

z = (p_deney - p_kontrol) / standart_hata
p_degeri = 2 * (1 - stats.norm.cdf(abs(z)))  # iki yönlü

print(f"\nHavuzlanmış oran: {p_havuz:.4f}")
print(f"Standart hata:    {standart_hata:.4f}")
print(f"z istatistiği:    {z:.2f}")
print(f"p-değeri (iki yönlü): {p_degeri:.4f}")
print(f"α=0.05'e göre karar: {'H0 reddedilir — fark anlamlı' if p_degeri < 0.05 else 'H0 reddedilemez'}")
Havuzlanmış oran: 0.0925
Standart hata:    0.0130
z istatistiği:    1.93
p-değeri (iki yönlü): 0.0537
α=0.05'e göre karar: H0 reddedilemez
z=1.93, p=0.0537 çıktı — α=0.05’in hemen üzerinde. Karar: H0 reddedilemez. Bu, önceki derslerde gördüğümüz temiz “reddedildi/reddedilmedi” örneklerinden farklı, gerçekçi bir durum: sonuç sınırda. 2.5 puanlık fark gerçek olabilir de, olmayabilir de — elimizdeki veri kesin bir karar vermeye tam yetmiyor.
Çoğu kişi “p=0.0537, 0.05’e çok yakın, demek ki neredeyse anlamlı” der ve pratikte anlamlıymış gibi davranır. Değil, çünkü α eşiği keskin bir çizgidir — 0.0537 ile 0.15 arasında “ne kadar anlamsız olduğu” açısından fark yoktur, ikisi de aynı kararı (reddedilemez) verir. Sınırda bir sonuçla karşılaşınca doğru tepki, daha fazla veri toplamaktır — eşiği gevşetmek değil.
Matematik
İki oranlı z-testinin formülü
| Sembol | Anlamı |
|---|---|
| Havuzlanmış (pooled) oran — H0 doğruyken iki grubun ortak gerçek oranının tahmini | |
| Her grubun kendi gözlemlenen oranı | |
| Her grubun örneklem büyüklüğü |
Havuzlama fikri önemli: H0 “iki grup aynı” dediği için, standart hatayı hesaplarken iki grubun ayrı oranlarını değil, birleştirilmiş oranı kullanırız — bu, testin H0 varsayımıyla tutarlı kalmasını sağlar.
Kod
z-testinin ne zaman uygun olduğuna bakalım — büyük n, merkezi limit teoreminin işe yaradığı yerdir:
z-testi ne zaman uygun?
# z-testi neden burada uygun? Çünkü n büyük (1000+1000) — merkezi limit teoremi sayesinde
# oranların farkının dağılımı Normal'e çok yakın. n küçük olsaydı t-testi tercih ederdik (15. ders).
for n_kucuk in [1000, 100, 20]:
    print(f"n={n_kucuk:>4}  →  {'z-testi uygun (n büyük)' if n_kucuk >= 30 else 't-testi tercih edilir (n küçük)'}")
n=1000 → z-testi uygun (n büyük)
n= 100 → z-testi uygun (n büyük)
n= 20 → t-testi tercih edilir (n küçük)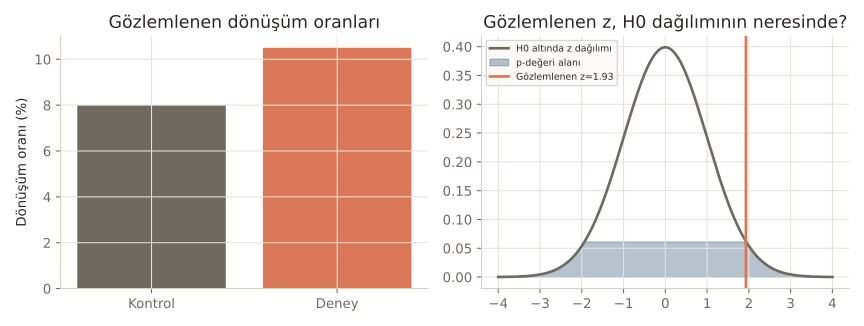
Nerede işe yarar
İki oranlı z-testi, ürün ve büyüme ekiplerinin en sık kullandığı araçlardan biridir:
- A/B testleri. Buton rengi, sayfa düzeni, fiyatlandırma gibi değişikliklerin dönüşüm oranına etkisini test etmek.
- Pazarlama kampanyaları. İki farklı e-posta başlığının açılma oranlarını karşılaştırmak.
- Ürün deneyleri. Yeni bir özelliğin kullanıcı elde tutma (retention) oranını değiştirip değiştirmediğini test etmek.
Bu 3 hatayı yaparsın:
- Örneklem küçükken (her grup için birkaç düzine gibi) z-testi kullanmak — böyle durumlarda t-testi veya kesin (exact) testler daha güvenilirdir.
- Testi “istediğin sonucu görene kadar” her gün tekrar tekrar çalıştırmak (peeking) — bu, gerçek yanlış pozitif oranını α’nın çok üzerine çıkarır.
- Sınır durumdaki bir p-değerini (0.0537 gibi) yuvarlayıp “anlamlı” ilan etmek — eşik keskindir, esnetilemez.
Kendini test et
1. İki oranlı z-testinde "havuzlanmış oran" (pooled proportion) neden kullanılır?
- Hesaplamayı basitleştirmek için, matematiksel bir gereklilik yok
- H0, iki grubun aynı gerçek orana sahip olduğunu varsaydığı için, standart hata bu ortak varsayıma göre hesaplanmalı (doğru cevap)
- Sadece büyük örneklemlerde gereklidir
- Grupların farklı büyüklükte olmasını telafi etmek için
Neden: H0'ın kendisi iki grubun aynı popülasyondan geldiğini iddia ediyor, bu yüzden standart hata hesabı da bu varsayımla tutarlı olmalı — ayrı ayrı oranlar değil, birleştirilmiş oran kullanılır.
2. p=0.0537, α=0.05 olan bir testte doğru tepki nedir?
- α'yı 0.06'ya çıkarıp "anlamlı" ilan etmek
- H0 reddedilemez sonucunu kabul etmek; gerekiyorsa daha fazla veri toplamak (doğru cevap)
- Testi farklı bir yöntemle tekrarlayıp istediğin sonucu bulana kadar denemek
- Sonucu görmezden gelmek
Neden: α eşiği önceden belirlenir ve veriye bakıldıktan sonra değiştirilmez. Sınırda bir sonuçla karşılaşınca en dürüst yol, örneklem büyüklüğünü artırıp testi tekrarlamaktır.
3. z-testi neden büyük örneklemlerde (n≥30 gibi) tercih edilir?
- Küçük örneklemlerde matematiksel olarak imkansızdır
- Merkezi limit teoremi sayesinde büyük örneklemlerde örneklem dağılımı Normal'e yeterince yakın olur (doğru cevap)
- Büyük örneklemlerde hesaplama daha hızlıdır
- z-testi sadece oranlar için, örneklem büyüklüğünden bağımsızdır
Neden: 10. derste gördüğümüz merkezi limit teoremi, büyük n'de örneklem istatistiğinin dağılımının Normal'e yaklaştığını garanti eder — z-testinin dayandığı temel budur.
Özet
Özet
- İki oranlı z-testi, iki grubun gerçek oranının aynı olup olmadığını (A/B testi gibi) test eder.
- Havuzlanmış oran, H0'ın "iki grup aynı" varsayımıyla tutarlı bir standart hata hesaplamayı sağlar.
- z-testi büyük örneklemlerde (n≥30 gibi) uygundur — merkezi limit teoremi bunu garanti eder.
- Sınır durumdaki bir p-değeri (0.05'e yakın), eşiği esnetme değil, daha fazla veri toplama sinyalidir.
- Testi tekrar tekrar çalıştırıp "istediğin sonucu bulmak" (p-hacking), gerçek yanlış pozitif oranını ciddi şekilde artırır.