

Örnekleme ve örneklem hatası
Önkoşul:Merkezi limit teoremi
Kanca
Bir şehirdeki 50.000 hanenin ortalama internet harcamasını bilmek istiyorsun ama hepsine ulaşamıyorsun — sadece 200 haneyi arayabiliyorsun. Bu 200 kişilik örneklem sana gerçeği ne kadar doğru söyler? Ve o 200 kişiyi nasıl seçtiğin, sonucu nasıl değiştirir?
Sezgi
Popülasyon, ilgilendiğin bütün birimlerin kümesidir (50.000 hane). Örneklem, bu kümeden seçtiğin küçük bir alt kümedir (200 hane). Örneklemden hesapladığın ortalama, popülasyonun gerçek ortalamasıyla neredeyse hiç bir zaman tam eşleşmez — aradaki fark örneklem hatasına denir.
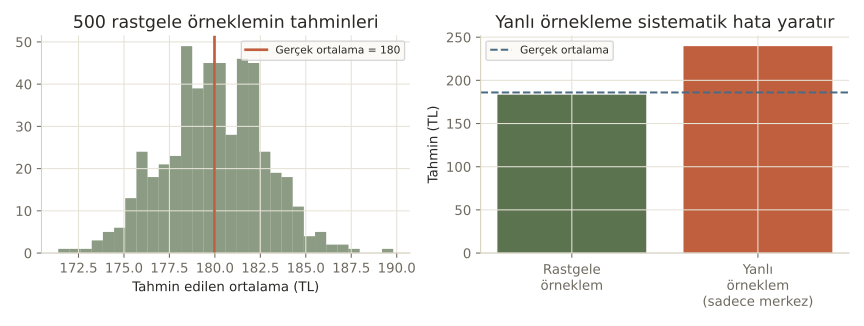
Örneklem hatası kaçınılmazdır, ama rastgele örnekleme sayesinde tahmin edilebilir ve küçültülebilir; yanlı örnekleme ise sistematik ve gizli bir hata yaratır — ne kadar büyük örneklem çeksen de düzelmez. Bu ikisi arasındaki fark, bu dersin kalbi.
Mekanizma
50.000 hanelik popülasyonu (gerçek hayatta bilemeyeceğimiz ama burada göstermek için elimizde olan) tanımlayalım:
Popülasyon (bilmediğimiz gerçek)
# Bir şehirde 50.000 hane var. Her hanenin aylık internet harcamasını (TL) BİLİYORUZ
# (gerçek hayatta bilmeyiz, ama burada teoremi göstermek için tüm popülasyonu üretiyoruz).
populasyon = rng.normal(180, 40, size=50_000)
gercek_ortalama = populasyon.mean()

print(f"Popülasyon (50.000 hane) gerçek ortalaması: {gercek_ortalama:.2f} TL")
print("Gerçek hayatta bu sayıyı bilmiyoruz — bir ÖRNEKLEM çekip tahmin ediyoruz.")
Popülasyon (50.000 hane) gerçek ortalaması: 179.98 TL
Gerçek hayatta bu sayıyı bilmiyoruz — bir ÖRNEKLEM çekip tahmin ediyoruz.Şimdi 200 haneli rastgele örneklemler çekip tahmin edelim — beş kez tekrarlayalım:
5 farklı örneklem, 5 farklı tahmin
# 200 haneli rastgele bir örneklem çekip ortalamayı tahmin edelim. Bunu 5 farklı kez yapalım.
n = 200
for deneme in range(5):
    ornek = rng.choice(populasyon, size=n, replace=False)
    tahmin = ornek.mean()
    hata = tahmin - gercek_ortalama
    print(f"Örneklem {deneme + 1}: tahmin={tahmin:.2f} TL   hata={hata:+.2f} TL")
Örneklem 1: tahmin=180.90 TL hata=+0.92 TL
Örneklem 2: tahmin=176.50 TL hata=-3.47 TL
Örneklem 3: tahmin=183.59 TL hata=+3.62 TL
Örneklem 4: tahmin=180.92 TL hata=+0.94 TL
Örneklem 5: tahmin=179.63 TL hata=-0.35 TLHer seferinde biraz farklı bir tahmin çıkıyor (+0.92, −3.47, +3.62 TL gibi hatalarla) ama hepsi gerçek değere (179.98) yakın. Bu normal ve beklenen — rastgele örneklemenin doğası bu. Şimdi kritik soruyu soralım: örneklemi nasıl seçtiğimiz önemli mi?
Rastgele vs yanlı örnekleme
# Rastgele DEĞİL, sadece şehrin merkezi (daha yüksek gelirli) mahallesinden örneklem
# çekersek ne olur? Bu, popülasyonun ilk 5000 hanesini "merkez mahalle" sayalım —
# ortalaması diğerlerinden yüksek olsun.
populasyon_yanli = populasyon.copy()
populasyon_yanli[:5000] += 60  # merkez mahalle, +60 TL daha fazla harcıyor

merkez_ornegi = populasyon_yanli[:5000][rng.choice(5000, size=n, replace=False)]
rastgele_ornek = populasyon_yanli[rng.choice(50_000, size=n, replace=False)]

print(f"\nGerçek (yeni) popülasyon ortalaması: {populasyon_yanli.mean():.2f} TL")
print(f"Sadece merkez mahalleden örneklem:    {merkez_ornegi.mean():.2f} TL   (sistematik olarak YANLI)")
print(f"Rastgele örneklem:                    {rastgele_ornek.mean():.2f} TL   (gerçeğe yakın)")
Gerçek (yeni) popülasyon ortalaması: 185.98 TL
Sadece merkez mahalleden örneklem:    239.63 TL   (sistematik olarak YANLI)
Rastgele örneklem:                    183.45 TL   (gerçeğe yakın)
Sadece şehrin merkez mahallesinden örneklem çekince tahmin 239.63 TL çıktı — gerçek ortalama olan 185.98’den çok uzak. Rastgele örneklem ise 183.45 TL — gerçeğe çok yakın. Çoğu kişi “örneklem büyüklüğü arttıkça her örnekleme yöntemi düzelir” sanır. Değil, çünkü merkez mahalleden ne kadar çok kişi seçersen seç (200 de olsa 4000 de olsa), hep aynı yanlı gruptan seçtiğin için hata sistematik kalır — büyüklük onu düzeltmez.
Matematik
Örneklem hatası ve standart hata
| Sembol | Anlamı |
|---|---|
| Popülasyonun gerçek (ve genelde bilinmeyen) ortalaması | |
| Örneklemden hesaplanan ortalama — tahminimiz | |
| Standart hata — örneklem ortalamasının, tekrar tekrar örnekleme yapılsa ne kadar değişeceğinin ölçüsü (9. derste gördük) |
Standart hata rastgele örnekleme hatasını nicelendirir — n büyüdükçe küçülür. Ama yanlılık (bias) bambaşka bir şeydir: örnekleme yönteminin kendisinden kaynaklanan, n büyüse de küçülmeyen sistematik bir sapmadır. Formülde yer almaz çünkü matematiksel değil, metodolojik bir sorundur.
Kod
Nerede işe yarar
Örnekleme kalitesi, her veri toplama sürecinin temelidir:
- Anketler ve araştırmalar. Sadece internet üzerinden ulaşılan kişilerden anket yapmak, internete erişimi olmayan grubu sistematik olarak dışlar — bu klasik bir yanlı örnekleme örneğidir.
- A/B testleri. Kullanıcıları rastgele değil de, örneğin sadece “aktif” kullanıcılardan seçmek, sonuçları gerçek kullanıcı tabanını yansıtmayan bir yöne kaydırır.
- Makine öğrenmesi eğitim verisi. Modelin eğitildiği veri, gerçek dünyadaki dağılımı yanlı temsil ediyorsa, model de o yanlılığı öğrenir — “veri sızıntısı” dersinde (2. derste) gördüğümüz sorunun kuzeni.
Bu 3 hatayı yaparsın:
- “Örneklemim büyük, o yüzden doğrudur” demek — büyüklük sadece rastgele hatayı azaltır, yanlılığı değil.
- Kolayca ulaşılabilen bir alt gruptan örneklem çekmek (“kolaylık örneklemesi”) ve bunu rastgele sanmak.
- Örneklem hatasını (kaçınılmaz, ölçülebilir) yanlılıkla (önlenebilir, metodolojik) karıştırmak.
Kendini test et
1. Örneklem büyüklüğünü artırmak hangi tür hatayı azaltır?
- Sadece yanlılığı (bias)
- Sadece rastgele örnekleme hatasını (doğru cevap)
- İkisini de eşit oranda
- Hiçbirini
Neden: Standart hata (σ/√n) örneklem büyüklüğü arttıkça küçülür, ama yanlılık örnekleme YÖNTEMİNDEN kaynaklandığı için büyüklükten etkilenmez.
2. Sadece şehrin merkez mahallesinden örneklem çekmek neden sorunlu?
- Örneklem çok küçük olduğu için
- Merkez mahalle popülasyonun geri kalanını temsil etmediği için sistematik bir sapma yaratır (doğru cevap)
- Rastgele sayı üreteci hatalı olduğu için
- Sorunlu değildir, tam tersine daha isabetlidir
Neden: Bu bir yanlı örnekleme (sampling bias) örneğidir — seçilen alt grup, incelenmek istenen popülasyonun tamamını temsil etmiyor.
3. Notebook örneğinde 5 farklı rastgele örneklem, 5 farklı (ama birbirine yakın) tahmin verdi. Bu neyi gösterir?
- Rastgele örneklemenin hatalı olduğunu
- Örneklem hatasının doğal ve beklenen bir şey olduğunu — her örneklem popülasyonu biraz farklı temsil eder (doğru cevap)
- Popülasyonun sürekli değiştiğini
- Örneklem büyüklüğünün çok küçük olduğunu
Neden: Her rastgele örneklem farklı bireyler içerir, bu yüzden tahminler biraz değişir — önemli olan bu değişimin gerçek değer etrafında olması, ki burada öyle.
Özet
Özet
- Popülasyon, incelemek istediğin bütün birimler; örneklem, bunlardan seçtiğin küçük alt küme.
- Örneklem hatası (tahmin ile gerçek arasındaki fark) rastgele örneklemede kaçınılmazdır ama n büyüdükçe küçülür.
- Yanlı örnekleme sistematik bir hatadır — büyüklükle düzelmez, sadece örnekleme YÖNTEMİNİ değiştirerek düzelir.
- Rastgele örnekleme, popülasyondaki her birimin seçilme şansının eşit (veya bilinen) olmasını garanti eder.
- Bir örneklemin ne kadar "büyük" olduğu değil, ne kadar "temsili" olduğu asıl belirleyicidir.