

t-testi
Önkoşul:z-testi ve p-değeri
Kanca
Önceki derste 2000 kişilik bir A/B testinde z-testi kullandık. Ama her deney bu kadar büyük olmuyor — bazen elinde sadece 14 kişilik bir pilot grup var. n bu kadar küçükken z-testi neden güvenilir olmaktan çıkıyor, ve yerine ne kullanmalıyız?
Sezgi
z-testi bir varsayıma dayanıyordu: popülasyonun standart sapmasını (σ) biliyoruz. Büyük örneklemde bu sorun değil çünkü örneklem std sapması (s) gerçek σ’ya çok yaklaşır. Ama n=14 gibi küçük bir örneklemde, s’nin kendisi de belirsiz — hem ortalamayı hem de standart sapmayı aynı küçük veriden tahmin ediyoruz, bu ekstra bir belirsizlik katmanı ekliyor.
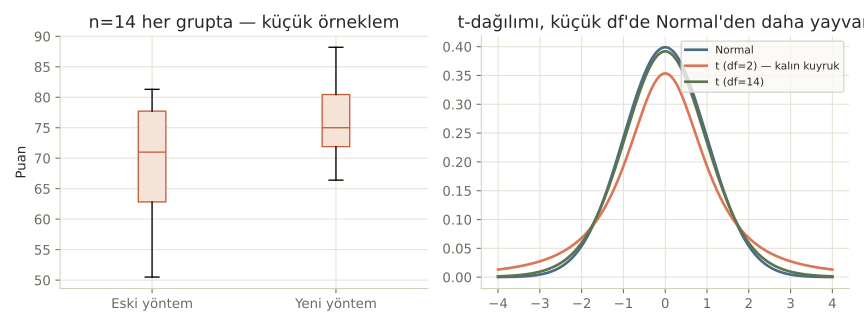
t-dağılımı, bu ekstra belirsizliği hesaba katmak için Normal dağılımdan daha “yayvan” (kalın kuyruklu) bir eğri kullanır — küçük örneklemlerde uç değerlere Normal’in öngördüğünden daha fazla olasılık tanır. Örneklem büyüdükçe t-dağılımı giderek Normal’e yaklaşır — çünkü s tahmini de giderek güvenilir hâle gelir.
Mekanizma
14 kişilik iki küçük grupla ilerleyelim: eski öğretim yöntemi ve yeni yöntem.
İki küçük grup
# Küçük bir pilot çalışma: 14 kişilik eski yöntem grubu, 14 kişilik yeni yöntem grubu.
# n küçük olduğu için popülasyon std sapmasını BİLMİYORUZ — örneklemden tahmin etmemiz gerekiyor.
eski_yontem = rng.normal(70, 10, size=14).round(1)
yeni_yontem = rng.normal(76, 10, size=14).round(1)

print("Eski yöntem puanları:", eski_yontem)
print("Yeni yöntem puanları:", yeni_yontem)
print(f"\nEski yöntem ortalaması: {eski_yontem.mean():.2f}  (n={len(eski_yontem)})")
print(f"Yeni yöntem ortalaması: {yeni_yontem.mean():.2f}  (n={len(yeni_yontem)})")
Eski yöntem puanları: [73. 59.6 77.5 79.4 50.5 57. 71.3 66.8 69.8 61.5 78.8 77.8 70.7 81.3]
Yeni yöntem puanları: [80.7 67.4 79.7 66.4 84.8 75.5 74.2 69.2 88.2 74.5 71.7 72.5 81.3 79.7]
Eski yöntem ortalaması: 69.64 (n=14)
Yeni yöntem ortalaması: 76.13 (n=14)Ortalamalar 69.64 ve 76.13 — belirgin bir fark var gibi görünüyor. Ama n=14 gibi küçük bir grupta bu şans eseri olabilir mi? Bağımsız iki örneklem t-testini uygulayalım:
Bağımsız iki örneklem t-testi
# H0: iki grubun gerçek ortalaması aynı. H1: farklı. n küçük ve popülasyon std'si bilinmediği
# için z yerine BAĞIMSIZ İKİ ÖRNEKLEM t-TESTİ kullanıyoruz.
t_istatistigi, p_degeri = stats.ttest_ind(yeni_yontem, eski_yontem)
serbestlik_derecesi = len(eski_yontem) + len(yeni_yontem) - 2

print(f"\nt istatistiği: {t_istatistigi:.2f}")
print(f"Serbestlik derecesi (df): {serbestlik_derecesi}")
print(f"p-değeri (iki yönlü): {p_degeri:.4f}")
print(f"α=0.05'e göre karar: {'H0 reddedilir' if p_degeri < 0.05 else 'H0 reddedilemez'}")
t istatistiği: 2.11
Serbestlik derecesi (df): 26
p-değeri (iki yönlü): 0.0442
α=0.05'e göre karar: H0 reddedilir
t=2.11, df (serbestlik derecesi)=26, p=0.0442 — α=0.05’in altında, H0 reddedilir. Serbestlik derecesi, kabaca “veride kaç bağımsız bilgi parçası olduğunu” gösterir — iki grubun toplam n’inden (28), her grubun kendi ortalamasını tahmin etmek için “harcanan” 2 serbestlik derecesini çıkarınca 26 kalıyor.
Çoğu kişi z-testi ile t-testinin “aynı şeyin farklı isimleri” olduğunu sanır. Değil, çünkü z-testi σ’yı bilinen bir sabit sayar, t-testi ise σ’yı da veriden tahmin edilen belirsiz bir miktar olarak ele alır — bu fark, küçük n’de sonucu gerçekten değiştirebilir.
Matematik
t-testinin formülü ve serbestlik derecesi
| Sembol | Anlamı |
|---|---|
| İki grubun örneklem ortalamaları | |
| Standart hata — iki grubun örneklem std sapmalarından hesaplanır (σ bilinmiyor) | |
| Serbestlik derecesi — t-dağılımının şeklini belirler, küçük df daha kalın kuyruk demektir |
Formül z-testine çok benzer — fark, kritik değerin z-tablosundan değil, ilgili df’ye özel bir t-tablosundan okunmasıdır. df büyüdükçe t-dağılımı Normal’e yaklaşır, kritik değerler de z’ninkilere yakınsar.
Kod
t-dağılımının df’ye göre nasıl değiştiğini doğrudan görelim:
Kritik değer, df'ye göre değişir
# t-dağılımı neden gerekli? Küçük n'de örneklem std sapmasının kendisi de belirsiz —
# bu ekstra belirsizlik, t-dağılımını Normal'den daha "kalın kuyruklu" yapar.
for df in [2, 5, 14, 100]:
    kritik_t = stats.t.ppf(0.975, df)
    print(f"df={df:>3}  %95 için kritik t değeri = {kritik_t:.3f}   (Normal'de sabit: 1.960)")
df= 2 %95 için kritik t değeri = 4.303 (Normal'de sabit: 1.960)
df= 5 %95 için kritik t değeri = 2.571 (Normal'de sabit: 1.960)
df= 14 %95 için kritik t değeri = 2.145 (Normal'de sabit: 1.960)
df=100 %95 için kritik t değeri = 1.984 (Normal'de sabit: 1.960)df=2’de %95 için kritik değer 4.303 — Normal’in sabit 1.960’ından çok daha büyük. df=100’de ise 1.984’e iniyor, neredeyse Normal’e eşit. Küçük örneklemde daha güçlü bir kanıt (daha büyük t) gerekir çünkü belirsizlik daha fazladır.
Nerede işe yarar
t-testi, “küçük örneklem, bilinmeyen popülasyon std sapması” durumunun standart aracıdır:
- Pilot çalışmalar ve erken deneyler. Tam ölçekli bir A/B testinden önce küçük bir grupla ön test yapmak.
- Tıbbi ve bilimsel araştırmalar. Katılımcı bulmanın pahalı/zor olduğu deneylerde (örn. 20 hastalık bir klinik çalışma).
- Kalite kontrol. Küçük bir üretim partisinin ortalama özelliklerini test etmek.
Bu 3 hatayı yaparsın:
- Büyük örneklemde bile z yerine t kullanmayı unutmak — aslında zararı yok (t, büyük df’de zaten Normal’e yaklaşır), ama küçük örneklemde tersi (z kullanmak) kritik değerleri olduğundan dar gösterir.
- Eşleştirilmiş (paired) veriye bağımsız t-testi uygulamak — örneğin aynı kişilerin önce/sonra ölçümlerinde, gruplar bağımsız değildir, eşleştirilmiş t-testi gerekir.
- Çok küçük n’lerde (
n < 5gibi) t-testinin normallik varsayımının kırılgan olduğunu unutmak — böyle durumlarda dağılım şeklini görsel olarak kontrol etmek şart.
Kendini test et
1. t-testi, z-testinden temel olarak hangi varsayımda ayrılır?
- t-testi sadece kesikli verilerde kullanılır
- t-testi popülasyon std sapmasını bilinmeyen kabul eder, örneklemden tahmin eder (doğru cevap)
- İkisi arasında hiçbir fark yoktur
- t-testi sadece iki grup karşılaştırmasında kullanılır, z hiç kullanılmaz
Neden: z-testi σ'yı bilinen sabit sayar; t-testi σ'yı da veriden tahmin eder ve bu ekstra belirsizliği t-dağılımının daha kalın kuyruğuyla hesaba katar.
2. Serbestlik derecesi (df) küçüldükçe t-dağılımına ne olur?
- Normal'e daha çok benzer
- Daha kalın kuyruklu (daha yayvan) hâle gelir (doğru cevap)
- Simetrisini kaybeder
- Değişmez
Neden: Küçük df, örneklemden tahmin edilen std sapmadaki belirsizliğin daha yüksek olduğu anlamına gelir; bu da dağılımın kuyruklarını kalınlaştırır.
3. df=100 civarında t-dağılımı neye çok benzer hâle gelir?
- Uniform dağılıma
- Normal dağılıma (doğru cevap)
- Poisson dağılımına
- Hiçbirine
Neden: df büyüdükçe örneklem std sapması gerçek σ'ya çok yaklaşır, bu da t-dağılımını Normal'e neredeyse özdeş hâle getirir — notebook'ta df=100 için kritik değerin 1.984'e (Normal'in 1.960'ına çok yakın) indiğini gördük.
Özet
Özet
- t-testi, popülasyon std sapması bilinmediğinde (neredeyse her zaman) ve/veya örneklem küçükken kullanılır.
- t-dağılımı, örneklemden std sapma tahmin etmenin getirdiği ekstra belirsizliği kalın kuyruklarla yansıtır.
- Serbestlik derecesi (df) küçüldükçe kritik değerler büyür — küçük örneklemde daha güçlü kanıt gerekir.
- df büyüdükçe t-dağılımı Normal'e yaklaşır; büyük örneklemde t ve z testleri neredeyse aynı sonucu verir.
- Eşleştirilmiş (önce/sonra) veriye bağımsız değil, eşleştirilmiş t-testi uygulanmalıdır.