

Merkezi limit teoremi
Önkoşul:Normal dağılımVeriye bakmak: merkez ve yayılım
Kanca
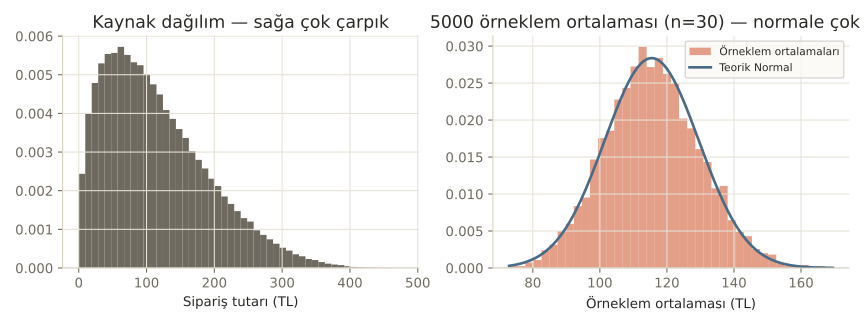
Bir e-ticaret sitesindeki sipariş tutarlarının çarpıklığı 0.83 — belirgin şekilde sağa çarpık, hiç Normal’e benzemiyor. Ama bu popülasyondan 30’arlık 5000 örneklem çekip her birinin ortalamasını hesaplarsak, ortalamaların çarpıklığı 0.15’e düşüyor — neredeyse simetrik. Kaynak veri çarpıkken, ortalamalar nasıl simetrikleşiyor?
Sezgi
Buraya kadarki derslerde her dağılımın kendine has bir şekli olduğunu gördük: Uniform düz, Log-normal ve Pareto çarpık, Normal simetrik. Ama tek bir gözlem değil de, bir grup gözlemin ortalamasını alırsan işler değişir.
Merkezi limit teoremi şunu söyler: kaynak dağılım ne şekilde olursa olsun, yeterince büyük örneklemlerin ortalamaları Normal dağılıma yaklaşır. Bunun sezgisi şu: bir örneklem ortalaması hesaplarken hem çok yüksek hem çok düşük değerler örnekleme girebilir, bunlar birbirini “dengeler” — aşırı uçlara gitme ihtimali, tek bir gözleme göre çok daha düşüktür.
Kaynak dağılım (tek tek çekilişler)
Örneklem ortalamalarının dağılımı (n=2)
- Kaynak dağılım
- Örneklem ortalamaları
- Teorik Normal(μ, σ/√n)
Kaynağın std sapması 0.286, örneklem ortalamalarının std sapması 0.192 — teorik σ/√n = 0.202.
Kaynak dağılımı “Çarpık” ya da “İki tepeli” seç — ne kadar tuhaf şekilli olursa olsun, n’i büyüttükçe sağdaki histogram bir çan eğrisine dönüşüyor.
Mekanizma
Somut sayılarla ilerleyelim. Kaynağımız: bir e-ticaret sitesindeki sipariş tutarları, belirgin şekilde sağa çarpık:
Çarpık kaynak dağılım
# Kaynak dağılım: bir e-ticaret sitesindeki sipariş tutarları. Çoğu sipariş küçük,
# birkaçı çok büyük — sağa çarpık (Pareto'ya benzer bir yapı, Beta ile üretelim).
populasyon = rng.beta(1.5, 5, size=200_000) * 500  # 0-500 TL aralığında, sağa çarpık

print(f"Popülasyon ortalaması: {populasyon.mean():.2f} TL")
print(f"Popülasyon std sapması: {populasyon.std():.2f} TL")
print(f"Çarpıklık (skewness):   {stats.skew(populasyon):.2f}  (0'dan uzaksa çarpık demektir)")
Popülasyon ortalaması: 115.47 TL
Popülasyon std sapması: 77.00 TL
Çarpıklık (skewness): 0.83 (0'dan uzaksa çarpık demektir)Şimdi bu popülasyondan 30 kişilik 5000 farklı örneklem çekip her birinin ortalamasını hesaplayalım:
5000 örneklem ortalaması
# 30'ar siparişlik 5000 farklı örneklem çekip her birinin ortalamasını hesaplayalım.
n = 30
tekrar = 5000
ornek_ortalamalari = np.array([populasyon[rng.integers(0, len(populasyon), n)].mean() for _ in range(tekrar)])

print(f"\nÖrneklem ortalamalarının ortalaması: {ornek_ortalamalari.mean():.2f}   (popülasyon ort.: {populasyon.mean():.2f})")
print(f"Örneklem ortalamalarının std sapması: {ornek_ortalamalari.std():.2f}")
print(f"Teorik: popülasyon std / sqrt(n)  = {populasyon.std() / np.sqrt(n):.2f}")
print(f"Örneklem ortalamalarının çarpıklığı: {stats.skew(ornek_ortalamalari):.2f}  (0'a çok daha yakın!)")
Örneklem ortalamalarının ortalaması: 115.73   (popülasyon ort.: 115.47)
Örneklem ortalamalarının std sapması: 14.13
Teorik: popülasyon std / sqrt(n)  = 14.06
Örneklem ortalamalarının çarpıklığı: 0.15  (0'a çok daha yakın!)
Üç şey dikkat çekici: (1) örneklem ortalamalarının ortalaması (115.73), popülasyon ortalamasına (115.47) çok yakın. (2) örneklem ortalamalarının std sapması (14.13), teorik formülle (14.06) örtüşüyor. (3) çarpıklık 0.83’ten 0.15’e düşmüş — kaynak çarpık olsa da ortalamaların dağılımı neredeyse simetrik.
Çoğu kişi “örneklem büyüklüğü arttıkça verinin kendisi normalleşir” sanır. Değil, çünkü veri hep çarpık kalır — normalleşen şey veri değil, o veriden hesapladığımız ortalamalar. Tek bir sipariş tutarı hâlâ çarpık dağılır; 30 siparişin ortalaması ise Normal’e çok yakın davranır.
Matematik
Merkezi limit teoreminin formülü
| Sembol | Anlamı |
|---|---|
| Örneklem ortalaması — n gözlemin ortalaması | |
| Popülasyonun (kaynak dağılımın) gerçek ortalaması | |
| Popülasyonun standart sapması | |
| Standart hata — örneklem ortalamalarının kendi standart sapması |
Formülün kritik noktası : örneklem büyüklüğünü 4 katına çıkarırsan, standart hata yarıya iner (çünkü ). Yani daha kesin bir tahmin için örneklem büyüklüğünü karesi kadar artırman gerekir — n’i 2 katına çıkarmak, kesinliği 2 katına çıkarmaz, sadece katına çıkarır.
Kod
n arttıkça standart hatanın nasıl küçüldüğünü doğrudan test edelim:
n arttıkça standart hata küçülür
# n arttıkça örneklem ortalamalarının std sapması nasıl küçülüyor?
for n_deneme in [2, 5, 10, 30, 100]:
    ort = np.array([populasyon[rng.integers(0, len(populasyon), n_deneme)].mean() for _ in range(2000)])
    print(f"n={n_deneme:>3}  std(ortalamalar)={ort.std():.2f}   teorik={populasyon.std() / np.sqrt(n_deneme):.2f}")
n= 2 std(ortalamalar)=55.03 teorik=54.45
n= 5 std(ortalamalar)=34.42 teorik=34.44
n= 10 std(ortalamalar)=24.20 teorik=24.35
n= 30 std(ortalamalar)=13.76 teorik=14.06
n=100 std(ortalamalar)=7.62 teorik=7.70n=2’den n=100’e çıkınca std sapma 55.03’ten 7.62’ye düşüyor — her satırda deneysel ve teorik değerler (σ/√n) neredeyse birebir örtüşüyor.
Nerede işe yarar
Merkezi limit teoremi, istatistiğin geri kalanının neden çalıştığının temelidir:
- Güven aralıkları ve hipotez testleri (11-16. dersler). Bu yöntemlerin çoğu, örneklem ortalamasının Normal dağıldığı varsayımına dayanır — kaynak veri Normal olmasa bile.
- A/B testleri. İki grubun ortalama dönüşüm oranını karşılaştırırken, her iki grubun ortalaması da (yeterince büyük örneklemde) Normal’e yaklaştığı için standart testler uygulanabilir.
- Kalite kontrol. Bir üretim hattından alınan örneklem ortalamalarının ne kadar “normal” davranacağını önceden bilmek, kontrol sınırları kurmayı mümkün kılar.
Bu 3 hatayı yaparsın:
- “n her zaman 30’dan büyük olmalı” kuralını sorgusuz uygulamak — kaynak dağılım ne kadar çarpıksa (Pareto gibi çok ağır kuyruklu), o kadar büyük n gerekir; hafif çarpıklıkta n=10 bile yeterli olabilir.
- Teoremi tek bir gözleme uygulamak — teorem ortalamalar için geçerlidir, tek bir veri noktası hiçbir zaman “normalleşmez”.
- Standart hatayı standart sapmayla karıştırmak — standart sapma verinin kendi yayılımı, standart hata ise örneklem ortalamasının ne kadar değişken olduğudur; ikincisi n büyüdükçe küçülür, birincisi küçülmez.
Kendini test et
1. Merkezi limit teoremi tam olarak ne söyler?
- Her veri kümesi büyüdükçe Normal dağılır
- Kaynak dağılım ne olursa olsun, yeterince büyük örneklemlerin ortalamaları Normal dağılıma yaklaşır (doğru cevap)
- Sadece zaten Normal olan veriler için geçerlidir
- Örneklem büyüklüğünün bir önemi yoktur
Neden: Teoremin gücü tam olarak burada: kaynak dağılım çarpık, iki tepeli, ne olursa olsun — örneklem ORTALAMALARININ dağılımı Normal'e yaklaşır, verinin kendisi değil.
2. Örneklem büyüklüğünü (n) 4 katına çıkarırsan standart hataya ne olur?
- 4 katına çıkar
- 4'te birine iner
- 2'de birine (yarısına) iner (doğru cevap)
- Değişmez
Neden: Standart hata σ/√n formülüyle hesaplanır; n 4 katına çıkınca √n 2 katına çıkar, bu yüzden standart hata yarıya iner.
3. Sağa çarpık bir kaynak dağılımdan çekilen 30'luk örneklemlerin ortalamaları hakkında ne söyleyebiliriz?
- Ortalamalar da aynı derecede çarpık olur
- Ortalamaların dağılımı kaynağa göre çok daha simetrik ve Normal'e yakın olur (doğru cevap)
- Ortalamalar hesaplanamaz
- n=30 hiçbir zaman yeterli değildir
Neden: Notebook'taki örnekte tam olarak bunu gördük: kaynak çarpıklığı 0.83 iken, 30'luk örneklem ortalamalarının çarpıklığı 0.15'e düştü — merkezi limit teoreminin beklediği gibi.
Özet
Özet
- Merkezi limit teoremi: kaynak dağılım ne olursa olsun, örneklem ortalamalarının dağılımı n büyüdükçe Normal'e yaklaşır.
- Normalleşen veri değil, verinin ortalamasıdır — tek bir gözlem hiçbir zaman normalleşmez.
- Örneklem ortalamalarının std sapmasına standart hata denir: σ/√n.
- Standart hatayı yarıya indirmek için örneklem büyüklüğünü 4 katına çıkarman gerekir (√n ilişkisi).
- Bu teorem, güven aralığı ve hipotez testi gibi ileride göreceğimiz yöntemlerin temel dayanağıdır.