

Pareto
Önkoşul:Log-normal
Kanca
10.000 oyunculu bir mobil oyunda uygulama içi harcamaları simüle ettik: en yüksek harcayan tek bir oyuncu 6185.98 TL harcamış, ama medyan sadece 7.92 TL. En çok harcayan %20’lik dilim, toplam gelirin %59.2’sini oluşturuyor. Bu “80/20 kuralı” dediğimiz şeyin ta kendisi — ama neden bu kadar sık, bu kadar farklı alanda karşımıza çıkıyor?
Sezgi
Log-normal’de gördüğümüz çarpıklık zaten “ortalama medyandan büyük” seviyesindeydi. Pareto bunu bir adım öteye taşır: kuyruk o kadar ağırdır ki, en uçtaki birkaç değer toplamın büyük bir kısmını oluşturabilir. Bir oyunda oyuncuların çoğu hiç veya az harcar, ama “balina” denen birkaç oyuncu devasa harcamalar yapar — ve bu birkaç kişi toplam gelirin yarısından fazlasını oluşturabilir.
Pareto dağılımı, bir alt sınırın (xm) üzerinde, büyük değerlerin küçük değerlere göre “yavaş sönen” bir olasılıkla devam ettiği durumları modeller. Bu yavaş sönme, Normal veya Log-normal’in kuyruğundan çok daha ağırdır.
- PDF — olasılık yoğunluğu
- CDF — birikimli olasılık
Eşiğin (80) üzerinde kalma olasılığı: %1.6
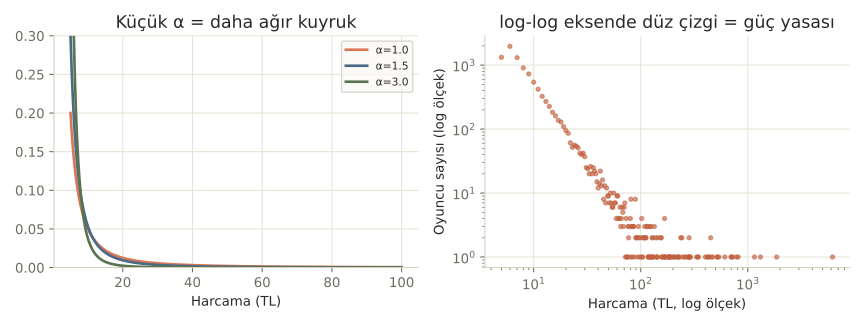
α (şekil parametresi) küçüldükçe kuyruk daha da ağırlaşıyor — çok büyük değerlerin olasılığı Normal’de olduğu gibi hızla sıfıra inmiyor.
Mekanizma
Oyuncu harcamalarını simüle edelim: alt sınır xm=5 TL, kuyruk ağırlığı α=1.5.
10.000 oyuncu harcaması
# Bir mobil oyunda 10.000 oyuncunun uygulama içi harcamasını (TL) simüle edelim.
# En az xm=5 TL harcayan biri "harcama yapan" sayılıyor; çoğu az harcar, azı çok harcar.
xm, alpha = 5, 1.5  # xm: alt sınır, alpha: kuyruğun ağırlığı (küçük alpha = daha ağır kuyruk)
u = rng.random(10_000)
harcamalar = xm / (1 - u) ** (1 / alpha)  # ters CDF örneklemesi

print(f"Ortalama harcama: {harcamalar.mean():.2f} TL")
print(f"Medyan harcama:   {np.median(harcamalar):.2f} TL")
print(f"En yüksek harcama: {harcamalar.max():.2f} TL")
print(f"En düşük harcama:  {harcamalar.min():.2f} TL")
Ortalama harcama: 15.18 TL
Medyan harcama: 7.92 TL
En yüksek harcama: 6185.98 TL
En düşük harcama: 5.00 TLOrtalama (15.18 TL), medyanın (7.92 TL) neredeyse iki katı — ve en yüksek harcama (6185.98 TL), medyanın 780 katı. Şimdi ünlü 80/20 kuralını doğrudan test edelim:
Gelir yoğunlaşması
# Ünlü "80/20 kuralı": en çok harcayan oyuncuların küçük bir kısmı, toplam gelirin
# büyük kısmını oluşturur mu?
siralanmis = np.sort(harcamalar)[::-1]  # büyükten küçüğe
toplam = siralanmis.sum()

for yuzde in [1, 5, 10, 20]:
    n_ust = int(len(siralanmis) * yuzde / 100)
    pay = siralanmis[:n_ust].sum() / toplam
    print(f"En yüksek harcayan %{yuzde:>2}, toplam gelirin %{pay * 100:.1f}'ini oluşturuyor")
En yüksek harcayan % 1, toplam gelirin %22.6'ini oluşturuyor
En yüksek harcayan % 5, toplam gelirin %38.1'ini oluşturuyor
En yüksek harcayan %10, toplam gelirin %47.5'ini oluşturuyor
En yüksek harcayan %20, toplam gelirin %59.2'ini oluşturuyorEn yüksek harcayan %20, toplam gelirin %59.2’sini oluşturuyor — klasik “80/20”den biraz farklı ama aynı mantık: küçük bir azınlık, büyük bir çoğunluğu oluşturuyor. α’yı küçültürsen (kuyruk ağırlaşırsa) bu yoğunlaşma daha da keskinleşir.
Çoğu kişi “80/20 kuralı her zaman tam %80-%20 çıkar” sanır. Değil, çünkü bu sadece Pareto ailesindeki belirli bir α değeri için yaklaşık doğru bir gözlemdir — gerçek oran, verinin α parametresine göre değişir; önemli olan oran değil, yoğunlaşmanın var olması.
Matematik
Pareto dağılımının formülü
| Sembol | Anlamı |
|---|---|
| Alt sınır — dağılımın altında hiç değer olmayan eşik (min. harcama 5 TL) | |
| Şekil parametresi — küçüldükçe kuyruk ağırlaşır, büyüdükçe kuyruk incelir | |
| Hayatta kalma fonksiyonu — bu eşitliğin kapalı ve basit bir formda olması Pareto’yu ayırt eder |
Pareto’nun imzası, log-log eksende (hem x hem y ekseni logaritmik) çizildiğinde düz bir çizgi olarak görünmesidir — çünkü ‘nın logaritması, ‘in doğrusal bir fonksiyonudur. Gerçek dünya verisinde bu düz çizgiyi görürsen, güç yasası (Pareto benzeri) bir süreçle karşı karşıyasın demektir.
Kod
Eşik olasılıkları
dagilim = stats.pareto(b=alpha, scale=xm)

p_50den_fazla = 1 - dagilim.cdf(50)
p_10dan_fazla = 1 - dagilim.cdf(10)

print(f"\nP(harcama > 10 TL) = {p_10dan_fazla:.4f}")
print(f"P(harcama > 50 TL) = {p_50den_fazla:.4f}")
P(harcama > 10 TL) = 0.3536
P(harcama > 50 TL) = 0.0316
P(harcama > 10 TL) = %35.36, P(harcama > 50 TL) hâlâ %3.16 — Normal veya Log-normal’de bu kadar uzak bir değerin olasılığı çok daha hızlı sıfıra iner. Pareto’nun “kalın kuyruğu” tam olarak bunu ifade ediyor.
Nerede işe yarar
Pareto, “az sayıda büyük, çok sayıda küçük” yapısının olduğu her yerde karşına çıkar:
- Ürün ve gelir analitiği. Kullanıcı başına gelir (ARPU), “balina” oyuncular, en çok satan ürünlerin toplam satıştaki payı.
- Şehir ve ağ bilimi. Şehir nüfusları, web sitesi trafiği, sosyal ağlarda takipçi sayıları.
- Dil ve bilgi. Bir metindeki kelime frekansları (Zipf yasası, Pareto’nun yakın akrabası).
Bu 3 hatayı yaparsın:
- Ağır kuyruklu veride ortalamayı “tipik değer” olarak kullanmak — birkaç uç değer ortalamayı anlamsız hâle getirebilir; medyan veya yüzdelik dilimler çok daha güvenilir.
- Küçük bir örneklemden α’yı tahmin edip genellemek — kuyruk davranışı az sayıda uç gözlemle belirlendiği için tahmin çok değişken olabilir.
- Her çarpık dağılımı Pareto sanmak — Log-normal de sağa çarpıktır ama kuyruğu Pareto kadar ağır değildir; log-log grafikte düz çizgi testiyle ayırt edilir.
Kendini test et
1. Pareto dağılımının Log-normal'den en belirgin farkı nedir?
- Pareto her zaman simetriktir
- Pareto'nun kuyruğu çok daha ağırdır — uç değerlerin olasılığı daha yavaş söner (doğru cevap)
- Log-normal sadece kesikli veride kullanılır
- İkisi arasında pratikte fark yoktur
Neden: Her ikisi de sağa çarpık olsa da Pareto'nun kuyruğu güç yasasıyla söner (çok daha yavaş), Log-normal'in kuyruğu üstel olarak sönmeye devam eder — bu yüzden Pareto'da aşırı uç değerler çok daha olasıdır.
2. Bir veri kümesini log-log eksende çizince yaklaşık düz bir çizgi elde ediyorsan bu ne anlama gelir?
- Veri Normal dağılıyor
- Veri bir güç yasasına (Pareto benzeri) uyuyor olabilir (doğru cevap)
- Veri hatalı toplanmış
- Hiçbir anlamı yoktur
Neden: Pareto'nun hayatta kalma fonksiyonu log-log eksende doğrusaldır; gerçek veride bu düzlük görülürse güç yasası davranışının bir işaretidir.
3. "En yüksek harcayan %20, gelirin %59'unu oluşturuyor" bulgusu neyi gösterir?
- Verinin hatalı olduğunu
- Gelirin küçük bir azınlıkta yoğunlaştığını — Pareto tipi bir dağılımın tipik sonucu (doğru cevap)
- Herkesin eşit harcadığını
- Ortalamanın medyana eşit olduğunu
Neden: Bu tam olarak Pareto dağılımının beklenen sonucudur: ağır kuyruk, gelirin/değerin küçük bir üst dilimde yoğunlaşmasına yol açar.
Özet
Özet
- Pareto, bir alt sınırın (xm) üzerinde ağır kuyruklu değerleri modeller — büyük değerlerin olasılığı yavaş söner.
- α (şekil parametresi) küçüldükçe kuyruk ağırlaşır, uç değerler daha olası hâle gelir.
- "80/20 kuralı", Pareto tipi dağılımların gelir/değer yoğunlaşmasının popüler bir yansımasıdır — kesin oran α'ya bağlıdır.
- Log-log eksende düz çizgi, güç yasası (Pareto benzeri) davranışın karakteristik imzasıdır.
- Ağır kuyruklu veride ortalama yanıltıcıdır — medyan ve yüzdelik dilimler tercih edilmelidir.