

Veriye bakmak: merkez ve yayılım
Kanca
12 kişilik bir sınıfın sınav ortalaması 57.4. Öğretmen “sınıf zayıf” diye düşünüyor. Ama puanlara tek tek bakınca 11 öğrencinin 58-65 arasında olduğunu, sadece birinin 18 aldığını görüyorsun. O tek öğrenci ortalamayı nereden nereye çekti, ve sınıfı gerçekten temsil eden sayı hangisi?
Sezgi
Bir grup sayıyı tek bir sayıyla özetlemek istediğinde iki soru sorarsın: “Merkez nerede?” ve “Sayılar bu merkezden ne kadar dağılmış?” Birincisine cevap ortalama, medyan veya mod; ikincisine cevap varyans, standart sapma veya çeyrekler açıklığı (IQR).
Bu üç merkez ölçüsü aynı şeyi söylemez. Ortalama her sayıyı hesaba katar, medyan sadece sırayı önemser — bu yüzden aykırı bir değer ortalamayı sürükler ama medyanı sarsmaz. 18 alan öğrenciyi çıkarıp tekrar hesaplarsan ortalama 57.4’ten 61.0’a fırlar, ama medyan zaten 60.5’ten 61.0’a — neredeyse kıpırdamadan — gider.
Mekanizma
Sınıfın puanlarına bak: 61, 58, 64, 60, 59, 63, 62, 58, 65, 60, 18, 61.
- Ortalamayı hesapla. Tüm puanları topla, 12’ye böl → 57.4. Tek bir düşük puan (18), 11 kişinin yükselttiği toplamı aşağı çekiyor.
- Medyanı bul. Puanları küçükten büyüğe diz, ortadaki iki değerin (12 çift sayı olduğu için) ortalamasını al → 60.5. 18, sıralamanın en ucunda kaldığı için medyanı neredeyse hiç etkilemedi.
- Modu bul. En sık tekrar eden değer 58 — iki öğrenci tam 58 almış.
- Yayılımı ölç. Standart sapma 12.6 — bu da aykırı değerden şişmiş durumda. IQR (çeyrekler açıklığı, Q3 − Q1) ise 3.5: ortadaki %50’lik dilim aslında çok sıkışık, sınıfın çoğu birbirine yakın puan almış.
Veri
# 12 kişilik bir sınıfın sınav puanları. Biri sınava hiç çalışmadan girmiş (18 puan) —
# bu tek "aykırı değer" ortalamayı nasıl etkiliyor, göreceğiz.
puanlar = np.array([61, 58, 64, 60, 59, 63, 62, 58, 65, 60, 18, 61])
print("Puanlar:", puanlar)
print("Öğrenci sayısı:", len(puanlar))
Puanlar: [61 58 64 60 59 63 62 58 65 60 18 61]
Öğrenci sayısı: 12Merkez ölçüleri
ortalama = np.mean(puanlar)
medyan = np.median(puanlar)
mod = stats.mode(puanlar, keepdims=False)

print(f"Ortalama: {ortalama:.1f}")
print(f"Medyan:   {medyan:.1f}")
print(f"Mod:      {mod.mode} (kaç kez: {mod.count})")
Ortalama: 57.4
Medyan: 60.5
Mod: 58 (kaç kez: 2)Çoğu kişi “ortalama sınıfı temsil eder” sanır. Değil, çünkü ortalama her değere eşit ağırlık verir — bir aykırı değer bile onu istediği yöne çekebilir. Medyan bu çekişe karşı dayanıklıdır (sağlam / robust), çünkü sadece sıradaki yerine bakar, büyüklüğüne bakmaz.
Matematik
Formüller
| Sembol | Anlamı |
|---|---|
| ‘inci gözlem (bir öğrencinin puanı) | |
| Gözlem sayısı | |
| Ortalama | |
| Örneklem varyansı | |
| Standart sapma — varyansın kareköküyle aynı birime (puan) döner |
Varyans formülünde ‘e bölmemizin sebebi: elimizdeki 12 kişi, bütün olası öğrencilerin (popülasyon) sadece bir örneklemi. ‘e bölseydik varyansı hafifçe düşük tahmin ederdik; (Bessel düzeltmesi) bu yanlılığı giderir.
IQR ise farklı bir mantık kullanır: veriyi dörde böler (çeyrekler), ortadaki iki çeyrek arasındaki farkı alır. Uç değerlerden etkilenmez çünkü en düşük ve en yüksek %25’i zaten hesaba katmaz.
Kod
Aykırı değeri çıkarıp merkez ölçülerini yeniden hesaplayınca farkı doğrudan görüyoruz:
Yayılım ve aykırı değer testi
varyans = np.var(puanlar, ddof=1)
std = np.std(puanlar, ddof=1)
ceyrekler = np.percentile(puanlar, [25, 50, 75])
iqr = ceyrekler[2] - ceyrekler[0]

print(f"Varyans (örneklem): {varyans:.1f}")
print(f"Standart sapma:     {std:.1f}")
print(f"Çeyrekler (Q1, Q2, Q3): {ceyrekler}")
print(f"IQR (Q3 - Q1): {iqr:.1f}")

# aykırı değeri çıkarınca ortalama ve medyanın nasıl değiştiğine bak
puanlar_temiz = puanlar[puanlar != 18]
print(f"\nAykırı değersiz ortalama: {np.mean(puanlar_temiz):.1f}")
print(f"Aykırı değersiz medyan:   {np.median(puanlar_temiz):.1f}")
Varyans (örneklem): 159.0
Standart sapma: 12.6
Çeyrekler (Q1, Q2, Q3): [58.75 60.5 62.25]
IQR (Q3 - Q1): 3.5
Aykırı değersiz ortalama: 61.0
Aykırı değersiz medyan: 61.0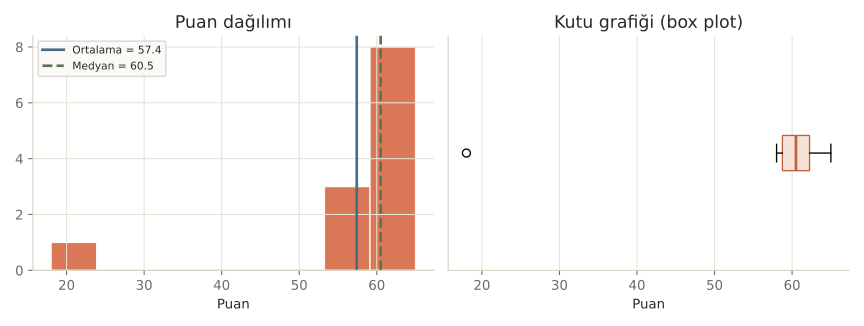
Nerede işe yarar
Bu üçlü her veri özetinde karşına çıkar:
- Gelir, fiyat, süre gibi çarpık veriler. Ev fiyatları veya maaşlarda birkaç uç değer ortalamayı anlamsızlaştırır — “ortalama maaş” yerine “medyan maaş” haber başlıklarında bu yüzden daha dürüsttür.
- A/B test sonuçlarını özetlerken. Yükleme süresi gibi metriklerde birkaç çok yavaş istek ortalamayı şişirir; medyan veya p95 gerçek kullanıcı deneyimini daha iyi yansıtır.
- Veri temizliği kararı verirken. IQR, aykırı değer tespitinde standart bir eşik olarak kullanılır (Q1 − 1.5×IQR’nin altı veya Q3 + 1.5×IQR’nin üstü).
Bu 3 hatayı yaparsın:
- Çarpık bir dağılımda körü körüne ortalama raporlamak — okuyucuyu yanıltır.
- Standart sapmayı yorumlarken birimini unutmak: 12.6 “puan” demek, 12.6 “kişi” demek değil.
- IQR’yi aralık (range = max − min) ile karıştırmak — range tek bir aykırı değerden bile etkilenir, IQR etkilenmez.
Kendini test et
1. 12 puanlık veri setinde ortalama 57.4, medyan 60.5. Bu farkın en olası nedeni nedir?
- Veri setinde aykırı bir değer var (doğru cevap)
- Medyan hesabı yanlış
- n çok küçük olduğu için ikisi hep farklı çıkar
- Standart sapma negatif
Neden: Ortalama her değeri hesaba kattığı için aykırı (çok düşük veya çok yüksek) bir değer onu belirgin şekilde çeker; medyan sıraya baktığı için etkilenmez.
2. Bir haberde "ortalama ev fiyatı" yerine "medyan ev fiyatı" verilmesi neden daha güvenilir olabilir?
- Medyan her zaman daha büyük bir sayıdır
- Az sayıda çok pahalı evin ortalamayı yukarı çekmesini engeller (doğru cevap)
- Medyan hesaplamak matematiksel olarak daha kolaydır
- İkisi arasında fark yoktur
Neden: Ev fiyatları genelde sağa çarpıktır (birkaç çok pahalı ev); medyan bu uç değerlerden etkilenmediği için "tipik" evi daha iyi temsil eder.
3. IQR ile range (max − min) arasındaki temel fark nedir?
- İkisi aynı şeyi ölçer
- IQR sadece ortadaki %50'lik dilimi kullanır, range uç noktalara bakar (doğru cevap)
- Range her zaman IQR'den küçüktür
- IQR sadece normal dağılımda hesaplanabilir
Neden: Range, en küçük ve en büyük değere dayandığı için tek bir aykırı değerden bile büyür; IQR ortadaki çeyrekleri kullandığı için aykırı değerlere karşı dayanıklıdır.
Özet
Özet
- Ortalama her değeri hesaba katar; medyan sadece sıradaki konumu önemser — bu yüzden aykırı değerlere farklı tepki verirler.
- Mod, en sık tekrarlanan değerdir; kategorik veya çok tekrarlı veride en anlamlısı odur.
- Standart sapma ve varyans, verinin ortalamadan ne kadar dağıldığını ölçer; IQR aynı işi uç değerlere karşı daha dayanıklı yapar.
- Çarpık veya aykırı değerli veride medyan ve IQR, ortalama ve standart sapmadan daha güvenilir bir özet verir.
- Bir özet istatistiği raporlamadan önce veriye mutlaka görsel olarak (histogram, kutu grafiği) bak.