

Adagrad
Önkoşul:SGD, batch, momentum
Kanca
- derste momentumun, gürültülü gradyanları YUMUŞATTIĞINI gördük — ama tüm ağırlıklara AYNI öğrenme oranını uyguluyordu. Ya bazı ağırlıklar (örn. nadir kelimelere karşılık gelenler) çok SEYREK, bazıları (yaygın kelimeler) çok SIK güncelleniyorsa? Adagrad, bu soruna cevap veren ilk “uyarlanabilir” (adaptive) optimizer.
Sezgi
Adagrad, HER ağırlık için AYRI bir öğrenme oranı tutar — ve bu oranı, o ağırlığın GEÇMİŞTEKİ gradyanlarının büyüklüğüne göre otomatik küçültür. Sık güncellenen bir ağırlık zamanla “yavaşlar”; seyrek güncellenen bir ağırlık göreli olarak “hızlı” kalır.
Optimizer yarışında Adagrad’ı (yeşil) izle — vadi yüzeyinde diğerlerinden nasıl farklı bir yörünge izliyor?
Adım: 0
SGD'nin dar vadide nasıl ZİGZAG çizdiğine, momentumun ise bu salınımı nasıl yumuşatıp hızlandırdığına dikkat et.
Mekanizma
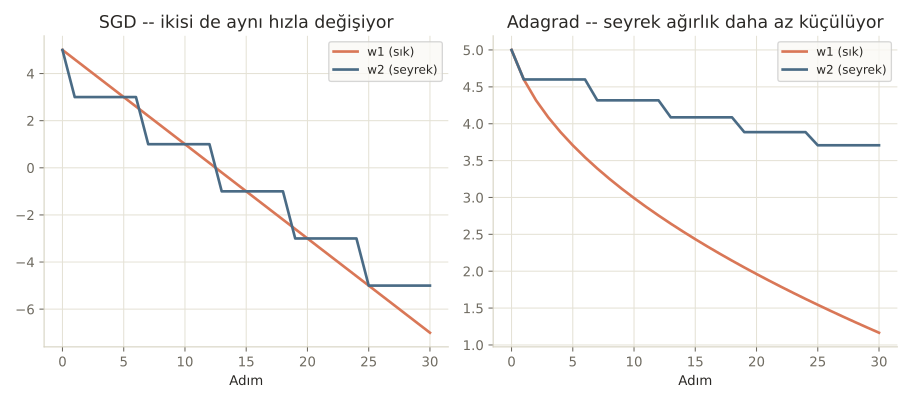
Bunu somutlaştırmak için iki ağırlık düşünelim: w1 HER adımda güncelleniyor (sık bir özellik), w2 sadece 6 adımda bir güncelleniyor (seyrek bir özellik, örn. nadir görülen bir kelime).
Sık vs seyrek özellik
# İki ağırlık: w1 HER adımda güncellenen "sık" bir özelliği, w2 SADECE 6 adımda
# bir güncellenen "seyrek" bir özelliği temsil ediyor (örn. nadir görülen bir kelime).
def egit(adagrad_kullan, adim_sayisi=30, lr=0.4):
    w1, w2 = 5.0, 5.0
    cache1, cache2 = 0.0, 0.0
    yol1, yol2 = [w1], [w2]
    for t in range(adim_sayisi):
        g1 = 1.0
        g2 = 5.0 if t % 6 == 0 else 0.0
        if adagrad_kullan:
            cache1 += g1 ** 2
            cache2 += g2 ** 2
            w1 -= lr * g1 / (np.sqrt(cache1) + 1e-8)
            w2 -= lr * g2 / (np.sqrt(cache2) + 1e-8)
        else:
            w1 -= lr * g1
            w2 -= lr * g2
        yol1.append(w1)
        yol2.append(w2)
    return yol1, yol2

yol1_sgd, yol2_sgd = egit(adagrad_kullan=False)
yol1_ada, yol2_ada = egit(adagrad_kullan=True)

print(f"SGD:     w1(sık)={yol1_sgd[-1]:.3f}, w2(seyrek)={yol2_sgd[-1]:.3f}")
print(f"Adagrad: w1(sık)={yol1_ada[-1]:.3f}, w2(seyrek)={yol2_ada[-1]:.3f}")
print("\nSGD, iki ağırlığı da AYNI sabit öğrenme oranıyla günceller -- hangisinin sık, hangisinin seyrek olduğunu 'bilmez'.")
print("Adagrad ise seyrek güncellenen w2'yi daha AZ küçültüyor (cache'i az büyüdüğü için efektif lr yüksek kalıyor).")
SGD: w1(sık)=-7.000, w2(seyrek)=-5.000
Adagrad: w1(sık)=1.166, w2(seyrek)=3.707
SGD, iki ağırlığı da AYNI sabit öğrenme oranıyla günceller -- hangisinin sık, hangisinin seyrek olduğunu 'bilmez'.
Adagrad ise seyrek güncellenen w2'yi daha AZ küçültüyor (cache'i az büyüdüğü için efektif lr yüksek kalıyor).SGD ile ikisi de BENZER şekilde küçülüyor (-7.000 ve -5.000) — SGD hangisinin sık, hangisinin seyrek olduğunu “bilmiyor”. Adagrad ile sonuç çarpıcı şekilde farklı: sık güncellenen w1 sadece 1.166’ya iniyor (küçük efektif adımlarla), seyrek w2 ise 3.707’de kalıyor (hâlâ göreli büyük adımlar alıyor). Çoğu kişi “optimizer sadece hızlandırır” sanır. Eksik, çünkü Adagrad her ağırlığa KENDİ geçmişine göre farklı davranır.
Matematik
Adagrad güncelleme kuralı
| Sembol | Anlamı |
|---|---|
| O ağırlığın TÜM geçmiş gradyanlarının kareler toplamı (“cache”) | |
| Efektif öğrenme oranı — büyüdükçe KÜÇÜLÜR | |
| Sıfıra bölmeyi önleyen küçük bir sabit (örn. ) |
SADECE artabilir (kareler toplamı) — bu yüzden efektif öğrenme oranı SADECE küçülebilir, asla büyüyemez.
Kod
Bu tek-yönlü küçülmenin somut etkisini görelim, sonra PyTorch’un torch.optim.Adagrad’ı ile doğrulayalım:
Efektif öğrenme oranının çöküşü
# Adagrad'ın "efektif öğrenme oranı" (lr / sqrt(cache)), her güncellemede KÜÇÜLÜR.
cache1 = 0.0
print("\nw1 (her adımda g=1 alan 'sık' ağırlık) için efektif öğrenme oranının çöküşü:")
for t in range(1, 31, 5):
    cache1 = t  # g1=1 sabit olduğu için cache1, adım sayısına eşit büyüyor
    efektif_lr = 0.4 / (np.sqrt(cache1) + 1e-8)
    print(f"  adım {t}: efektif_lr = {efektif_lr:.4f}")

print("\nBu çöküş, Adagrad'ın en büyük ZAYIFLIĞI: uzun eğitimlerde efektif öğrenme oranı o kadar küçülür ki öğrenme neredeyse DURUR.")
w1 (her adımda g=1 alan 'sık' ağırlık) için efektif öğrenme oranının çöküşü:
  adım 1: efektif_lr = 0.4000
  adım 6: efektif_lr = 0.1633
  adım 11: efektif_lr = 0.1206
  adım 16: efektif_lr = 0.1000
  adım 21: efektif_lr = 0.0873
  adım 26: efektif_lr = 0.0784

Bu çöküş, Adagrad'ın en büyük ZAYIFLIĞI: uzun eğitimlerde efektif öğrenme oranı o kadar küçülür ki öğrenme neredeyse DURUR.
PyTorch ile doğrulama
# PyTorch'un torch.optim.Adagrad'ı ile aynı sonucu doğrulayalım.
w1_t = torch.tensor(5.0, requires_grad=True)
w2_t = torch.tensor(5.0, requires_grad=True)
optimizer = torch.optim.Adagrad([w1_t, w2_t], lr=0.4)

for t in range(30):
    optimizer.zero_grad()
    g1 = 1.0
    g2 = 5.0 if t % 6 == 0 else 0.0
    w1_t.grad = torch.tensor(g1)
    w2_t.grad = torch.tensor(g2)
    optimizer.step()

print(f"\nPyTorch Adagrad: w1={w1_t.item():.3f}, w2={w2_t.item():.3f}")
print(f"Elle yazdığımız Adagrad: w1={yol1_ada[-1]:.3f}, w2={yol2_ada[-1]:.3f}  -- neredeyse aynı (küçük farklar epsilon uygulama detayından).")
PyTorch Adagrad: w1=1.166, w2=3.707
Elle yazdığımız Adagrad: w1=1.166, w2=3.707  -- neredeyse aynı (küçük farklar epsilon uygulama detayından).
PyTorch’un sonucu (w1=1.166, w2=3.707) elle yazdığımız versiyonla BİREBİR aynı.
Nerede işe yarar
Adagrad, özellikle SEYREK verilerde (NLP kategorisinde göreceğimiz kelime embedding’leri gibi) faydalıdır:
- Seyrek özellikli problemlerde (örn. nadir kelimeler) iyi çalışır — nadir görülen özellikler, göreli büyük güncellemeler almaya devam eder.
- Uzun eğitimlerde efektif öğrenme oranı çok küçülebilir — bu, Adagrad’ın en bilinen ZAYIFLIĞI (bir sonraki derste RMSprop bunu nasıl çözdüğünü göreceğiz).
- Pratikte RMSprop veya Adam, Adagrad’ın bu zayıflığını gidermiş halleri olarak tercih edilir — ama Adagrad, “uyarlanabilir öğrenme oranı” fikrinin temelini attı.
Bu 3 hatayı yaparsın:
- Adagrad’ı çok UZUN eğitimlerde kullanıp öğrenmenin neden durduğunu anlamamak — cache sürekli büyüdüğü için efektif lr sıfıra yaklaşır.
- “Uyarlanabilir” kelimesini duyunca öğrenme oranını hiç ayarlamaya gerek olmadığını sanmak — başlangıç hâlâ önemlidir.
- Adagrad’ı YOĞUN (dense, her özelliğin her örnekte göründüğü) verilerde kullanıp RMSprop/Adam’ın daha iyi çalışacağı bir durumu kaçırmak.
Kendini test et
1. Notebook'ta Adagrad ile w2 (seyrek güncellenen ağırlık) neden w1'den (sık güncellenen) çok daha az küçüldü?
- Rastgele bir sonuç
- w2'nin cache'i (geçmiş gradyanların karesi) çok daha AZ büyüdüğü için efektif öğrenme oranı yüksek kaldı; w1'in cache'i hızla büyüyüp efektif lr'ını küçülttü (doğru cevap)
- w2 hiç güncellenmedi
- Adagrad sadece sık güncellenen ağırlıkları etkiler
Neden: Adagrad'ın cache'i (c_t), gradyanın karesini biriktirir; sık güncellenen w1'in cache'i hızla büyüyüp efektif öğrenme oranını (η/√c_t) küçültürken, seyrek güncellenen w2'nin cache'i az büyüdüğü için efektif lr yüksek kalır.
2. Adagrad'ın en bilinen zayıflığı nedir?
- Hiçbir zaman yakınsamaz
- Cache SADECE büyüyebildiği için (kareler toplamı), efektif öğrenme oranı uzun eğitimlerde o kadar küçülür ki öğrenme neredeyse durur (doğru cevap)
- Sadece küçük veri setlerinde çalışır
- Bellekte çok yer kaplar
Neden: Cache hiç azalmadan sürekli biriktiği için efektif öğrenme oranı (η/√c_t) monoton şekilde küçülür -- uzun eğitimlerde bu, öğrenmeyi neredeyse durma noktasına getirebilir.
3. Adagrad hangi tür problemlerde özellikle faydalıdır?
- Sadece görüntü verisinde
- Seyrek özellikli problemlerde (örn. nadir kelimeler) -- nadir görülen özellikler göreli büyük güncellemeler almaya devam eder (doğru cevap)
- Sadece küçük ağlarda
- Hiçbir özel durumda avantajı yoktur
Neden: Adagrad, seyrek (nadir güncellenen) özelliklerin cache'inin yavaş büyümesi sayesinde bu özelliklere göreli olarak daha büyük güncellemeler vermeye devam eder -- bu da onu seyrek veri (örn. NLP'de nadir kelimeler) için uygun kılar.
Özet
Özet
- Adagrad, her ağırlık için AYRI ve UYARLANABİLİR bir öğrenme oranı tutar.
- Bu oran, o ağırlığın geçmiş gradyanlarının kareler toplamına (cache) göre otomatik küçülür.
- Sık güncellenen ağırlıklar zamanla yavaşlar; seyrek güncellenenler göreli hızlı kalır.
- Cache sadece büyüyebildiği için, efektif öğrenme oranı uzun eğitimlerde çok küçülebilir -- Adagrad'ın temel zayıflığı.
- Adagrad, seyrek veri (örn. nadir kelimeler) için özellikle faydalıdır; bir sonraki derste bu zayıflığı gideren RMSprop'u göreceğiz.