

Batch normalization
Önkoşul:Dropout
Kanca
- derste doğru ağırlık ilklendirmesinin, sinyali derin bir ağda canlı tutmak için ne kadar KRİTİK olduğunu gördük. Batch normalization, bu sorunu farklı bir açıdan çözüyor: ilklendirmeye GÜVENMEK yerine, her katmanda sinyali MİMARİ olarak normalize ediyor.
Sezgi
Batch normalization (BatchNorm), her nöronun çıktısını, o anki BATCH (mini-grup) boyunca ortalaması 0, standart sapması 1 olacak şekilde yeniden ölçekler. Bu, 20. dersteki “sinyal sönümleniyor veya patlıyor” sorununu, HANGİ ilklendirme kullanılırsa kullanılsın büyük ölçüde ortadan kaldırıyor.
Demo’daki “BatchNorm” sekmesini incele — her SÜTUNUN (nöronun) ortalaması 0’a çekildiğine dikkat et.
Ham aktivasyonlar düzensiz: örnekten örneğe (satır) ve nörondan nörona (sütun) çok farklı büyüklük ve merkezlerde.
Mekanizma
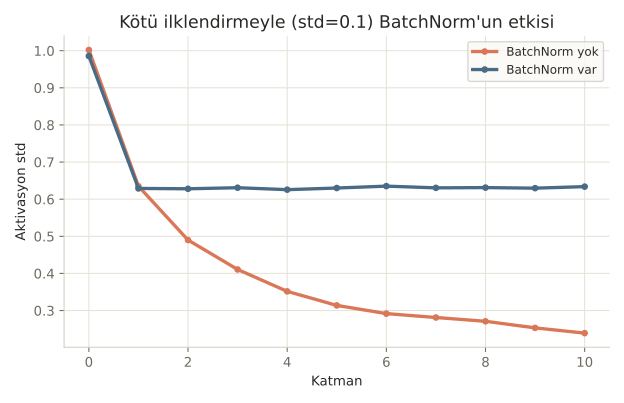
- dersteki “kötü ilklendirme” (std=0.1) senaryosunu tekrar deneyelim — ama bu kez her katmandan sonra BatchNorm ekleyelim:
BatchNorm, kötü ilklendirmeyi nasıl telafi eder
# 20. derste kötü ilklendirmenin (çok küçük std) sinyali sönümlendirdiğini görmüştük.
# BatchNorm, bunu MİMARİ seviyede çözer -- ilklendirmeden neredeyse bağımsız hale gelir.
def sinyal_yayilimi(std, katman_sayisi=10, genislik=100, batchnorm_kullan=False):
    x = torch.randn(32, genislik)  # batch boyutu = 32
    stdler = [x.std().item()]
    for _ in range(katman_sayisi):
        W = torch.randn(genislik, genislik) * std
        z = x @ W
        if batchnorm_kullan:
            z = (z - z.mean(dim=0)) / (z.std(dim=0) + 1e-5)  # BatchNorm'un ÖZÜ: her nöronu batch boyunca normalize et
        x = torch.tanh(z)
        stdler.append(x.std().item())
    return stdler

kotu_std = 0.1  # 20. dersteki "çok küçük" ilklendirme
bn_yok = sinyal_yayilimi(kotu_std, batchnorm_kullan=False)
bn_var = sinyal_yayilimi(kotu_std, batchnorm_kullan=True)

print(f"Kötü ilklendirme (std={kotu_std}), BatchNorm YOK:")
print("  " + ", ".join(f"{s:.3f}" for s in bn_yok))
print(f"\nKötü ilklendirme (std={kotu_std}), BatchNorm VAR:")
print("  " + ", ".join(f"{s:.3f}" for s in bn_var))
print("\nBatchNorm'suz sinyal 10 katmanda sürekli küçülüyor (1.00 -> 0.24).")
print("BatchNorm'lu sinyal İLK katmandan sonra SABİTLENİYOR (~0.63) -- kötü ilklendirmeyi büyük ölçüde 'affediyor'.")
Kötü ilklendirme (std=0.1), BatchNorm YOK:
1.002, 0.635, 0.490, 0.411, 0.352, 0.314, 0.292, 0.281, 0.271, 0.253, 0.239
Kötü ilklendirme (std=0.1), BatchNorm VAR:
0.986, 0.629, 0.628, 0.631, 0.626, 0.630, 0.635, 0.631, 0.631, 0.630, 0.634
BatchNorm'suz sinyal 10 katmanda sürekli küçülüyor (1.00 -> 0.24).
BatchNorm'lu sinyal İLK katmandan sonra SABİTLENİYOR (~0.63) -- kötü ilklendirmeyi büyük ölçüde 'affediyor'.BatchNorm’suz sinyal 10 katmanda sürekli küçülerek 0.239’a düşüyor. BatchNorm’lu sinyal ise İLK katmandan sonra ~0.63’te SABİTLENİYOR — katman sayısı ne olursa olsun. Çoğu kişi “doğru ilklendirmeyi bulmak eğitimin en zor kısmı” sanır. Kısmen doğru, çünkü BatchNorm, bu hassasiyeti büyük ölçüde AZALTIYOR (tamamen ortadan kaldırmıyor).
Matematik
Batch normalization formülü
| Sembol | Anlamı |
|---|---|
| O nöronun, MEVCUT batch’teki ortalaması ve varyansı | |
| Öğrenilebilir ölçek ve kaydırma parametreleri — ağ gerekirse normalizasyonu KISMEN geri alabilir | |
| Sıfıra bölmeyi önleyen küçük sabit |
ve öğrenilebilir olduğu için BatchNorm, normalizasyonu “zorunlu” kılmaz — ağ, eğer normalize edilmemiş bir dağılım daha faydalıysa, ve ile buna YAKLAŞABİLİR.
Kod
ve ‘nın başlangıç değerlerine, sonra BatchNorm’un train/eval arasındaki KRİTİK farkına bakalım:
Gamma, beta ve normalizasyon
# nn.BatchNorm1d'nin gerçek davranışına bakalım: normalize eder, sonra öğrenilebilir
# gamma (ölçek) ve beta (kaydırma) ile bu normu "geri alabilir".
bn = nn.BatchNorm1d(4)
x = torch.randn(8, 4) * 5 + 3  # büyük ölçekli, kaymış bir girdi

bn.train()
y = bn(x)
print(f"\nGirdi ortalama/std: {x.mean(0).round(decimals=2).tolist()} / {x.std(0).round(decimals=2).tolist()}")
print(f"BatchNorm çıktısı ortalama/std: {y.mean(0).round(decimals=2).tolist()} / {y.std(0).round(decimals=2).tolist()}")
print(f"\nBaşlangıçta gamma={bn.weight.data.tolist()}, beta={bn.bias.data.tolist()} -- yani normalize edilmiş hali AYNEN bırakıyor.")
print("Eğitim ilerledikçe gamma/beta öğrenilir -- ağ, gerekirse normu KISMEN geri alabilir.")
Girdi ortalama/std: [1.8899999856948853, 3.1500000953674316, 3.3299999237060547, 4.300000190734863] / [4.860000133514404, 4.559999942779541, 5.239999771118164, 6.679999828338623]
BatchNorm çıktısı ortalama/std: [-0.0, 0.0, 0.0, 0.0] / [1.0700000524520874, 1.0700000524520874, 1.0700000524520874, 1.0700000524520874]

Başlangıçta gamma=[1.0, 1.0, 1.0, 1.0], beta=[0.0, 0.0, 0.0, 0.0] -- yani normalize edilmiş hali AYNEN bırakıyor.
Eğitim ilerledikçe gamma/beta öğrenilir -- ağ, gerekirse normu KISMEN geri alabilir.
Başlangıçta , — yani ağ, henüz hiçbir şey “geri almadan” başlıyor.
running_mean/var ve batch=1 sorunu
# BatchNorm, train() modunda BATCH istatistiklerini kullanır; bunları aynı zamanda
# 'running_mean/running_var' olarak biriktirir -- eval() modunda BUNLAR kullanılır.
for _ in range(20):
    bn(torch.randn(8, 4) * 5 + 3)
print(f"\n20 forward sonrası running_mean: {bn.running_mean.round(decimals=2).tolist()}")
print(f"20 forward sonrası running_var:  {bn.running_var.round(decimals=2).tolist()}")
print("(Gerçek dağılım ortalama=3, std=5 idi -- running istatistikler bu değerlere yakınsıyor.)")

# BatchNorm, TEK bir örnekle (batch=1) train() modunda çalışamaz -- neden?
bn_test = nn.BatchNorm1d(4)
bn_test.train()
try:
    bn_test(torch.randn(1, 4))
except ValueError as hata:
    print(f"\ntrain() modunda batch=1 ile HATA: {hata}")
print("Tek örneğin std'si TANIMSIZDIR (bölme sıfıra gider) -- bu yüzden eval() modunda running stats kullanılır.")
20 forward sonrası running_mean: [2.440000057220459, 2.630000114440918, 2.4200000762939453, 2.8399999141693115]
20 forward sonrası running_var:  [21.559999465942383, 21.649999618530273, 22.84000015258789, 28.350000381469727]
(Gerçek dağılım ortalama=3, std=5 idi -- running istatistikler bu değerlere yakınsıyor.)

train() modunda batch=1 ile HATA: Expected more than 1 value per channel when training, got input size torch.Size([1, 4])
Tek örneğin std'si TANIMSIZDIR (bölme sıfıra gider) -- bu yüzden eval() modunda running stats kullanılır.
train() modunda batch=1 ile PyTorch’un kendisi hata veriyor: “Expected more than 1 value per channel” — tek bir örneğin standart sapması matematiksel olarak tanımsızdır. Bu yüzden eval() modunda, eğitim boyunca biriktirilen running_mean/running_var kullanılır.
Nerede işe yarar
BatchNorm, özellikle CNN’lerde (bir sonraki bölüm) konvolüsyon katmanlarından sonra standart bir bileşendir:
nn.BatchNorm1d/2d/3d, girdinin boyutuna göre seçilir (1d: vektörler, 2d: görüntüler, 3d: video/3B veri).- BatchNorm, batch boyutuna DUYARLIDIR — çok küçük batch’lerde (örn. 2-4) istatistikler gürültülü olur, performansı düşürebilir.
model.eval()çağırmayı unutmak burada da (dropout gibi, 22. ders) kritik — aksi halde model, tek bir örnek üzerinde hata bile verebilir.
Bu 3 hatayı yaparsın:
- Çok küçük batch boyutuyla (örn. 2) BatchNorm kullanıp gürültülü istatistiklerin eğitimi bozmasına izin vermek — bu durumda Layer normalization (24. ders) daha uygun olabilir.
model.eval()çağırmadan tek bir örnek üzerinde tahmin yapmaya çalışıp hata almak.- BatchNorm’un HER sorunu çözdüğünü sanıp doğru ilklendirmeyi (20. ders) tamamen göz ardı etmek — BatchNorm hassasiyeti azaltır, ortadan kaldırmaz.
Kendini test et
1. Notebook'ta kötü ilklendirmeyle (std=0.1) BatchNorm eklenince sinyal neden 'sabitlendi' (küçülmeye devam etmedi)?
- Rastgele bir sonuç
- BatchNorm, HER katmanın çıktısını batch boyunca yeniden ölçekleyerek ortalama 0, std 1'e getiriyor -- bu da önceki katmanların ilklendirme hatasının BİRİKMESİNİ engelliyor (doğru cevap)
- BatchNorm ağırlıkları sıfırlıyor
- BatchNorm sadece ilk katmanı etkiliyor
Neden: Her katmandan sonra sinyal yeniden normalize edildiği için, bir önceki katmandaki ölçek hatası bir SONRAKİ katmana taşınmıyor -- bu da katman sayısından bağımsız, stabil bir sinyal büyüklüğü sağlıyor.
2. PyTorch neden train() modunda batch=1 ile BatchNorm'a hata veriyor?
- Bir yazılım hatası (bug)
- BatchNorm, batch boyunca hesaplanan standart sapmayı kullanır -- tek bir örneğin standart sapması matematiksel olarak tanımsızdır (doğru cevap)
- PyTorch batch=1'i hiç desteklemiyor
- Bellek yetersiz kalıyor
Neden: BatchNorm'un train modundaki normalizasyonu batch istatistiklerine (μ_B, σ_B²) dayanır; tek bir örnekle varyans hesaplanamaz (0'a bölme) -- bu yüzden PyTorch açıkça bir hata fırlatır.
3. γ (gamma) ve β (beta) öğrenilebilir parametrelerinin BatchNorm'daki rolü nedir?
- Hiçbir işlevleri yok, sadece dekoratif
- Ağın, gerekirse normalize edilmiş (ortalama 0, std 1) dağılımı KISMEN geri almasına izin verir -- normalizasyon "zorunlu" değildir (doğru cevap)
- Sadece görselleştirme için kullanılır
- Öğrenme oranını kontrol ederler
Neden: γ ve β, normalize edilmiş çıktıyı (y=γ·ẑ+β) yeniden ölçekleyip kaydırabilir; eğer normalize edilmemiş bir dağılım ağ için daha faydalıysa, eğitim sırasında γ ve β bu yönde öğrenilebilir.
Özet
Özet
- BatchNorm, her nöronun çıktısını batch boyunca ortalama 0, std 1 olacak şekilde normalize eder.
- Bu, kötü ağırlık ilklendirmesinin (20. ders) etkisini büyük ölçüde azaltır -- sinyal derinlikten bağımsız stabil kalır.
- Öğrenilebilir γ ve β parametreleri, ağın normalizasyonu gerekirse kısmen geri almasına izin verir.
- train() modunda batch istatistikleri, eval() modunda ise biriktirilen running_mean/running_var kullanılır.
- BatchNorm, çok küçük batch boyutlarında gürültülü olabilir -- bu durumda Layer normalization (24. ders) tercih edilebilir.