

Aktivasyon fonksiyonu özet kartı
Önkoşul:Softmax
Kanca
6-9. derste dört aktivasyon fonksiyonunu tek tek inceledik. Bu kısa derste hepsini yan yana koyup, “hangisini ne zaman seçmeli” sorusuna net bir cevap verelim.
Sezgi
Dört fonksiyonun da aynı işi yapıyor gibi görünebilir — bir sayıyı başka bir sayıya dönüştürmek. Ama az önce gördüğümüz gibi, DETAYLAR (doygunluk, sıfır merkezlilik, negatif bölge davranışı) pratikte büyük fark yaratıyor.
f(x) f'(x) doygunluk bölgesi (|f'(x)| < 0.02)
“Üst üste bindir” kutusunu işaretleyip dört fonksiyonu birlikte karşılaştır: sigmoid ve tanh’ın S şekli, ReLU’nun keskin köşesi, GELU’nun ReLU’ya yakın ama yumuşak geçişi.
Mekanizma
Dört fonksiyonu tek bir tabloda özetleyelim:
Özet karşılaştırma tablosu
# 6-9. derslerde tek tek incelediğimiz 4 fonksiyonu, YAN YANA özetleyelim.
fonksiyonlar = {"Sigmoid": (sigmoid, sigmoid_turev), "TanH": (tanh, tanh_turev), "ReLU": (relu, relu_turev)}
x_test = np.array([-5.0, 0.0, 5.0])

print(f"{'Fonksiyon':<10} {'Çıktı aralığı':<16} {'Maks. türev':<12} {'x=-5 türev':<12} {'x=5 türev':<10}")
for ad, (f, fp) in fonksiyonlar.items():
    cikti_araligi = f"({f(-100):.0f}, {f(100):.0f})" if ad != "ReLU" else "[0, ∞)"
    maks_turev = fp(np.linspace(-10, 10, 1000)).max()
    print(f"{ad:<10} {cikti_araligi:<16} {maks_turev:<12.3f} {fp(-5):<12.5f} {fp(5):<10.5f}")
Fonksiyon Çıktı aralığı Maks. türev x=-5 türev x=5 türev
Sigmoid (0, 1) 0.250 0.00665 0.00665
TanH (-1, 1) 1.000 0.00018 0.00018
ReLU [0, ∞) 1.000 0.00000 1.00000 GELU'yu tabloya ekleyelim
gelu_turev_sayisal = lambda x, h=1e-4: (gelu(x + h) - gelu(x - h)) / (2 * h)
print(f"\n{'GELU':<10} {'(yaklaşık ReLU)':<16} {'~1.0':<12} {gelu_turev_sayisal(-5):<12.5f} {gelu_turev_sayisal(5):<10.5f}")
print("GELU, negatif bölgede ReLU'dan farklı olarak TAM sıfıra inmiyor (ama çok küçük).")
GELU       (yaklaşık ReLU)  ~1.0         -0.00000     1.00000
GELU, negatif bölgede ReLU'dan farklı olarak TAM sıfıra inmiyor (ama çok küçük).
Dikkat: ReLU’nun x=-5’teki türevi 0.00000 (tam sıfır) iken GELU’nunki -0.00000 (çok küçük ama sıfır değil). Bu iki sayı görsel olarak neredeyse aynı görünüyor, ama 8. dersten hatırlarsak aralarındaki fark ÇOK önemli: biri kalıcı “ölüm” demek, diğeri (çok yavaş da olsa) toparlanma ihtimali demek. Çoğu kişi “bu kadar küçük sayılar arasındaki fark önemsizdir” sanır. Değil, çünkü sıfır ile sıfıra-yakın arasındaki fark, bir optimizasyon algoritması için “asla” ile “belki, çok uzun sürede” arasındaki farktır.
Matematik
Dört fonksiyonun formülleri, bir arada
| Fonksiyon | Çıktı aralığı | Maks. türev | Ana avantajı | Ana riski |
|---|---|---|---|---|
| Sigmoid | (0, 1) | 0.25 | Olasılık üretir | Şiddetli doygunluk |
| TanH | (-1, 1) | 1.0 | Sıfır merkezli | Doygunluk (daha hafif) |
| ReLU | [0, ∞) | 1.0 | Doygunluk yok (pozitifte) | Ölü nöron riski |
| GELU | ≈ReLU | ≈1.0 | Ölü nöron riski düşük | Hesaplama biraz daha pahalı |
Kod
Pratik bir karar rehberi:
Hangi durumda hangisi?
print("\nHangi aktivasyonu ne zaman kullanmalı?")
print("  Gizli katmanlar (CNN, standart ağlar) -> ReLU (hızlı, kaybolan gradyan riski düşük)")
print("  Gizli katmanlar (transformer tabanlı büyük modeller) -> GELU (ölü nöron riski daha düşük)")
print("  Çıktı katmanı, ikili sınıflandırma -> Sigmoid (0-1 arası TEK olasılık)")
print("  Çıktı katmanı, çok sınıflı sınıflandırma -> Softmax (toplamı 1 olan dağılım)")
print("  RNN/LSTM kapıları -> Sigmoid veya TanH (tarihsel olarak, sekans modellerinde yaygın)")
Hangi aktivasyonu ne zaman kullanmalı?
  Gizli katmanlar (CNN, standart ağlar) -> ReLU (hızlı, kaybolan gradyan riski düşük)
  Gizli katmanlar (transformer tabanlı büyük modeller) -> GELU (ölü nöron riski daha düşük)
  Çıktı katmanı, ikili sınıflandırma -> Sigmoid (0-1 arası TEK olasılık)
  Çıktı katmanı, çok sınıflı sınıflandırma -> Softmax (toplamı 1 olan dağılım)
  RNN/LSTM kapıları -> Sigmoid veya TanH (tarihsel olarak, sekans modellerinde yaygın)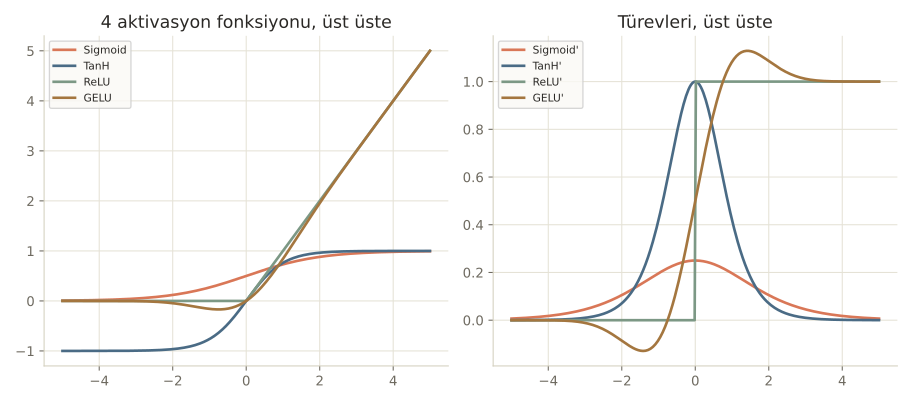
Nerede işe yarar
Bu özet, sonraki bölümlerde referans olarak kullanacağımız bir “karar tablosu”:
- CNN’lerde (bir sonraki bölüm) varsayılan olarak ReLU. Basit, hızlı, çoğu durumda yeterli.
- Transformer’larda (NLP kategorisi) varsayılan olarak GELU. Büyük modellerde ölü nöron riskini azaltmak önemli.
- Çıktı katmanında görevin GEREKTİRDİĞİ fonksiyon. İkili sınıflandırma → sigmoid, çok sınıflı → softmax, regresyon → genelde aktivasyonsuz (doğrusal).
Bu 3 hatayı yaparsın:
- Her problemde “en popüler” aktivasyonu düşünmeden kullanmak — bağlam (gizli katman mı çıktı katmanı mı, ne kadar derin) seçimi belirlemeli.
- Çıktı katmanına yanlış aktivasyon koymak — örneğin regresyon çıktısına sigmoid koymak, tahminleri yanlışlıkla (0,1) aralığına sıkıştırır.
- Aktivasyon seçimini “küçük bir detay” sanmak — 5-8. derste gördüğümüz gibi, bu seçim modelin EĞİTİLEBİLİR olup olmadığını doğrudan etkileyebilir.
Kendini test et
1. ReLU'nun x=-5'teki türevi (0.00000) ile GELU'nunki (-0.00000) arasındaki fark neden önemli?
- Önemli değil, ikisi de pratikte aynı
- ReLU'nun türevi TAM sıfırdır (o nokta asla güncellenemez), GELU'nunki ise sıfıra çok yakın ama FARKLI (o nokta, çok yavaş da olsa toparlanabilir) (doğru cevap)
- GELU her zaman daha büyük türev verir
- ReLU asla sıfır türev vermez
Neden: 8. dersteki ölü ReLU konusunu hatırla: tam sıfır ile sıfıra-çok-yakın arasındaki fark, "kalıcı olarak asla güncellenmez" ile "gradyan inişiyle toparlanabilir" arasındaki farktır.
2. Regresyon (sürekli bir sayı tahmini) yapan bir modelin çıktı katmanında hangi aktivasyon genelde YANLIŞ olur?
- Aktivasyonsuz (doğrusal) katman
- Sigmoid -- çünkü tahminleri yanlışlıkla (0,1) aralığına sıkıştırır, oysa regresyon hedefi bu aralıkta olmayabilir (doğru cevap)
- ReLU her zaman doğrudur
- Hiçbiri yanlış olamaz
Neden: Sigmoid çıktıyı zorla (0,1) aralığına sıkıştırır; regresyon hedefi (örn. bir ev fiyatı) bu aralığın dışında olabileceği için bu YANLIŞ bir seçim olur -- doğrusal (aktivasyonsuz) çıktı genelde doğrudur.
3. Bu özet tablosuna göre, modern transformer tabanlı büyük dil modellerinde gizli katmanlarda genelde hangi aktivasyon tercih edilir?
- Sigmoid
- TanH
- ReLU
- GELU (doğru cevap)
Neden: GELU, ölü nöron riskinin ReLU'ya göre daha düşük olması nedeniyle, büyük transformer tabanlı modellerde standart hale gelmiştir.
Özet
Özet
- Sigmoid, tanh, ReLU ve GELU, farklı doygunluk ve sıfır-merkezlilik özellikleriyle farklı ihtiyaçlara hizmet eder.
- Çok küçük görünen türev farkları (tam sıfır vs sıfıra yakın), eğitim dinamiklerinde büyük fark yaratabilir.
- Gizli katmanlarda genelde ReLU veya GELU, çıktı katmanında görevin gerektirdiği fonksiyon (sigmoid/softmax/doğrusal) tercih edilir.
- Aktivasyon seçimi, modelin eğitilebilir olup olmadığını doğrudan etkileyen bir mimari karardır.
- Bu özet tablo, sonraki bölümlerde (CNN, transformer) referans olarak kullanılacak.