

ReLU ve GELU
Önkoşul:TanH
Kanca
- derste ReLU’nun kaybolan gradyan problemini “çözdüğünü” gördük — pozitif bölgede türevi hep 1. Ama bu çözüm, kendi yeni bir sorununu da beraberinde getiriyor. Bu ders, o sorunu ve modern bir çözümünü (GELU) inceliyor.
Sezgi
ReLU (Rectified Linear Unit), negatif girdileri sıfıra kırpan, pozitif girdileri OLDUĞU GİBİ geçiren basit bir fonksiyondur. Pozitif bölgedeki türevi tam olarak 1 (doygunluk yok), ama NEGATİF bölgede türev tam olarak SIFIR. Bir nöron sürekli negatif bölgede “sıkışırsa”, gradyanı SONSUZA kadar sıfır kalır — buna “ölü ReLU” (dying ReLU) denir.
f(x) f'(x) doygunluk bölgesi (|f'(x)| < 0.02)
“ReLU” sekmesine geç: x<0 bölgesinde f(x) düz sıfır çizgisinde, f’(x) de aynı bölgede sıfırda yapışık. “GELU” sekmesine geçince, negatif bölgenin ARTIK tam düz olmadığını, hafifçe eğrildiğini gör.
Mekanizma
Önce ReLU’nun temel davranışını görelim:
ReLU ve türevi
def relu(x):
    return np.maximum(0, x)

def relu_turev(x):
    return (x > 0).astype(float)

x_degerleri = np.array([-5, -2, -0.5, 0.5, 2, 5])
print(f"{'x':>6} {'ReLU(x)':>10} {'ReLU türevi':>12}")
for x in x_degerleri:
    print(f"{x:>6} {relu(x):>10.2f} {relu_turev(x):>12.1f}")
print("\nPozitif bölgede türev TAM OLARAK 1 (5. dersteki kaybolan gradyanı çözen şey budur).")
print("Ama NEGATİF bölgede türev TAM OLARAK 0 -- bu da yeni bir soruna kapı açıyor.")
x ReLU(x) ReLU türevi
-5.0 0.00 0.0
-2.0 0.00 0.0
-0.5 0.00 0.0
0.5 0.50 1.0
2.0 2.00 1.0
5.0 5.00 1.0
Pozitif bölgede türev TAM OLARAK 1 (5. dersteki kaybolan gradyanı çözen şey budur).
Ama NEGATİF bölgede türev TAM OLARAK 0 -- bu da yeni bir soruna kapı açıyor.Şimdi “ölü ReLU” sorununu somut bir örnekte yaşayalım — kötü bir başlangıçla bir nöronun ASLA toparlanamadığını görelim:
Ölü ReLU: bir nöron nasıl 'ölür'
# Bir nöronun bias'ı çok NEGATİFSE ve girdiler hep pozitifse, o nöron SÜREKLİ negatif
# bölgede kalabilir -- gradyan HER ZAMAN sıfır olur, nöron ASLA toparlanamaz. Buna "ölü ReLU" denir.
torch.manual_seed(3)
w = torch.tensor(0.3, requires_grad=True)
b = torch.tensor(-5.0, requires_grad=True)  # kötü bir başlangıç: çok negatif bias
x_sabit = torch.tensor(1.0)

z = w * x_sabit + b
h_relu = torch.relu(z)
kayip_relu = (h_relu - 1.0) ** 2
kayip_relu.backward()
print(f"\nÖn-aktivasyon z = {z.item():.3f}  (kalıcı olarak negatif)")
print(f"ReLU(z) = {h_relu.item():.3f}")
print(f"dL/dw = {w.grad.item():.6f}, dL/db = {b.grad.item():.6f}")
print("Gradyan TAM OLARAK sıfır -- gradyan inişi bu ağırlıkları HİÇBİR ZAMAN güncelleyemez. Nöron 'öldü'.")
Ön-aktivasyon z = -4.700  (kalıcı olarak negatif)
ReLU(z) = 0.000
dL/dw = 0.000000, dL/db = 0.000000
Gradyan TAM OLARAK sıfır -- gradyan inişi bu ağırlıkları HİÇBİR ZAMAN güncelleyemez. Nöron 'öldü'.
Gradyan tam olarak sıfır — bu ağırlıklar, kaç tur eğitirsen eğit, ASLA güncellenmeyecek. Şimdi aynı kötü başlangıçla GELU’yu deneyelim:
GELU: ölü nöron tuzağından kaçış
# GELU, x<0 için de TAM SIFIR olmayan, yumuşak bir eğri kullanır -- bu "ölü nöron" tuzağını önler.
w2 = torch.tensor(0.3, requires_grad=True)
b2 = torch.tensor(-5.0, requires_grad=True)
z2 = w2 * x_sabit + b2
h_gelu = F.gelu(z2)
kayip_gelu = (h_gelu - 1.0) ** 2
kayip_gelu.backward()
print(f"\nAYNI kötü başlangıçla GELU: GELU(z) = {h_gelu.item():.6f}")
print(f"dL/dw = {w2.grad.item():.6f}, dL/db = {b2.grad.item():.6f}")
print("Gradyan SIFIR DEĞİL (çok küçük olsa da) -- bu nöron, yeterince eğitimle toparlanabilir.")
AYNI kötü başlangıçla GELU: GELU(z) = -0.000006
dL/dw = 0.000057, dL/db = 0.000057
Gradyan SIFIR DEĞİL (çok küçük olsa da) -- bu nöron, yeterince eğitimle toparlanabilir.
Gradyan sıfır DEĞİL (çok küçük olsa da, 0.000057)! Çoğu kişi “ReLU’nun negatif bölgede sıfır olması, gereksiz hesaplamayı önlediği için bir avantaj” sanır. Kısmen doğru, ama bu derste gördüğümüz gibi aynı özellik, bir nöronun KALICI olarak “ölmesine” de yol açabiliyor — GELU, negatif bölgede tam sıfıra inmeyerek bu riski azaltıyor.
Matematik
ReLU ve GELU formülleri
| Fonksiyon | Negatif bölgede davranış | Pozitif bölgede davranış |
|---|---|---|
| ReLU | Tam olarak 0 (ve türevi tam olarak 0) | Kimlik fonksiyonu (türevi tam olarak 1) |
| GELU | Sıfıra yaklaşır ama TAM sıfır olmaz (türevi de küçük ama sıfır değil) | ReLU’ya çok benzer |
GELU’nun formülü karmaşık görünüyor ama sezgisi basit: “girdi ne kadar pozitifse, o kadar geçir; ne kadar negatifse, o kadar bastır — ama HİÇBİR ZAMAN tamamen kapatma.”
Kod
GELU’nun negatif bölgedeki davranışını sayısal olarak görelim:
ReLU vs GELU değerleri
def gelu_yaklasik(x):
    return 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))

print(f"\n{'x':>6} {'ReLU(x)':>10} {'GELU(x)':>10}")
for x in x_degerleri:
    print(f"{x:>6} {relu(x):>10.3f} {gelu_yaklasik(x):>10.3f}")
print("GELU, negatif bölgede TAM SIFIRA inmez, pozitif bölgede ise ReLU'ya çok benzer davranır.")
     x    ReLU(x)    GELU(x)
  -5.0      0.000     -0.000
  -2.0      0.000     -0.045
  -0.5      0.000     -0.154
   0.5      0.500      0.346
   2.0      2.000      1.955
   5.0      5.000      5.000
GELU, negatif bölgede TAM SIFIRA inmez, pozitif bölgede ise ReLU'ya çok benzer davranır.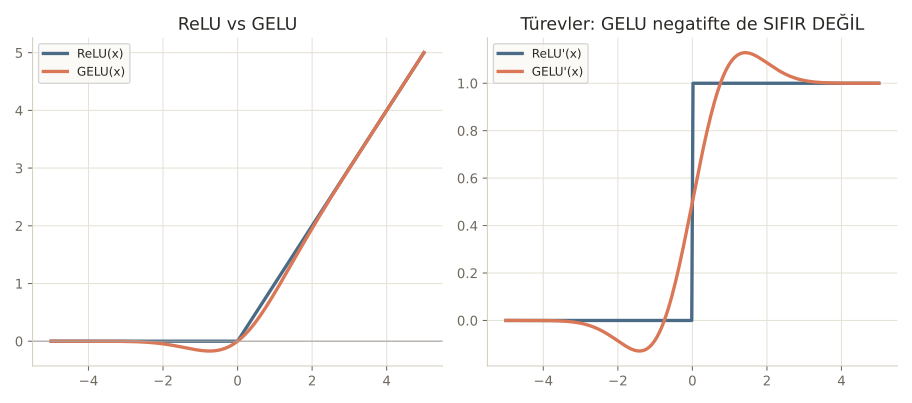
Nerede işe yarar
ReLU ve GELU, günümüz derin öğrenmesinin en yaygın aktivasyon fonksiyonlarıdır:
- ReLU, CNN’lerde (bir sonraki bölüm) hâlâ çok yaygın. Hesaplama açısından ucuz ve çoğu durumda iyi çalışıyor.
- GELU, transformer tabanlı modellerde (NLP kategorisinde göreceğiz, GPT/BERT gibi) standart hale geldi. Ölü nöron riskini azaltması, çok büyük modellerde önemli bir avantaj.
- “Sızıntılı ReLU” (Leaky ReLU) gibi varyantlar. ReLU’nun ölü nöron sorununu farklı bir şekilde (negatifte küçük bir eğim bırakarak) çözmeye çalışan başka yaklaşımlar da var.
Bu 3 hatayı yaparsın:
- Çok negatif bias başlangıç değerleri kullanmak — bu derste gördüğümüz gibi, bir nöronu doğrudan “ölü” bölgeye doğduğunda başlatabilir.
- Öğrenme oranını çok yüksek tutup nöronları “öldürmek” — büyük bir güncelleme adımı, bir nöronu aniden kalıcı negatif bölgeye itebilir.
- ReLU’nun her zaman GELU’dan daha basit/hızlı olduğu için “yeterli” olduğunu düşünmek — büyük, derin modellerde ölü nöron birikimi ciddi bir kapasite kaybına yol açabilir.
Kendini test et
1. 'Ölü ReLU' (dying ReLU) problemi tam olarak nedir?
- ReLU fonksiyonunun hiç çalışmaması
- Bir nöronun ön-aktivasyonu sürekli negatif kaldığında, gradyanının TAM SIFIR olması ve bu nöronun gradyan inişiyle ASLA güncellenememesi (doğru cevap)
- ReLU'nun çok yavaş çalışması
- Modelin aşırı öğrenmesi
Neden: ReLU'nun negatif bölgedeki türevi tam olarak sıfırdır; bir nöron kalıcı olarak bu bölgeye düşerse, gradyanı hep sıfır kalır ve ağırlıkları asla güncellenmez -- nöron 'ölür'.
2. Notebook'ta aynı kötü başlangıçla GELU'nun gradyanı neden sıfır DEĞİLDİ (0.000057)?
- Kod hatalıydı
- GELU, negatif bölgede TAM sıfıra inmeyen, yumuşak bir eğri kullanıyor -- bu yüzden türevi de negatif bölgede küçük ama sıfırdan FARKLI kalıyor (doğru cevap)
- GELU rastgele sayılar üretiyor
- GELU sadece pozitif girdilerde çalışır
Neden: GELU'nun negatif bölgedeki davranışı ReLU gibi tam düz-sıfır değil, yumuşak bir eğridir; bu yüzden türevi de o bölgede küçük olsa da sıfırdan farklı kalır, nöronun toparlanmasına izin verir.
3. GELU'nun transformer tabanlı modellerde (GPT, BERT gibi) tercih edilmesinin ana nedeni nedir?
- GELU her zaman daha hızlı hesaplanır
- Büyük, derin modellerde ölü nöron riskini azaltarak, ağın kapasitesinin gereksiz yere kaybedilmesini önler (doğru cevap)
- GELU sadece metin verisinde çalışır
- GELU'nun hiçbir dezavantajı yoktur
Neden: Çok büyük ve derin modellerde, ReLU'nun ölü nöron sorunu birikerek modelin etkin kapasitesini azaltabilir; GELU'nun negatifte tam sıfıra inmemesi bu riski azaltır.
Özet
Özet
- ReLU, negatif girdileri sıfıra kırpar, pozitif girdileri olduğu gibi geçirir -- pozitif bölgede doygunluk yoktur.
- ReLU'nun negatif bölgedeki türevi tam olarak sıfırdır -- bir nöron kalıcı olarak buraya düşerse "ölür".
- GELU, negatif bölgede tam sıfıra inmeyen yumuşak bir eğri kullanarak bu riski azaltır.
- Ölü ReLU, kötü ağırlık ilklendirme veya çok büyük öğrenme oranı gibi nedenlerle ortaya çıkabilir.
- GELU, özellikle büyük transformer tabanlı modellerde ReLU'ya tercih edilen standart hale gelmiştir.